

Vous avez activé l'autoscaling Databricks pour ne plus payer des workers que vous n'utilisez pas. Mais quand un job se termine, le cluster ne réduit pas sa taille tout de suite. Il conserve d'abord ses workers pendant une fenêtre définie : 40 secondes sur le compute de jobs et 150 secondes sur le compute all-purpose.
Le paramètre qui contrôle ce comportement, spark.databricks.aggressiveWindowDownS, n'est documenté que pour allonger cette attente. Si vous voulez libérer les workers plus tôt, c'est à vous de redimensionner le cluster. Réduire le compute inactif est l'une des cinq habitudes qui influent sur une facture Databricks, et l'autoscaling est l'une des couches du framework complet d'optimisation des coûts.
TL;DR
- Databricks propose trois fonctionnalités appelées autoscaling : une pour les clusters classiques, une pour les pipelines Lakeflow et une pour Lakebase. Cet article traite de la première, qui s'applique aux clusters de jobs et all-purpose.
- Un cluster de jobs scale up en fonction des tâches en attente par rapport aux task slots disponibles ; les graphiques CPU seuls ne vous diront donc pas quand il va grossir.
- Il scale down après 40 secondes de sous-utilisation sur le compute de jobs et 150 secondes sur le compute all-purpose.
- Le paramètre du timer,
spark.databricks.aggressiveWindowDownS, n'est documenté que pour ralentir le scale-down. - Pour modifier le nombre de workers d'un cluster en cours d'exécution, utilisez
databricks clusters resize.databricks clusters editredémarre le cluster.
De quel autoscaling Databricks parle-t-on, au juste ?
Databricks utilise le nom autoscaling pour trois fonctionnalités distinctes, chacune sur un type de compute différent. Avant de régler quoi que ce soit, vérifiez laquelle vous concerne.
Les trois types d'autoscaling Databricks
- L'autoscaling du compute classique s'applique aux clusters de jobs et all-purpose. Il fait varier le nombre de workers entre un minimum et un maximum que vous définissez, en fonction des tâches en attente et des task slots disponibles.
- L'autoscaling amélioré (enhanced autoscaling) s'applique aux pipelines Lakeflow et se base sur l'utilisation des task slots et la taille de la file d'attente des tâches.
- L'autoscaling Lakebase redimensionne un compute Postgres dans une plage de Compute Units (CU) que vous définissez, en fonction de la charge CPU, de l'utilisation mémoire et de la taille du working set. Il dispose aussi d'une fonctionnalité distincte de scale to zero qui suspend un compute inactif.
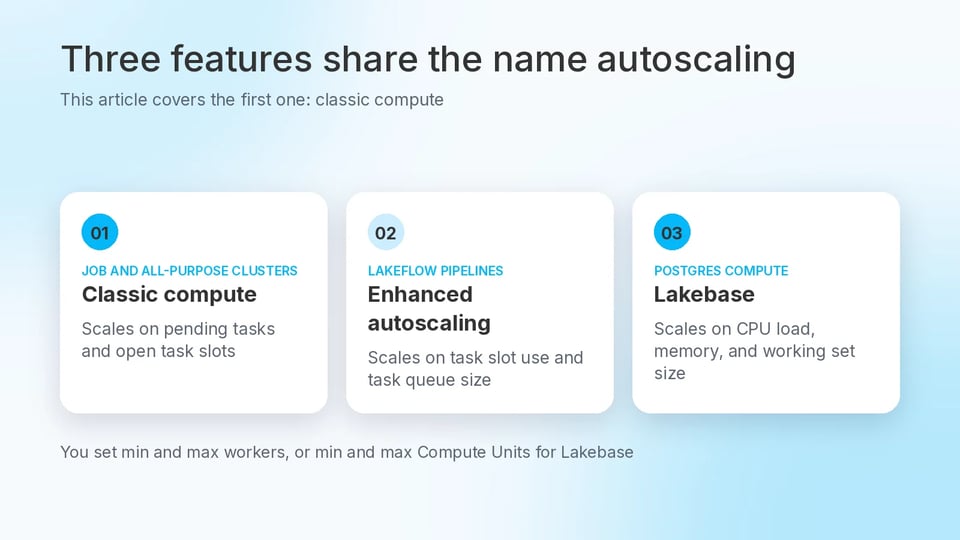
Trois fonctionnalités Databricks portent le nom d'autoscaling. Cet article traite de la première.
Cet article porte sur l'autoscaling des clusters sur le compute classique. Si vous dimensionnez une base Postgres, lisez notre guide Lakebase.
Comment l'autoscaling classique décide-t-il de scale up ?
Un cluster de jobs ajoute des workers lorsque Spark a plus de tâches en attente que de task slots pour les exécuter. L'autoscaling se base sur les signaux du scheduler Spark, le pourcentage de CPU seul ne vous dira donc pas quand un cluster est sur le point de grossir.
Les clusters all-purpose utilisent le même autoscaler. À partir du plan Premium, tous les types de clusters utilisent l'autoscaling optimisé par défaut, et il peut passer du minimum au maximum en deux événements de scaling au plus. Les workspaces en plan Standard utilisent l'autoscaling standard, qui commence par ajouter huit nœuds puis scale up de façon exponentielle.
Deux limites à connaître avant de vous y fier. L'autoscaling n'est pas disponible pour les jobs spark-submit. Et un cluster peut descendre sous votre minimum lorsque le fournisseur cloud met fin à des instances ; Databricks réessaie alors jusqu'à rétablir le minimum.
Tout ce qui suit décrit l'autoscaling optimisé sur AWS et Azure.
Voici la spécification de base du cluster, avec une plage d'autoscaling de 2 à 10 workers. Remplacez les deux placeholders en majuscules par une version de runtime et un type de nœud de votre propre workspace.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }}Le nombre de workers n'est qu'une partie du coût d'un cluster. Le tarif facturé pour chaque worker compte aussi. Sur les clusters classiques, le compute avec Photon consomme des Databricks Units (DBU) à un tarif plus élevé que le compute équivalent sans Photon, et le calcul des DBU de Photon montre quand cela devient rentable.
Pourquoi Databricks attend-il avant de libérer les workers inactifs ?
Databricks attend parce que le scale-down fonctionne sur une fenêtre. Un cluster de jobs scale down après 40 secondes de sous-utilisation, et un cluster all-purpose après 150 secondes. Un cluster all-purpose qui conserve sa taille pendant deux minutes après la fin d'un job se comporte donc normalement.
Une propriété de configuration Spark, spark.databricks.aggressiveWindowDownS, définit en secondes la fréquence à laquelle le cluster prend ses décisions de scale-down. Vous la définissez dans la config Spark du cluster, et le maximum est 600.
Le scale-down n'exige pas que tout le cluster soit à l'arrêt. L'autoscaling optimisé peut retirer des workers alors que le cluster est encore occupé en vérifiant l'état des fichiers de shuffle, et l'ampleur du scale-down dépend d'un pourcentage des nœuds actuels. Le streaming est un cas à part. L'autoscaling a des limites pour le scale-down des workloads Structured Streaming, et Databricks recommande pour ceux-ci des pipelines avec autoscaling amélioré.
La fenêtre aide les workloads en rafale. Une valeur plus élevée conserve les nœuds plus longtemps, pendant les courtes pauses entre les étapes.
Augmenter la valeur ralentit le scale-down du cluster. Les valeurs plus basses ne sont pas documentées, ne bâtissez donc pas un plan de coûts dessus.
Voici la spécification de base avec la propriété réglée à 300 secondes, pour un workload en rafale.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }, "spark_conf": { "spark.databricks.aggressiveWindowDownS": "300" }}La valeur par défaut convient-elle à une équipe responsable de la facture ? Nous pensons que oui. Une valeur plus élevée laisse les workers inactifs tourner plus longtemps, et vous les payez pendant ce temps. Nous ne l'augmenterions que pour un workload en rafale, afin de conserver les workers pendant les courtes pauses entre les étapes.
L'autoscaling n'est qu'un réglage parmi d'autres. Téléchargez notre ebook gratuit, The Guide to Databricks Cost Optimization, pour découvrir cinq stratégies clés et un arbre de décision qui relie votre problème de coûts à la bonne solution.
Comment redimensionner un cluster en cours d'exécution pour libérer des workers ?
Utilisez databricks clusters resize, la commande de l'interface en ligne de commande (CLI) Databricks qui modifie le nombre de workers d'un cluster en cours d'exécution. Réglez le cluster à son minimum, puis redéfinissez la plage d'autoscaling quand le travail reprend.
# Fixer un nombre de workers à 2databricks clusters resize YOUR_CLUSTER_ID --num-workers 2# Redéfinir la plage d'autoscalingdatabricks clusters resize --json '{ "cluster_id": "YOUR_CLUSTER_ID", "autoscale": { "min_workers": 2, "max_workers": 10 }}'La première commande redimensionne le cluster à un nombre fixe de workers, et elle ne fonctionne que lorsque le cluster est en cours d'exécution. La seconde redéfinit la plage d'autoscaling. Elle passe l'ID du cluster dans le JSON, car la CLI n'accepte pas d'argument positionnel avec --json.
Il faut deux commandes parce qu'une plage d'autoscaling ne peut pas être un nombre unique. Dans l'API Clusters, max_workers doit être strictement supérieur à min_workers : vous fixez donc un nombre de 2 workers, puis vous redéfinissez la plage plus tard.
N'utilisez pas databricks clusters edit ici. Modifier un cluster en cours d'exécution le redémarre, et les clusters créés par le service Jobs ne peuvent pas du tout être modifiés.
Essayez d'abord sur un cluster hors production. Les bons moments sont ceux où vous savez qu'aucun travail n'arrive, comme la fin d'une fenêtre de batch ou le début d'un gel de maintenance.
Évitez cette approche sur les clusters all-purpose interrogés tout au long de la journée. Impossible d'y prédire la prochaine requête : la fenêtre de 150 secondes reste alors le meilleur garde-fou.
Si descendre au minimum est sans risque à la fin de chaque fenêtre de batch, pourquoi quelqu'un de votre équipe le fait-il encore à la main ? Nous pensons que ce ne devrait pas être le cas. Une étape sûre à chaque fois, mais qui n'a lieu que si quelqu'un y pense, mérite d'être automatisée.
Que se passe-t-il quand de nouveaux travaux arrivent ?
Quand le travail reprend, le cluster a de nouveau besoin de workers, et le provisionnement de nouveaux nœuds prend du temps. Après un redimensionnement de 5 à 10 workers, par exemple, la taille cible est mise à jour immédiatement tandis que les workers augmentent progressivement à mesure que les nœuds démarrent.
Un pool d'instances raccourcit cette attente en gardant des instances inactives prêtes, mais seulement si le pool est assez grand. Si le cluster demande plus que le nombre minimum d'instances inactives du pool, il ne démarre pas plus vite qu'un cluster sans pool.
Les instances inactives du pool pèsent tout de même sur vos coûts. Régler Min Idle instances à 0 évite de payer des instances qui ne travaillent pas, et le délai d'Idle Instance Auto Termination contrôle combien de temps une instance libérée reste dans le pool avant d'en être retirée.
Quel anti-pattern casse tout cela ?
L'anti-pattern consiste à activer la Dynamic Allocation d'Apache Spark (spark.dynamicAllocation.enabled) sur un cluster qui utilise déjà l'autoscaling Databricks.
L'autoscaling Databricks gère déjà les nœuds workers et le cycle de vie des executors au niveau de la plateforme ; activer la Dynamic Allocation revient donc à laisser deux systèmes prendre la même décision. Cela peut provoquer des décisions de scaling contradictoires, du churn d'executors, des erreurs NODES_LOST et des tâches jamais prises en charge.
Si vous observez l'un de ces symptômes sur un cluster avec autoscaling, vérifiez d'abord ce paramètre. Retirez-le de la config Spark du cluster, et vérifiez aussi vos compute policies, car les admins de workspace peuvent s'en servir pour imposer des configurations Spark.
L'autoscaling modifie le nombre de workers. Arrêter un cluster inactif est un autre sujet, et l'auto termination est un contrôle distinct.
Que coûte le travail manuel, et qu'automatise SELECT ?
Tout ce qui précède, c'est du temps d'ingénierie. Vous lisez une spécification de cluster, définissez une config Spark, lancez un resize à la fin de la fenêtre de batch, puis un autre quand le travail reprend. Et vous recommencez pour le cluster suivant. Les paramètres d'autoscaling ne sont d'ailleurs qu'un des choix de cluster qui façonnent votre facture, avec la taille du cluster, le type d'instance et l'usage des instances Spot. Nous classons l'autoscaling dans le palier des gains faciles du travail sur les coûts Databricks.
C'est précisément pour prendre en charge ce travail que nous avons conçu Automated Savings. Automated Savings for Databricks de SELECT ajuste automatiquement le nombre de workers et le comportement d'autoscaling pour réduire les coûts des SQL warehouses et de l'All Purpose Compute. Nous constatons jusqu'à 30 % d'économies sur les workloads éligibles, sans effort d'ingénierie continu. Le chapitre Optimize de notre ebook approfondit cette couche.
Exécuter ces étapes à la main est-il un compromis défendable, ou un coût qui s'accumule à mesure que vos clusters et vos plannings se multiplient ? À vous de trancher. Notre avis : pour un ou deux clusters sur un planning fixe, le faire à la main est un compromis raisonnable. Au-delà, chaque nouveau cluster ajoute un resize que quelqu'un doit penser à lancer, et c'est ce coût-là qui s'accumule.
Pour évaluer votre propre potentiel d'économies, réservez une démo ou démarrez un essai gratuit.