

Ha attivato l'autoscaling di Databricks per smettere di pagare worker che non utilizza. Ma quando un job termina, il cluster non si riduce subito: mantiene i suoi worker per una finestra prestabilita, che è di 40 secondi sul job compute e di 150 secondi sul compute all-purpose.
L'impostazione che la controlla, spark.databricks.aggressiveWindowDownS, è documentata solo per allungare quell'attesa. Se vuole che i worker vengano rilasciati prima, deve ridimensionare il cluster manualmente. Eliminare il compute inattivo è una delle cinque abitudini che incidono su una fattura Databricks, e l'autoscaling è uno dei livelli del framework completo di ottimizzazione dei costi.
TL;DR
- Databricks ha tre funzionalità chiamate autoscaling: una per i cluster classici, una per le pipeline Lakeflow e una per Lakebase. Questo articolo tratta la prima, che opera sui cluster job e all-purpose.
- Un job cluster effettua lo scale-up in base ai task in attesa rispetto ai task slot disponibili, quindi i soli grafici della CPU non le diranno quando crescerà.
- Effettua lo scale-down dopo 40 secondi di sottoutilizzo sul job compute e 150 secondi sul compute all-purpose.
- L'impostazione del timer,
spark.databricks.aggressiveWindowDownS, è documentata solo per rallentare lo scale-down. - Per modificare il numero di worker su un cluster in esecuzione, usi
databricks clusters resize.databricks clusters editriavvia il cluster.
Di quale "autoscaling di Databricks" stiamo parlando?
Databricks usa il nome autoscaling per tre funzionalità distinte, ciascuna su un tipo diverso di compute. Prima di mettere mano alle impostazioni, verifichi quale delle tre sta usando.
Le tre tipologie di autoscaling di Databricks
- L'autoscaling del compute classico opera sui cluster job e all-purpose. Regola il numero di worker tra un minimo e un massimo da lei definiti, in base ai task in attesa e ai task slot disponibili.
- L'enhanced autoscaling opera sulle pipeline Lakeflow e scala in base all'utilizzo dei task slot e alla dimensione della coda dei task.
- L'autoscaling di Lakebase ridimensiona un compute Postgres all'interno di un intervallo di Compute Unit (CU) da lei definito, in base al carico CPU, all'uso della memoria e alla dimensione del working set. Ha anche una funzionalità separata di scale to zero che sospende un compute inattivo.
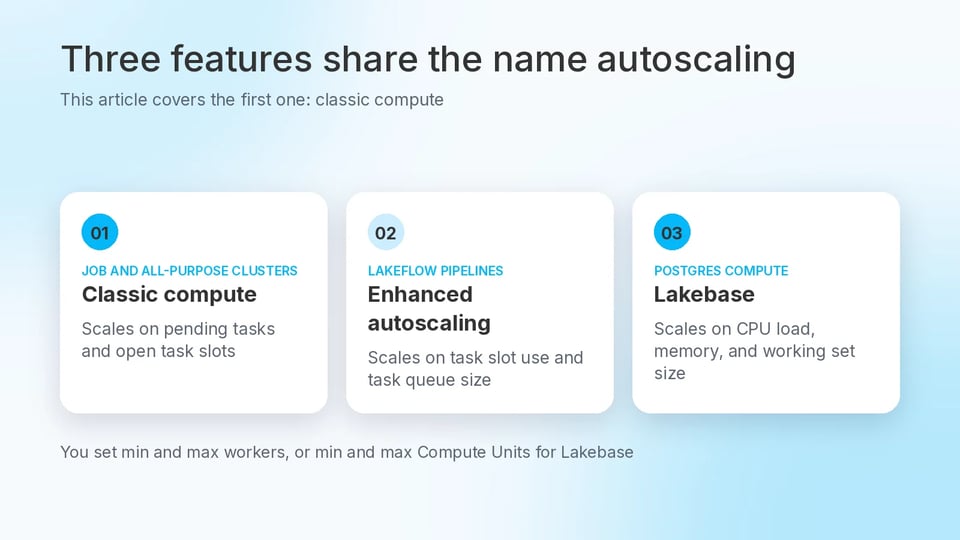
Tre funzionalità di Databricks condividono il nome autoscaling. Questo articolo tratta la prima.
Questo articolo tratta l'autoscaling dei cluster sul compute classico. Se sta dimensionando un database Postgres, legga la nostra guida a Lakebase.
Come decide l'autoscaling classico di fare scale-up?
Un job cluster aggiunge worker quando Spark ha più task in attesa che task slot per eseguirli. L'autoscaling decide in base ai segnali dello scheduler di Spark, quindi la sola percentuale di CPU non le dirà quando un cluster sta per crescere.
I cluster all-purpose usano lo stesso autoscaler. Dal piano Premium in su, ogni tipo di cluster usa l'optimized autoscaling per impostazione predefinita, e può passare dal minimo al massimo in non più di due eventi di scaling. I workspace con piano Standard usano lo standard autoscaling, che inizia aggiungendo otto nodi e poi scala in modo esponenziale.
Due limiti da conoscere prima di farci affidamento. L'autoscaling non è disponibile per i job spark-submit. E un cluster può scendere sotto il minimo quando il cloud provider termina le istanze: in quel caso Databricks continua a riprovare finché il minimo non viene ripristinato.
Tutto quanto segue descrive l'optimized autoscaling su AWS e Azure.
Ecco la specifica di base del cluster, con un intervallo di autoscaling da 2 a 10 worker. Sostituisca i due segnaposto in maiuscolo con una versione del runtime e un tipo di nodo del suo workspace.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }}Il numero di worker è solo una parte del costo di un cluster. Conta anche la tariffa a cui ogni worker viene fatturato. Sui cluster classici, il compute con Photon abilitato consuma Databricks Unit (DBU) a una tariffa più alta rispetto al compute equivalente senza Photon, e il calcolo delle DBU di Photon mostra quando l'investimento si ripaga.
Perché Databricks aspetta prima di rilasciare i worker inattivi?
Databricks aspetta perché lo scale-down si basa su una finestra temporale. Un job cluster viene ridotto dopo essere stato sottoutilizzato per 40 secondi, un cluster all-purpose dopo 150 secondi. Quindi un cluster all-purpose che mantiene le sue dimensioni per un paio di minuti dopo la fine di un job si sta comportando normalmente.
Una proprietà di configurazione di Spark, spark.databricks.aggressiveWindowDownS, imposta in secondi la frequenza con cui il cluster prende decisioni di scale-down. Si imposta nella configurazione Spark del cluster, e il massimo è 600.
Lo scale-down non richiede che l'intero cluster sia fermo. L'optimized autoscaling può rimuovere worker mentre il cluster è ancora occupato, controllando lo stato dei file di shuffle, e la misura dello scale-down si basa su una percentuale dei nodi correnti. Lo streaming è un caso a parte. L'autoscaling ha dei limiti nello scale-down dei workloads di Structured Streaming, e per questi Databricks raccomanda le pipeline con enhanced autoscaling.
La finestra aiuta i workloads con picchi intermittenti. Un valore più alto mantiene i nodi più a lungo, attraverso le brevi pause tra uno stage e l'altro.
Aumentando il valore, il cluster effettua lo scale-down più lentamente. I valori più bassi non sono documentati, quindi non costruisca un piano di risparmio su uno di essi.
Ecco la specifica di base con la proprietà impostata a 300 secondi, per un workload con picchi.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }, "spark_conf": { "spark.databricks.aggressiveWindowDownS": "300" }}Il valore predefinito va bene per un team che risponde della fattura? Secondo noi sì. Un valore più alto mantiene i worker inattivi in esecuzione più a lungo, e lei li paga finché sono in esecuzione. Lo alzeremmo solo per un workload con picchi intermittenti, per mantenere i worker durante le brevi pause tra gli stage.
L'autoscaling è solo una delle tante impostazioni. Scarichi il nostro ebook gratuito, The Guide to Databricks Cost Optimization, per cinque strategie fondamentali e un albero decisionale che collega il suo specifico problema di costi alla soluzione giusta.
Come si ridimensiona un cluster in esecuzione per rilasciare i worker?
Usi databricks clusters resize, il comando della CLI (command-line interface) di Databricks per modificare il numero di worker su un cluster in esecuzione. Imposti il cluster al suo minimo, poi reimposti l'intervallo di autoscale quando il lavoro riprende.
# Set a fixed worker count of 2databricks clusters resize YOUR_CLUSTER_ID --num-workers 2# Set the autoscale range againdatabricks clusters resize --json '{ "cluster_id": "YOUR_CLUSTER_ID", "autoscale": { "min_workers": 2, "max_workers": 10 }}'Il primo comando ridimensiona il cluster a un numero fisso di worker e funziona solo mentre il cluster è in esecuzione. Il secondo reimposta l'intervallo di autoscale. Passa l'ID del cluster all'interno del JSON perché la CLI non accetta un argomento posizionale insieme a --json.
Servono due comandi perché un intervallo di autoscale non può essere un numero singolo. Nella Clusters API, max_workers deve essere strettamente maggiore di min_workers, quindi si imposta un numero fisso di 2 e si reimposta l'intervallo in un secondo momento.
Non usi databricks clusters edit in questo caso. Modificare un cluster in esecuzione lo riavvia, e i cluster creati dal servizio Jobs non possono essere modificati affatto.
Faccia prima una prova su un cluster non di produzione. I momenti giusti per usarlo sono quelli in cui sa che non arriverà altro lavoro, come la fine di una finestra batch o l'inizio di un freeze di manutenzione.
Lo eviti sui cluster all-purpose su cui le persone eseguono query nel corso della giornata. Lì non può prevedere la prossima richiesta, quindi la finestra di 150 secondi è la protezione migliore.
Se scendere al minimo è sicuro alla fine di ogni finestra batch, perché qualcuno nel suo team lo sta ancora facendo a mano? Secondo noi, non dovrebbe. Un passaggio che è sicuro ogni volta, e che avviene solo quando qualcuno se ne ricorda, è un passaggio da automatizzare.
Cosa succede quando arriva nuovo lavoro?
Quando il lavoro riprende, il cluster ha di nuovo bisogno di worker, e il provisioning dei nuovi nodi richiede tempo. Dopo un resize da 5 a 10 worker, per esempio, la dimensione target si aggiorna subito mentre i worker aumentano gradualmente man mano che i nodi diventano disponibili.
Un instance pool accorcia quell'attesa mantenendo pronte istanze inattive, ma solo se il pool è abbastanza grande. Se il cluster richiede più del numero minimo di istanze inattive del pool, non si avvia più velocemente di un cluster senza pool.
Le istanze inattive del pool continuano comunque a pesare sui costi. Impostare Min Idle instances a 0 evita di pagare istanze che non stanno lavorando, e il tempo di Idle Instance Auto Termination controlla per quanto un'istanza rilasciata resta nel pool prima di essere eliminata.
Quale anti-pattern manda all'aria tutto questo?
L'anti-pattern è abilitare la Dynamic Allocation di Apache Spark (spark.dynamicAllocation.enabled) su un cluster che usa già l'autoscaling di Databricks.
L'autoscaling di Databricks gestisce già i nodi worker e il ciclo di vita degli executor a livello di piattaforma, quindi attivare la Dynamic Allocation significa avere due sistemi che prendono la stessa decisione. Questo può portare a decisioni di scaling in conflitto, churn degli executor, errori NODES_LOST e task che non vengono mai presi in carico.
Se nota uno di questi sintomi su un cluster con autoscaling, controlli prima quell'impostazione. La rimuova dalla configurazione Spark del cluster, e verifichi anche le compute policy, dato che gli amministratori del workspace possono usarle per imporre configurazioni Spark.
L'autoscaling modifica il numero di worker. Spegnere un cluster inattivo è un lavoro diverso, e l'auto termination è un controllo separato.
Quanto costa farlo a mano, e cosa automatizza SELECT?
Tutto quanto descritto sopra è tempo di engineering. Si legge una specifica del cluster, si imposta una configurazione Spark, si esegue un resize alla fine della finestra batch e se ne esegue un altro quando il lavoro riprende. Poi si ricomincia con il cluster successivo. E i parametri di autoscaling sono solo una delle scelte di cluster che determinano la sua fattura, accanto alla dimensione del cluster, al tipo di istanza e all'uso delle istanze spot. Noi collochiamo l'autoscaling nella fascia degli interventi più semplici del lavoro sui costi Databricks.
È proprio per questo lavoro che abbiamo creato Automated Savings. Automated Savings per Databricks di SELECT regola automaticamente il numero di worker e il comportamento di auto-scaling per ridurre i costi su SQL warehouse e All-Purpose Compute. Registriamo risparmi fino al 30% sui workloads idonei, senza alcun impegno continuativo di engineering. Il capitolo Optimize del nostro ebook approfondisce questo livello.
Eseguire questi passaggi a mano è un compromesso difendibile, o un costo che si accumula man mano che cluster e pianificazioni si moltiplicano? La decisione spetta a lei. Il nostro punto di vista: per uno o due cluster con una pianificazione fissa, farlo a mano è un compromesso accettabile. Oltre quella soglia, ogni nuovo cluster aggiunge un altro resize che qualcuno deve ricordarsi di eseguire, ed è quello il costo che si accumula.
Per scoprire il suo potenziale di risparmio, prenoti una demo o inizi una prova gratuita.