

Activaste el autoscaling de Databricks para dejar de pagar por workers que no usas. Pero cuando un job termina, el clúster no se reduce de inmediato. Primero conserva sus workers durante una ventana fija: 40 segundos en el compute de jobs y 150 segundos en el compute all-purpose.
La configuración que lo controla, spark.databricks.aggressiveWindowDownS, solo está documentada para alargar esa espera. Si quieres que los workers desaparezcan antes, tienes que redimensionar el clúster tú mismo. Recortar el compute inactivo es uno de los cinco hábitos que impactan la factura de Databricks, y el autoscaling es una capa dentro de el marco completo de optimización de costos.
TL;DR
- Databricks tiene tres funciones llamadas autoscaling: una para clústeres clásicos, una para pipelines de Lakeflow y una para Lakebase. Este artículo cubre la primera, que funciona en clústeres de jobs y all-purpose.
- Un clúster de jobs agrega workers según las tareas pendientes frente a los task slots disponibles, así que las gráficas de CPU por sí solas no te dirán cuándo va a crecer.
- Se reduce tras 40 segundos de baja utilización en el compute de jobs y 150 segundos en el compute all-purpose.
- La configuración del temporizador,
spark.databricks.aggressiveWindowDownS, está documentada solo para ralentizar la reducción. - Para cambiar el número de workers en un clúster en ejecución, usa
databricks clusters resize.databricks clusters editreinicia el clúster.
¿A cuál "autoscaling de Databricks" te refieres exactamente?
Databricks usa el nombre autoscaling para tres funciones distintas, cada una en un tipo de compute diferente. Antes de ajustar nada, verifica cuál es la que tienes.
Los tres tipos de autoscaling en Databricks
- El autoscaling de compute clásico funciona en clústeres de jobs y all-purpose. Mueve el número de workers entre un mínimo y un máximo que tú defines, según las tareas pendientes y los task slots disponibles.
- El enhanced autoscaling funciona en pipelines de Lakeflow y escala según la utilización de task slots y el tamaño de la cola de tareas.
- El autoscaling de Lakebase redimensiona un compute de Postgres dentro de un rango de Compute Units (CU) que tú defines, según la carga de CPU, el uso de memoria y el tamaño del working set. También tiene una función aparte de scale to zero que suspende un compute inactivo.
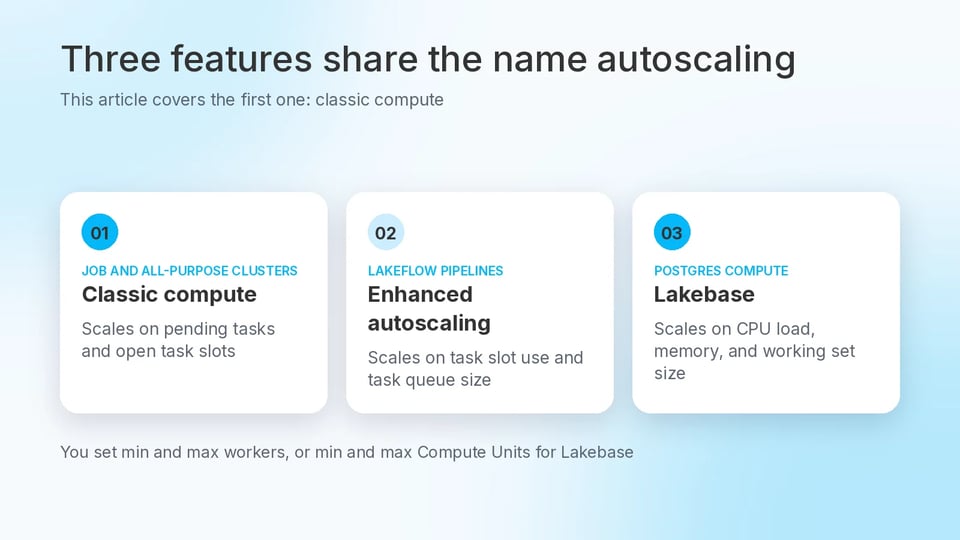
Tres funciones de Databricks comparten el nombre autoscaling. Este artículo cubre la primera.
Este artículo cubre el autoscaling de clústeres en compute clásico. Si estás dimensionando una base de datos Postgres, lee nuestra guía de Lakebase.
¿Cómo decide el autoscaling clásico cuándo agregar workers?
Un clúster de jobs agrega workers cuando Spark tiene más tareas pendientes que task slots para ejecutarlas. El autoscaling decide a partir de las señales del scheduler de Spark, así que el porcentaje de CPU por sí solo no te dirá cuándo un clúster está a punto de crecer.
Los clústeres all-purpose usan el mismo autoscaler. En el plan Premium o superior, todos los tipos de clúster usan autoscaling optimizado por defecto, y puede pasar del mínimo al máximo en, como mucho, dos eventos de escalado. Los workspaces del plan Standard usan autoscaling estándar, que empieza agregando ocho nodos y luego escala exponencialmente.
Hay dos límites que debes conocer antes de confiar en él. El autoscaling no está disponible para jobs de spark-submit. Y un clúster puede caer por debajo de tu mínimo cuando el proveedor de nube da de baja instancias, en cuyo caso Databricks sigue reintentando hasta restaurar el mínimo.
Todo lo que sigue describe el autoscaling optimizado en AWS y Azure.
Aquí tienes la especificación base del clúster, con un rango de autoscaling de 2 a 10 workers. Reemplaza los dos placeholders en mayúsculas por una versión de runtime y un tipo de nodo de tu propio workspace.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }}El número de workers es solo una parte de lo que cuesta un clúster. El precio al que se factura cada worker también cuenta. En clústeres clásicos, el compute con Photon habilitado consume Databricks Units (DBUs) a un ritmo mayor que el compute equivalente sin Photon, y el cálculo de DBUs de Photon muestra cuándo vale la pena.
¿Por qué Databricks espera antes de soltar los workers inactivos?
Databricks espera porque la reducción funciona con una ventana. Un clúster de jobs se reducirá una vez que haya estado subutilizado durante 40 segundos, y un clúster all-purpose tras 150 segundos. Así que un clúster all-purpose que mantiene su tamaño un par de minutos después de que termina un job se está comportando con normalidad.
Una propiedad de configuración de Spark, spark.databricks.aggressiveWindowDownS, define en segundos con qué frecuencia el clúster toma decisiones de reducción. Se configura en la Spark config del clúster, y el máximo es 600.
La reducción no necesita que todo el clúster quede inactivo. El autoscaling optimizado puede quitar workers mientras el clúster sigue ocupado, al revisar el estado de los archivos de shuffle, y cuánto se reducirá depende de un porcentaje de los nodos actuales. El streaming es distinto. El autoscaling tiene limitaciones al reducir workloads de Structured Streaming, y Databricks recomienda pipelines con enhanced autoscaling para esos casos.
La ventana ayuda a los workloads con picos. Un valor más alto retiene los nodos por más tiempo, durante las pausas breves de inactividad entre etapas.
Aumentar el valor hace que el clúster se reduzca más lentamente. Los valores más bajos no están documentados, así que no construyas un plan de costos sobre uno de ellos.
Aquí tienes la especificación base con la propiedad configurada en 300 segundos, para un workload con picos.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }, "spark_conf": { "spark.databricks.aggressiveWindowDownS": "300" }}¿El valor por defecto le conviene a un equipo que responde por la factura? Creemos que sí. Un valor más alto mantiene los workers inactivos corriendo más tiempo, y los pagas mientras corren. Solo lo subiríamos para un workload con picos, para conservar los workers durante las pausas breves entre etapas.
El autoscaling es un ajuste entre muchos. Descarga nuestro ebook gratuito, The Guide to Databricks Cost Optimization, con cinco estrategias clave y un árbol de decisión que conecta tu problema de costos específico con la solución correcta.
¿Cómo redimensionar un clúster en ejecución para liberar workers?
Usa databricks clusters resize, el comando de la interfaz de línea de comandos (CLI) de Databricks para cambiar el número de workers en un clúster en ejecución. Fija el clúster en su mínimo y luego vuelve a configurar el rango de autoscale cuando el trabajo se reanude.
# Set a fixed worker count of 2databricks clusters resize YOUR_CLUSTER_ID --num-workers 2# Set the autoscale range againdatabricks clusters resize --json '{ "cluster_id": "YOUR_CLUSTER_ID", "autoscale": { "min_workers": 2, "max_workers": 10 }}'El primer comando redimensiona el clúster a un número fijo de workers, y solo funciona mientras el clúster está en ejecución. El segundo vuelve a configurar el rango de autoscale. Pasa el ID del clúster dentro del JSON porque la CLI no acepta un argumento posicional junto con --json.
Se necesitan dos comandos porque un rango de autoscale no puede ser un solo número. En la Clusters API, max_workers debe ser estrictamente mayor que min_workers, así que fijas el número en 2 y vuelves a configurar el rango más tarde.
No uses databricks clusters edit aquí. Editar un clúster en ejecución lo reinicia, y los clústeres creados por el servicio de Jobs directamente no se pueden editar.
Prueba esto primero en un clúster que no sea de producción. Los momentos para usarlo son aquellos en los que sabes que no llegará más trabajo, como el final de una ventana de batch o el inicio de un congelamiento por mantenimiento.
Evítalo en clústeres all-purpose que la gente consulta a lo largo del día. Ahí no puedes predecir la próxima solicitud, así que la ventana de 150 segundos es la mejor protección.
Si bajar al mínimo es seguro al final de cada ventana de batch, ¿por qué alguien de tu equipo sigue haciéndolo a mano? Creemos que no debería. Un paso que es seguro cada vez, y que solo ocurre cuando alguien se acuerda, es un paso que conviene automatizar.
¿Qué pasa cuando llega trabajo nuevo?
Cuando el trabajo regresa, el clúster necesita workers de nuevo, y los nodos nuevos tardan en aprovisionarse. Tras un resize de 5 a 10 workers, por ejemplo, el tamaño objetivo se actualiza de inmediato mientras los workers aumentan gradualmente a medida que los nodos arrancan.
Un instance pool acorta esa espera al mantener instancias inactivas listas, pero solo si el pool es lo bastante grande. Si el clúster pide más que el número mínimo de instancias inactivas del pool, no arranca más rápido que un clúster sin pool.
Las instancias inactivas del pool también aumentan tus costos. Configurar Min Idle instances en 0 evita pagar por instancias que no están trabajando, y el tiempo de Idle Instance Auto Termination controla cuánto permanece en el pool una instancia liberada antes de descartarse.
¿Qué antipatrón rompe todo esto?
El antipatrón es habilitar Apache Spark Dynamic Allocation (spark.dynamicAllocation.enabled) en un clúster que ya usa el autoscaling de Databricks.
El autoscaling de Databricks ya gestiona los nodos worker y el ciclo de vida de los executors a nivel de plataforma, así que activar Dynamic Allocation te deja con dos sistemas tomando la misma decisión. Eso puede provocar decisiones de escalado en conflicto, rotación de executors, errores NODES_LOST y tareas que nunca llegan a ejecutarse.
Si ves cualquiera de esos síntomas en un clúster con autoscaling, revisa primero esa configuración. Elimínala de la Spark config del clúster y revisa también tus políticas de compute, ya que los administradores del workspace pueden usarlas para imponer configuraciones de Spark.
El autoscaling cambia el número de workers. Apagar un clúster inactivo es una tarea distinta, y la terminación automática es un control aparte.
¿Cuánto cuesta hacer esto a mano y qué automatiza SELECT?
Todo lo anterior es tiempo de ingeniería. Lees una especificación de clúster, configuras una Spark config, ejecutas un resize al final de la ventana de batch y ejecutas otro cuando el trabajo se reanuda. Y luego lo repites con el siguiente clúster. Además, los parámetros de autoscaling son solo una de las decisiones de clúster que definen tu factura, junto con el tamaño del clúster, el tipo de instancia y el uso de instancias Spot. Nosotros ubicamos el autoscaling en el nivel de los ahorros fáciles del trabajo de costos en Databricks.
Ese es el trabajo que Automated Savings asume por ti. Automated Savings de SELECT para Databricks ajusta automáticamente el número de workers y el comportamiento del auto-scaling para reducir costos en SQL warehouses y All-Purpose Compute. Reportamos ahorros de hasta un 30 % en workloads elegibles, sin esfuerzo continuo de ingeniería. El capítulo Optimize de nuestro ebook profundiza en esta capa.
¿Ejecutar estos pasos a mano es una decisión defendible, o un costo que se acumula a medida que se multiplican tus clústeres y programaciones? Esa decisión es tuya. Nuestra opinión: para uno o dos clústeres con una programación fija, hacerlo a mano es un trato justo. Más allá de eso, cada clúster nuevo agrega otro resize que alguien tiene que recordar, y ese es el costo que se acumula.
Para conocer tu propio potencial de ahorro, agenda una demo o comienza una prueba gratuita.