

Você ativou o autoscaling do Databricks para parar de pagar por workers que não está usando. Mas, quando um job termina, o cluster não encolhe na hora. Primeiro, ele mantém os workers por uma janela definida: 40 segundos no job compute e 150 segundos no all-purpose compute.
A configuração que controla isso, spark.databricks.aggressiveWindowDownS, só é documentada para alongar essa espera. Se você quer liberar os workers antes, precisa redimensionar o cluster por conta própria. Cortar compute ocioso é um dos cinco hábitos que fazem diferença na fatura do Databricks, e o autoscaling é uma das camadas do framework completo de otimização de custos.
TL;DR
- O Databricks tem três recursos chamados autoscaling: um para clusters clássicos, um para pipelines Lakeflow e um para o Lakebase. Este artigo cobre o primeiro, que roda em clusters de job e all-purpose.
- Um cluster de job faz scale-up com base em tarefas pendentes em relação aos task slots disponíveis, então os gráficos de CPU sozinhos não vão indicar quando ele vai crescer.
- Ele reduz a escala depois de 40 segundos de subutilização no job compute e 150 segundos no all-purpose compute.
- A configuração do timer,
spark.databricks.aggressiveWindowDownS, só é documentada para desacelerar a redução de escala. - Para alterar o número de workers em um cluster em execução, use
databricks clusters resize. O comandodatabricks clusters editreinicia o cluster.
De qual "autoscaling do Databricks" estamos falando, afinal?
O Databricks usa o nome autoscaling para três recursos distintos, cada um em um tipo diferente de compute. Antes de ajustar qualquer coisa, confira qual deles você tem.
Os três tipos de autoscaling do Databricks
- O autoscaling de compute clássico roda em clusters de job e all-purpose. Ele movimenta o número de workers entre um mínimo e um máximo que você define, com base em tarefas pendentes e task slots disponíveis.
- O enhanced autoscaling roda em pipelines Lakeflow e escala com base na utilização de task slots e no tamanho da fila de tarefas.
- O autoscaling do Lakebase redimensiona um compute Postgres dentro de um intervalo de Compute Units (CU) que você define, com base em carga de CPU, uso de memória e tamanho do working set. Ele também tem um recurso separado de scale to zero, que suspende um compute ocioso.
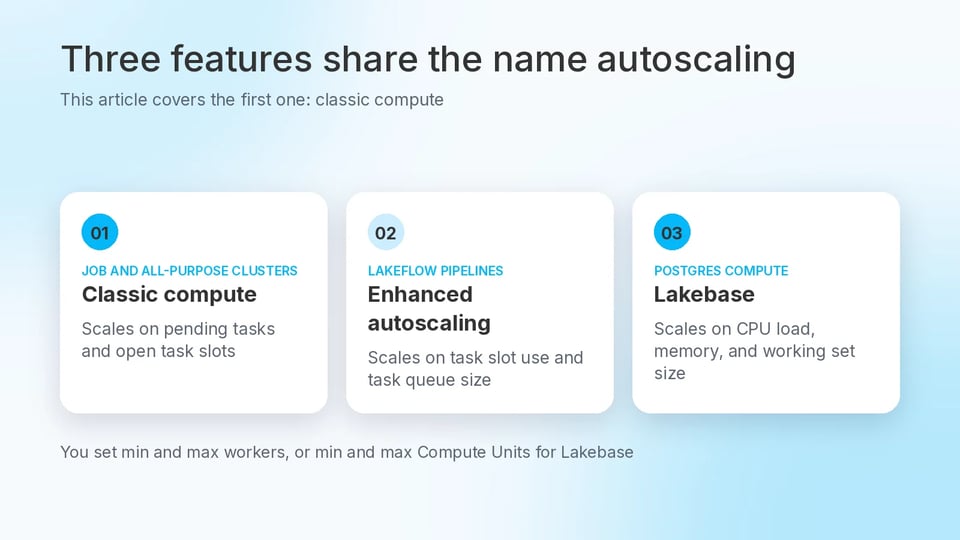
Três recursos do Databricks compartilham o nome autoscaling. Este artigo cobre o primeiro.
Este artigo trata do autoscaling de cluster no compute clássico. Se você está dimensionando um banco Postgres, leia nosso guia do Lakebase.
Como o autoscaling clássico decide fazer scale-up?
Um cluster de job adiciona workers quando o Spark tem mais tarefas pendentes do que task slots para executá-las. O autoscaling decide a partir dos sinais do scheduler do Spark, então a porcentagem de CPU sozinha não vai indicar quando um cluster está prestes a crescer.
Os clusters all-purpose usam o mesmo autoscaler. No plano Premium ou superior, todos os tipos de cluster usam o autoscaling otimizado por padrão, e ele consegue ir do mínimo ao máximo em no máximo dois eventos de escalonamento. Workspaces no plano Standard usam o autoscaling padrão, que começa adicionando oito nós e depois escala de forma exponencial.
Duas limitações valem antes de você contar com ele. O autoscaling não está disponível para jobs spark-submit. E um cluster pode ficar abaixo do seu mínimo quando o provedor de nuvem encerra instâncias — nesse caso, o Databricks continua tentando até restaurar o mínimo.
Tudo o que vem abaixo descreve o autoscaling otimizado na AWS e no Azure.
Aqui está a especificação base do cluster, com um intervalo de autoscaling de 2 a 10 workers. Troque os dois placeholders em maiúsculas por uma versão de runtime e um tipo de nó do seu próprio workspace.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }}O número de workers é só uma parte do custo de um cluster. A taxa cobrada por cada worker também conta. Em clusters clássicos, o compute com Photon habilitado consome Databricks Units (DBUs) a uma taxa maior do que o compute equivalente sem Photon, e a matemática de DBUs do Photon mostra quando isso compensa.
Por que o Databricks espera para liberar workers ociosos?
O Databricks espera porque a redução de escala funciona por janela. Um cluster de job vai reduzir a escala depois de ficar subutilizado por 40 segundos, e um cluster all-purpose depois de 150 segundos. Então um cluster all-purpose que mantém o tamanho por alguns minutos depois que um job termina está se comportando normalmente.
Uma propriedade de configuração do Spark, spark.databricks.aggressiveWindowDownS, define em segundos com que frequência o cluster toma decisões de redução de escala. Você a define na configuração Spark do cluster, e o máximo é 600.
A redução de escala não exige que o cluster inteiro fique parado. O autoscaling otimizado consegue remover workers enquanto o cluster ainda está ocupado, verificando o estado dos arquivos de shuffle, e o quanto ele vai reduzir se baseia em uma porcentagem dos nós atuais. Streaming é diferente. O autoscaling tem limitações ao reduzir workloads de Structured Streaming, e o Databricks recomenda pipelines com enhanced autoscaling nesses casos.
A janela ajuda workloads com picos. Um valor maior mantém os nós por mais tempo, atravessando as pausas curtas de ociosidade entre estágios.
Aumentar o valor faz o cluster reduzir a escala mais devagar. Valores menores não são documentados, então não construa um plano de custos em cima de um deles.
Aqui está a especificação base com a propriedade definida em 300 segundos, para um workload com picos.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }, "spark_conf": { "spark.databricks.aggressiveWindowDownS": "300" }}O padrão serve para um time que responde pela fatura? Achamos que sim. Um valor maior mantém workers ociosos rodando por mais tempo, e você paga por eles enquanto rodam. Só aumentaríamos o valor para um workload com picos, para segurar os workers durante as pausas curtas entre estágios.
O autoscaling é só uma configuração entre muitas. Baixe nosso ebook gratuito, The Guide to Databricks Cost Optimization, com cinco estratégias centrais e uma árvore de decisão que conecta o seu problema de custo específico à correção certa.
Como redimensionar um cluster em execução para liberar workers?
Use databricks clusters resize, o comando da interface de linha de comando (CLI) do Databricks para alterar o número de workers em um cluster em execução. Coloque o cluster no mínimo e depois defina o intervalo de autoscale de novo quando o trabalho voltar.
# Set a fixed worker count of 2databricks clusters resize YOUR_CLUSTER_ID --num-workers 2# Set the autoscale range againdatabricks clusters resize --json '{ "cluster_id": "YOUR_CLUSTER_ID", "autoscale": { "min_workers": 2, "max_workers": 10 }}'O primeiro comando redimensiona o cluster para um número fixo de workers, e só funciona enquanto o cluster está em execução. O segundo define o intervalo de autoscale de novo. Ele passa o ID do cluster dentro do JSON porque a CLI não aceita um argumento posicional junto com --json.
São dois comandos porque um intervalo de autoscale não pode ser um número único. Na API de Clusters, max_workers precisa ser estritamente maior que min_workers, então você define uma contagem fixa de 2 e redefine o intervalo depois.
Não use databricks clusters edit aqui. Editar um cluster em execução reinicia o cluster, e clusters criados pelo serviço de Jobs nem podem ser editados.
Teste isso primeiro em um cluster que não seja de produção. Os momentos certos para usar são aqueles em que você sabe que não vem trabalho pela frente, como o fim de uma janela de batch ou o início de um freeze de manutenção.
Evite essa abordagem em clusters all-purpose que as pessoas consultam ao longo do dia. Ali você não consegue prever a próxima requisição, então a janela de 150 segundos é a melhor proteção.
Se reduzir ao mínimo é seguro no fim de toda janela de batch, por que alguém do seu time ainda faz isso na mão? Achamos que não deveria. Um passo que é seguro todas as vezes, e que só acontece quando alguém lembra dele, é um passo para automatizar.
O que acontece quando chega trabalho novo?
Quando o trabalho volta, o cluster precisa de workers de novo, e nós novos levam tempo para provisionar. Depois de um resize de 5 para 10 workers, por exemplo, o tamanho alvo é atualizado na hora, enquanto os workers aumentam gradualmente à medida que os nós sobem.
Um instance pool encurta essa espera mantendo instâncias ociosas prontas, mas só se o pool for grande o suficiente. Se o cluster pedir mais do que o número mínimo de instâncias ociosas do pool, ele não inicia mais rápido do que um cluster sem pool.
Instâncias ociosas no pool continuam gerando custo. Definir Min Idle instances como 0 evita pagar por instâncias que não estão trabalhando, e o tempo de Idle Instance Auto Termination controla quanto tempo uma instância liberada permanece no pool antes de ser descartada.
Qual anti-pattern quebra tudo isso?
O anti-pattern é habilitar o Dynamic Allocation do Apache Spark (spark.dynamicAllocation.enabled) em um cluster que já usa o autoscaling do Databricks.
O autoscaling do Databricks já gerencia worker nodes e o ciclo de vida dos executors no nível da plataforma, então ligar o Dynamic Allocation deixa dois sistemas tomando a mesma decisão. Isso pode causar decisões de escala conflitantes, churn de executors, erros NODES_LOST e tarefas que nunca chegam a ser executadas.
Se você vir qualquer um desses sintomas em um cluster com autoscaling, procure essa configuração primeiro. Remova-a da configuração Spark do cluster e confira também as suas compute policies, já que admins de workspace podem usá-las para impor configurações do Spark.
O autoscaling altera o número de workers. Desligar um cluster ocioso é outro trabalho, e o auto termination é um controle separado.
Quanto custa fazer isso na mão, e o que o SELECT automatiza?
Tudo o que está acima é tempo de engenharia. Você lê uma especificação de cluster, define uma configuração do Spark, roda um resize no fim da janela de batch e roda outro quando o trabalho volta. Depois faz tudo de novo para o próximo cluster. E os parâmetros de autoscaling são só uma entre as escolhas de cluster que moldam a sua fatura, ao lado do tamanho do cluster, do tipo de instância e do uso de instâncias spot. Colocamos o autoscaling no nível dos ganhos fáceis do trabalho de custos no Databricks.
Foi para assumir esse trabalho que criamos o Automated Savings. O Automated Savings do SELECT para Databricks ajusta automaticamente o número de workers e o comportamento de autoscaling para reduzir custos em SQL warehouses e All Purpose Compute. Reportamos economias de até 30% em workloads elegíveis, sem esforço contínuo de engenharia. O capítulo Optimize do nosso ebook aprofunda essa camada.
Executar esses passos na mão é uma troca defensável ou um custo que se multiplica conforme seus clusters e agendamentos crescem? A decisão é sua. Nossa visão: para um ou dois clusters em um cronograma fixo, fazer na mão é uma troca justa. A partir daí, cada novo cluster adiciona mais um resize que alguém precisa lembrar, e é esse o custo que se multiplica.
Para ver o seu próprio potencial de economia, agende uma demo ou comece um teste gratuito.