

使っていないワーカーへの支払いをやめるために、Databricksのオートスケーリングを有効にしたはずです。ところが、ジョブが終わってもクラスターはすぐには縮小しません。まず一定の時間ワーカーを保持します。その時間は、ジョブコンピュートで40秒、All-Purpose Computeで150秒です。
この挙動を制御する設定であるspark.databricks.aggressiveWindowDownSは、この待ち時間を「長くする」用途についてのみドキュメント化されています。ワーカーをより早く解放したい場合は、自分でクラスターをリサイズすることになります。アイドル状態のコンピュートの削減は、Databricksの請求額を左右する5つの習慣の1つであり、オートスケーリングはコスト最適化フレームワーク全体を構成するレイヤーの1つです。
要点まとめ
- Databricksには「オートスケーリング」と呼ばれる機能が3つあります。クラシッククラスター用、Lakeflowパイプライン用、Lakebase用です。本記事では、ジョブクラスターとAll-Purposeクラスターで動作する1つ目を取り上げます。
- ジョブクラスターは利用可能なタスクスロットに対する保留中のタスクに基づいてスケールアップするため、CPUのグラフだけではいつ拡大するかは分かりません。
- スケールダウンは、ジョブコンピュートでは低使用率が40秒、All-Purpose Computeでは150秒続いた後に行われます。
- タイマー設定である
spark.databricks.aggressiveWindowDownSは、スケールダウンを遅らせる用途についてのみドキュメント化されています。 - 実行中のクラスターのワーカー数を変更するには
databricks clusters resizeを使います。databricks clusters editはクラスターを再起動してしまいます。
そもそも、どの「Databricksオートスケーリング」の話なのか
Databricksでは、それぞれ異なる種類のコンピュートで動作する3つの独立した機能に「オートスケーリング」という名前が使われています。チューニングを始める前に、自分がどれを使っているのかを確認しましょう。
Databricksオートスケーリングの3つの種類
- クラシックコンピュートのオートスケーリングは、ジョブクラスターとAll-Purposeクラスターで動作します。保留中のタスクと利用可能なタスクスロットに基づき、設定した最小値と最大値の間でワーカー数を増減させます。
- 拡張オートスケーリングはLakeflowパイプラインで動作し、タスクスロット使用率とタスクキューのサイズに基づいてスケールします。
- Lakebaseのオートスケーリングは、設定したCompute Units(CU)の範囲内で、CPU負荷、メモリ使用量、ワーキングセットサイズに基づいてPostgresコンピュートをリサイズします。アイドル状態のコンピュートを一時停止する「スケール・トゥ・ゼロ」機能も別途用意されています。
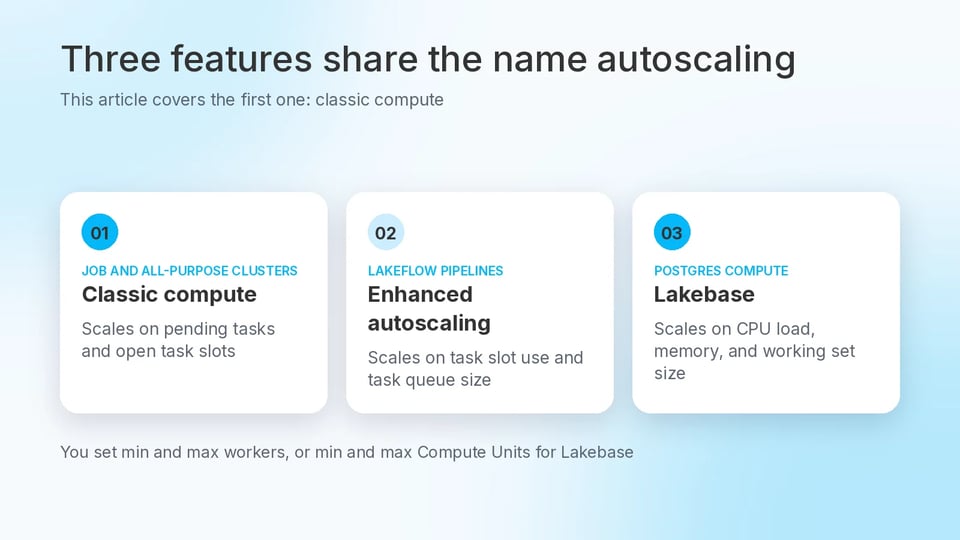
3つのDatabricks機能が「オートスケーリング」という同じ名前を持っています。本記事では1つ目を取り上げます。
本記事では、クラシックコンピュートにおけるクラスターオートスケーリングを扱います。Postgresデータベースのサイジングについては、Lakebaseガイドをご覧ください。
クラシックオートスケーリングはどのようにスケールアップを判断するのか
ジョブクラスターは、Sparkで実行待ちのタスクが実行可能なタスクスロットの数を上回ったときにワーカーを追加します。オートスケーリングはSparkスケジューラのシグナルに基づいて判断するため、CPU使用率だけを見ていても、クラスターがいつ拡大するかは分かりません。
All-Purposeクラスターも同じオートスケーラーを使用します。Premiumプラン以上では、すべてのクラスタータイプがデフォルトで最適化オートスケーリングを使用し、最大2回のスケーリングイベントで最小から最大までスケールできます。Standardプランのワークスペースでは標準オートスケーリングが使われ、まず8ノードを追加し、その後は指数関数的にスケールアップします。
利用する前に押さえておくべき制限が2つあります。オートスケーリングはspark-submitジョブでは利用できません。また、クラウドプロバイダーがインスタンスを終了させた場合、クラスターは設定した最小値を下回ることがあり、その場合Databricksは最小値が回復するまで再試行を続けます。
以下の内容はすべて、AWSおよびAzure上の最適化オートスケーリングについての説明です。
ベースラインとなるクラスター仕様は次のとおりで、オートスケーリング範囲は2〜10ワーカーです。大文字のプレースホルダー2つは、ご自身のワークスペースのランタイムバージョンとノードタイプに置き換えてください。
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }}クラスターのコストを決めるのはワーカー数だけではありません。各ワーカーの課金レートも重要です。クラシッククラスターでは、Photon対応のコンピュートは同等の非PhotonコンピュートよりもDatabricks Unit(DBU)を高いレートで消費します。PhotonのDBU計算では、それが割に合う条件を解説しています。
なぜDatabricksはアイドル状態のワーカーをすぐに手放さないのか
Databricksが待つのは、スケールダウンがウィンドウ単位で動作するためです。ジョブクラスターは低使用率が40秒続くとスケールダウンし、All-Purposeクラスターは150秒後にスケールダウンします。つまり、ジョブ終了後も数分間サイズを維持するAll-Purposeクラスターは、正常に動作しているということです。
Spark構成プロパティspark.databricks.aggressiveWindowDownSは、クラスターがスケールダウンの判断を行う頻度を秒単位で設定します。クラスターのSpark構成で設定し、最大値は600です。
スケールダウンのために、クラスター全体がアイドル状態になるのを待つ必要はありません。最適化オートスケーリングは、シャッフルファイルの状態を確認することで、クラスターがまだビジーな状態でもワーカーを削除でき、どこまでスケールダウンするかは現在のノード数に対する割合で決まります。ストリーミングは別です。Structured Streamingのワークロードのスケールダウンには制限があり、Databricksはそうした用途には拡張オートスケーリングを備えたパイプラインを推奨しています。
このウィンドウは、バースト性のあるワークロードに有効です。値を高くすると、ステージ間の短いアイドル時間を越えてノードをより長く保持します。
値を上げると、クラスターのスケールダウンは遅くなります。デフォルトより低い値はドキュメント化されていないため、それを前提にコスト計画を立てるのは避けましょう。
バースト性のあるワークロード向けに、このプロパティを300秒に設定したベースライン仕様は次のとおりです。
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }, "spark_conf": { "spark.databricks.aggressiveWindowDownS": "300" }}請求額に責任を持つチームにとって、デフォルト値は適切でしょうか。私たちは適切だと考えます。値を高くするとアイドル状態のワーカーがより長く動き続け、その間の料金が発生します。値を上げるのは、ステージ間の短い空き時間でもワーカーを保持したいバースト性のあるワークロードの場合だけにすべきです。
オートスケーリングは数ある設定の1つにすぎません。無料のebook『The Guide to Databricks Cost Optimization』では、5つの主要戦略と、個別のコスト課題を適切な対策に結びつけるデシジョンツリーを紹介しています。ぜひダウンロードしてください。
実行中のクラスターをリサイズしてワーカーを解放するには
実行中のクラスターのワーカー数を変更するには、DatabricksのCLI(コマンドラインインターフェース)コマンドであるdatabricks clusters resizeを使います。クラスターを最小構成にし、作業が再開したら再度オートスケール範囲を設定します。
# Set a fixed worker count of 2databricks clusters resize YOUR_CLUSTER_ID --num-workers 2# Set the autoscale range againdatabricks clusters resize --json '{ "cluster_id": "YOUR_CLUSTER_ID", "autoscale": { "min_workers": 2, "max_workers": 10 }}'1つ目のコマンドはクラスターを固定のワーカー数にリサイズするもので、クラスターの実行中にのみ機能します。2つ目はオートスケール範囲を再設定します。CLIは--jsonと位置引数を併用できないため、クラスターIDはJSON内で渡しています。
コマンドが2つ必要なのは、オートスケール範囲を単一の数値にはできないためです。Clusters APIではmax_workersはmin_workersより大きい値でなければならないため、まず固定値の2を設定し、後から範囲を再設定します。
ここでdatabricks clusters editは使わないでください。実行中のクラスターを編集すると再起動が発生し、Jobsサービスが作成したクラスターはそもそも編集できません。
まずは本番以外のクラスターで試してください。使いどころは、バッチウィンドウの終了時やメンテナンスフリーズの開始時など、新しい処理が来ないと確実に分かっている場面です。
日中に人がクエリを実行するAll-Purposeクラスターでは使わないでください。次のリクエストが予測できない環境では、150秒のウィンドウに任せる方が安全です。
バッチウィンドウの終わりに最小構成まで落とすのが毎回安全なら、なぜチームの誰かがいまだに手作業でやっているのでしょうか。私たちは、やるべきではないと考えます。毎回安全で、かつ誰かが思い出したときにしか実行されない手順は、自動化すべき手順です。
新しい処理が来たときに何が起こるのか
処理が戻ってくると、クラスターは再びワーカーを必要とし、新しいノードのプロビジョニングには時間がかかります。たとえば5ワーカーから10ワーカーへのリサイズ後、目標サイズは即座に更新されますが、ノードの起動に伴ってワーカーは段階的に増加していきます。
インスタンスプールは、アイドル状態のインスタンスを待機させておくことでこの待ち時間を短縮しますが、それはプールが十分な大きさの場合に限ります。クラスターがプールの最小アイドルインスタンス数を超える数を要求した場合、起動速度はプールなしのクラスターと変わりません。
アイドル状態のプールインスタンスにもコストはかかります。Min Idleインスタンスを0に設定すれば処理をしていないインスタンスへの支払いを回避でき、Idle Instance Auto Terminationの時間で、解放されたインスタンスがプールから削除されるまでの保持時間を制御できます。
すべてを台無しにするアンチパターンとは
そのアンチパターンとは、すでにDatabricksのオートスケーリングを使っているクラスターで、Apache SparkのDynamic Allocation(spark.dynamicAllocation.enabled)を有効にすることです。
Databricksのオートスケーリングは、プラットフォームレベルでワーカーノードとエグゼキューターのライフサイクルをすでに管理しているため、Dynamic Allocationを有効にすると、同じ判断を2つのシステムが行うことになります。その結果、スケーリング判断の競合、エグゼキューターの頻繁な入れ替わり、NODES_LOSTエラー、いつまでも実行されないタスクが発生することがあります。
オートスケーリングクラスターでこれらの症状が見られたら、まずこの設定を疑ってください。クラスターのSpark構成から削除し、あわせてコンピュートポリシーも確認しましょう。ワークスペース管理者はポリシーによってSpark構成を強制できるためです。
オートスケーリングが変更するのはワーカー数です。アイドル状態のクラスターのシャットダウンは別の仕事であり、自動終了は別のコントロールです。
手作業のコストと、SELECTが自動化するもの
ここまでの作業はすべてエンジニアリング時間です。クラスター仕様を読み、Spark構成を設定し、バッチウィンドウの終わりにリサイズを実行し、処理が再開したらもう一度実行する。そして次のクラスターでも同じことを繰り返します。しかもオートスケーリングのパラメータは、クラスターサイズ、インスタンスタイプ、スポットインスタンスの利用と並ぶ、請求額を左右するクラスター設定の1つにすぎません。私たちはオートスケーリングを、Databricksコスト対策における「手軽に成果が出る」層に位置づけています。
この作業を肩代わりするために、私たちはAutomated Savingsを開発しました。SELECTのDatabricks向けAutomated Savingsは、ワーカー数とオートスケーリングの挙動を自動調整し、SQL WarehouseとAll-Purpose Computeのコストを削減します。継続的なエンジニアリング工数なしで、対象ワークロードで最大30%の削減を報告しています。ebookのOptimizeの章では、このレイヤーをさらに深く解説しています。
これらの手順を手作業で続けることは割に合う選択でしょうか。それとも、クラスターとスケジュールが増えるほど膨らんでいくコストでしょうか。その判断はお任せします。私たちの見解としては、固定スケジュールで動くクラスターが1〜2台なら手作業でも割に合います。それを超えると、新しいクラスターが増えるたびに誰かが覚えておくべきリサイズが1つ増え、それこそが膨らみ続けるコストです。
ご自身の削減余地を確認するには、デモを予約するか、無料トライアルを開始してください。