

Sie haben Databricks Autoscaling aktiviert, um nicht länger für Worker zu bezahlen, die Sie gar nicht nutzen. Doch wenn ein Job abgeschlossen ist, schrumpft der Cluster nicht sofort. Er behält seine Worker zunächst für ein festes Zeitfenster – 40 Sekunden bei Job Compute und 150 Sekunden bei All-Purpose Compute.
Die Einstellung dahinter, spark.databricks.aggressiveWindowDownS, ist nur dafür dokumentiert, diese Wartezeit zu verlängern. Sollen Worker schneller verschwinden, müssen Sie den Cluster selbst anpassen. Ungenutztes Compute abzubauen ist eine der fünf Stellschrauben, die eine Databricks-Rechnung wirklich bewegen, und Autoscaling ist eine Ebene des vollständigen Frameworks zur Kostenoptimierung.
TL;DR
- Databricks hat drei Features namens Autoscaling: eines für klassische Cluster, eines für Lakeflow-Pipelines und eines für Lakebase. Dieser Artikel behandelt das erste, das auf Job- und All-Purpose-Clustern läuft.
- Ein Job-Cluster skaliert anhand ausstehender Tasks im Verhältnis zu verfügbaren Task-Slots hoch – CPU-Diagramme allein verraten Ihnen also nicht, wann er wächst.
- Herunterskaliert wird nach 40 Sekunden Unterauslastung bei Job Compute und nach 150 Sekunden bei All-Purpose Compute.
- Die Timer-Einstellung
spark.databricks.aggressiveWindowDownSist nur dafür dokumentiert, das Herunterskalieren zu verlangsamen. - Um die Worker-Anzahl eines laufenden Clusters zu ändern, verwenden Sie
databricks clusters resize.databricks clusters editstartet den Cluster neu.
Über welches "Databricks Autoscaling" sprechen wir überhaupt?
Databricks verwendet den Namen Autoscaling für drei separate Features, jedes auf einer anderen Art von Compute. Bevor Sie etwas tunen, prüfen Sie, welches Sie vor sich haben.
Die drei Arten von Databricks Autoscaling
- Autoscaling für Classic Compute läuft auf Job- und All-Purpose-Clustern. Es bewegt die Worker-Anzahl zwischen einem von Ihnen gesetzten Minimum und Maximum, basierend auf ausstehenden Tasks und verfügbaren Task-Slots.
- Enhanced Autoscaling läuft auf Lakeflow-Pipelines und skaliert anhand der Task-Slot-Auslastung und der Größe der Task-Queue.
- Lakebase Autoscaling passt die Größe eines Postgres-Computes innerhalb eines von Ihnen definierten Bereichs an Compute Units (CU) an, basierend auf CPU-Last, Speichernutzung und Working-Set-Größe. Es hat außerdem ein separates Scale-to-Zero-Feature, das ein ungenutztes Compute pausiert.
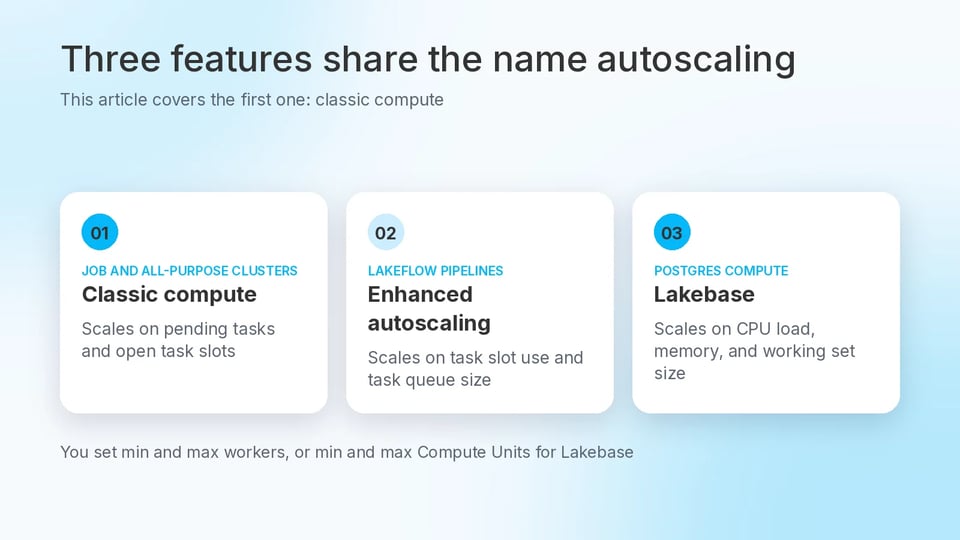
Drei Databricks-Features teilen sich den Namen Autoscaling. Dieser Artikel behandelt das erste.
Dieser Artikel behandelt Cluster-Autoscaling auf Classic Compute. Wenn Sie eine Postgres-Datenbank dimensionieren, lesen Sie unseren Lakebase-Guide.
Wie entscheidet klassisches Autoscaling über das Hochskalieren?
Ein Job-Cluster fügt Worker hinzu, wenn Spark mehr ausstehende Tasks hat als Task-Slots, um sie auszuführen. Autoscaling entscheidet anhand von Signalen des Spark-Schedulers – der CPU-Prozentsatz allein verrät Ihnen also nicht, wann ein Cluster gleich wächst.
All-Purpose-Cluster nutzen denselben Autoscaler. Ab dem Premium-Plan verwendet jeder Cluster-Typ standardmäßig Optimized Autoscaling, das in höchstens zwei Skalierungsschritten vom Minimum zum Maximum skalieren kann. Workspaces im Standard-Plan nutzen Standard Autoscaling, das zunächst acht Knoten hinzufügt und dann exponentiell hochskaliert.
Zwei Einschränkungen gelten, bevor Sie sich darauf verlassen. Autoscaling ist für spark-submit-Jobs nicht verfügbar. Und ein Cluster kann unter Ihr Minimum fallen, wenn der Cloud-Anbieter Instanzen terminiert – in diesem Fall versucht Databricks es so lange erneut, bis das Minimum wiederhergestellt ist.
Alles Folgende beschreibt Optimized Autoscaling auf AWS und Azure.
Hier die Basis-Cluster-Spezifikation mit einem Autoscaling-Bereich von 2 bis 10 Workern. Ersetzen Sie die beiden großgeschriebenen Platzhalter durch eine Runtime-Version und einen Node-Typ aus Ihrem eigenen Workspace.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }}Die Worker-Anzahl ist nur ein Teil der Clusterkosten. Der Tarif, zu dem jeder Worker abgerechnet wird, zählt ebenfalls. Auf klassischen Clustern verbraucht Photon-aktiviertes Compute Databricks Units (DBUs) zu einem höheren Satz als vergleichbares Compute ohne Photon, und die DBU-Rechnung von Photon zeigt, wann sich das lohnt.
Warum wartet Databricks, bevor es ungenutzte Worker freigibt?
Databricks wartet, weil das Herunterskalieren über ein Zeitfenster läuft. Ein Job-Cluster skaliert herunter, sobald er 40 Sekunden lang unterausgelastet war, ein All-Purpose-Cluster nach 150 Sekunden. Ein All-Purpose-Cluster, der nach dem Ende eines Jobs noch ein paar Minuten seine Größe hält, verhält sich also völlig normal.
Eine Spark-Konfigurationseigenschaft, spark.databricks.aggressiveWindowDownS, legt in Sekunden fest, wie oft der Cluster Entscheidungen zum Herunterskalieren trifft. Sie setzen sie in der Spark-Konfiguration des Clusters, das Maximum ist 600.
Fürs Herunterskalieren muss nicht der gesamte Cluster stillstehen. Optimized Autoscaling kann Worker entfernen, während der Cluster noch beschäftigt ist, indem es den Zustand der Shuffle-Dateien prüft; wie weit heruntergeskaliert wird, richtet sich nach einem Prozentsatz der aktuellen Knoten. Streaming ist ein Sonderfall. Beim Herunterskalieren von Structured-Streaming-Workloads stößt Autoscaling an Grenzen, und Databricks empfiehlt dafür Pipelines mit Enhanced Autoscaling.
Das Zeitfenster hilft bei Workloads mit Lastspitzen. Ein höherer Wert hält Knoten länger – auch über die kurzen Leerlaufphasen zwischen Stages hinweg.
Ein höherer Wert lässt den Cluster langsamer herunterskalieren. Niedrigere Werte sind nicht dokumentiert, bauen Sie also keinen Kostenplan darauf auf.
Hier die Basis-Spezifikation mit der Eigenschaft auf 300 Sekunden, für einen Workload mit Lastspitzen.
{ "cluster_name": "nightly-etl", "spark_version": "YOUR_RUNTIME_VERSION", "node_type_id": "YOUR_NODE_TYPE", "autoscale": { "min_workers": 2, "max_workers": 10 }, "spark_conf": { "spark.databricks.aggressiveWindowDownS": "300" }}Passt der Standardwert zu einem Team, das für die Rechnung geradesteht? Wir meinen: ja. Ein höherer Wert lässt ungenutzte Worker länger laufen, und Sie bezahlen sie, solange sie laufen. Wir würden ihn nur für einen Workload mit Lastspitzen erhöhen, um Worker über die kurzen Pausen zwischen Stages hinweg zu halten.
Autoscaling ist nur eine Einstellung von vielen. Laden Sie unser kostenloses E-Book The Guide to Databricks Cost Optimization herunter: fünf Kernstrategien und ein Entscheidungsbaum, der Ihr konkretes Kostenproblem der passenden Lösung zuordnet.
Wie ändern Sie die Größe eines laufenden Clusters, um Worker freizugeben?
Verwenden Sie databricks clusters resize, den Befehl der Databricks-Kommandozeile (CLI) zum Ändern der Worker-Anzahl eines laufenden Clusters. Setzen Sie den Cluster auf sein Minimum und stellen Sie den Autoscale-Bereich wieder ein, sobald die Arbeit weitergeht.
# Set a fixed worker count of 2databricks clusters resize YOUR_CLUSTER_ID --num-workers 2# Set the autoscale range againdatabricks clusters resize --json '{ "cluster_id": "YOUR_CLUSTER_ID", "autoscale": { "min_workers": 2, "max_workers": 10 }}'Der erste Befehl setzt den Cluster auf eine feste Worker-Anzahl und funktioniert nur, solange der Cluster läuft. Der zweite stellt den Autoscale-Bereich wieder ein. Er übergibt die Cluster-ID innerhalb des JSON, weil die CLI neben --json kein Positionsargument akzeptiert.
Es braucht zwei Befehle, weil ein Autoscale-Bereich keine einzelne Zahl sein kann. In der Clusters-API muss max_workers strikt größer sein als min_workers; Sie setzen also eine feste Anzahl von 2 und stellen den Bereich später wieder ein.
Verwenden Sie hier nicht databricks clusters edit. Das Bearbeiten eines laufenden Clusters startet ihn neu, und vom Jobs-Service erstellte Cluster lassen sich gar nicht bearbeiten.
Testen Sie das zunächst auf einem Cluster außerhalb der Produktion. Die richtigen Momente dafür sind die, in denen Sie wissen, dass keine Arbeit ansteht – etwa am Ende eines Batch-Fensters oder zu Beginn eines Maintenance-Freeze.
Verzichten Sie darauf bei All-Purpose-Clustern, auf denen den ganzen Tag über Abfragen laufen. Dort lässt sich die nächste Anfrage nicht vorhersagen, und das 150-Sekunden-Fenster ist der bessere Schutz.
Wenn das Herunterfahren auf das Minimum am Ende jedes Batch-Fensters sicher ist – warum erledigt es dann noch jemand in Ihrem Team von Hand? Unserer Meinung nach sollte das niemand tun müssen. Ein Schritt, der jedes Mal sicher ist und nur dann passiert, wenn jemand daran denkt, ist ein Fall für die Automatisierung.
Was passiert, wenn neue Arbeit ansteht?
Kommt die Arbeit zurück, braucht der Cluster wieder Worker – und das Provisionieren neuer Knoten braucht Zeit. Nach einem Resize von 5 auf 10 Worker wird beispielsweise die Zielgröße sofort aktualisiert, während die Worker schrittweise hinzukommen, sobald die Knoten hochfahren.
Ein Instance Pool verkürzt diese Wartezeit, indem er ungenutzte Instanzen bereithält – aber nur, wenn der Pool groß genug ist. Fordert der Cluster mehr an als die minimale Anzahl ungenutzter Instanzen im Pool, startet er nicht schneller als ein Cluster ohne Pool.
Ungenutzte Pool-Instanzen kosten trotzdem Geld. Mit Min Idle Instances auf 0 bezahlen Sie keine Instanzen, die keine Arbeit verrichten, und die Idle Instance Auto Termination-Zeit steuert, wie lange eine freigegebene Instanz im Pool bleibt, bevor sie entfernt wird.
Welches Anti-Pattern bringt das alles durcheinander?
Das Anti-Pattern: Apache Spark Dynamic Allocation (spark.dynamicAllocation.enabled) auf einem Cluster aktivieren, der bereits Databricks Autoscaling nutzt.
Databricks Autoscaling verwaltet Worker-Knoten und den Executor-Lebenszyklus bereits auf Plattformebene. Wer zusätzlich Dynamic Allocation einschaltet, hat zwei Systeme, die dieselbe Entscheidung treffen. Das kann zu widersprüchlichen Skalierungsentscheidungen, Executor-Churn, NODES_LOST-Fehlern und Tasks führen, die nie aufgenommen werden.
Wenn Sie eines dieser Symptome auf einem Autoscaling-Cluster sehen, prüfen Sie zuerst diese Einstellung. Entfernen Sie sie aus der Spark-Konfiguration des Clusters, und prüfen Sie auch Ihre Compute-Policies, denn Workspace-Admins können darüber Spark-Konfigurationen erzwingen.
Autoscaling ändert die Worker-Anzahl. Einen ungenutzten Cluster abzuschalten ist eine andere Aufgabe, und Auto Termination ist ein separater Hebel.
Was kostet die Handarbeit – und was automatisiert SELECT?
Alles oben ist Engineering-Zeit. Sie lesen eine Cluster-Spezifikation, setzen eine Spark-Konfiguration, führen am Ende des Batch-Fensters ein Resize aus und ein weiteres, wenn die Arbeit weitergeht. Und dann noch einmal für den nächsten Cluster. Dabei sind Autoscaling-Parameter nur eine der Cluster-Entscheidungen, die Ihre Rechnung prägen – neben Clustergröße, Instanztyp und Spot-Instance-Nutzung. Wir zählen Autoscaling zur Kategorie der Quick Wins in der Databricks-Kostenarbeit.
Genau diese Arbeit übernimmt Automated Savings. SELECTs Automated Savings für Databricks passt Worker-Anzahl und Autoscaling-Verhalten automatisch an, um die Kosten für SQL Warehouses und All Purpose Compute zu senken. Wir berichten von Einsparungen von bis zu 30 Prozent bei geeigneten Workloads – ganz ohne laufenden Engineering-Aufwand. Das Kapitel "Optimize" in unserem E-Book vertieft diese Ebene.
Ist das manuelle Ausführen dieser Schritte ein vertretbarer Kompromiss – oder ein Kostenfaktor, der mit jedem weiteren Cluster und Zeitplan wächst? Das entscheiden Sie. Unsere Sicht: Für ein oder zwei Cluster mit festem Zeitplan ist Handarbeit ein fairer Tausch. Darüber hinaus bringt jeder neue Cluster ein weiteres Resize mit, an das jemand denken muss – und genau diese Kosten summieren sich.
Um Ihr eigenes Einsparpotenzial zu sehen, buchen Sie eine Demo oder starten Sie eine kostenlose Testphase.