

TL;DR
Le catalogue REST Iceberg de Snowflake Horizon vous permet de charger et de transformer vos données sous forme de tables Iceberg gouvernées, sans consommer le moindre compute Snowflake. dlt écrit les données brutes en Iceberg via un pipeline open source, dbt Fusion avec DuckDB les transforme, et les deux committent directement via le catalogue de Snowflake sans jamais démarrer de warehouse. Dès que les données arrivent, elles sont entièrement gouvernées par Snowflake : RBAC, masquage, lignage, tags, Cortex. Tout cela est devenu possible fin juin 2026, lorsque DuckDB 1.5.4, dbt Fusion preview.194+ et la prise en charge des écritures externes de Snowflake Horizon ont été livrés en même temps.
Lors du Snowflake Summit 2026, Snowflake a affirmé offrir la prise en charge la plus large d'Iceberg V3, en étant le premier catalogue entièrement ouvert à permettre les lectures et écritures externes vers Iceberg, y compris les deletion vectors, le row lineage, le type variant et les valeurs par défaut. Il fallait donc que je mette cela à l'épreuve.
L'aspect "écritures externes", combiné à quelques évolutions récentes côté dbt et DuckDB, rend possible une version du lakehouse que je voulais construire pour mes clients et qui était hors de portée avant fin juin 2026. Le principe : vos tables résident dans votre propre stockage cloud, dans un format ouvert, avec un catalogue sans aucune gestion, facile à mettre en place, simple à lire et à écrire, lisible par n'importe quel moteur et accessible en écriture par d'autres moteurs comme DuckDB. Mais ces tables restent gouvernées par Snowflake : un seul catalogue, un seul jeu de grants, un seul endroit où vivent le masquage, le lignage et les tags. Stockage ouvert en dessous, vraie gouvernance + IA Snowflake au-dessus.
- Déposez les données brutes au format Apache Iceberg dans votre propre bucket S3, sans le moindre warehouse Snowflake démarré.
- Transformez-les en une nouvelle table Iceberg avec dbt. Encore une fois : aucun warehouse Snowflake démarré.
- Servez-les à l'IA et à la BI avec toute la stack de gouvernance Snowflake : RBAC, politiques de masquage, politiques d'accès aux lignes, tags, lignage, Cortex.
Ce qui rend tout cela possible, c'est le catalogue REST Iceberg de Snowflake Horizon. Les moteurs externes (dlt, DuckDB, dbt tournant sur votre laptop ou dans un petit conteneur) écrivent directement des tables Iceberg gérées par Snowflake via cette API. Snowflake détient le catalogue, délivre des identifiants S3 à portée limitée au moment de l'écriture, et votre moteur effectue le calcul. Ce qui en sort est une table gouvernée de premier ordre. Pas une table externe que Snowflake regarde de travers. Une vraie table. Et le catalogue est déjà là. Vous ne l'installez pas. Vous ne l'activez pas. Il est livré avec Snowflake.
L'étape de transformation est la partie la plus récente de cette stack, le reste étant déjà possible auparavant. Il a fallu trois releases spécifiques livrées en même temps : DuckDB 1.5.4 a ajouté les options de compatibilité d'écriture qui permettent à DuckDB de committer en Iceberg via un catalogue REST, dbt Fusion preview.194+ a exposé ces options dans catalogs.yml v2, et Snowflake Horizon a finalisé son chemin d'écriture pour moteurs externes via l'API du catalogue REST Iceberg. Si vous aviez tenté l'expérience avant le 30 juin 2026 (release de Fusion 194), l'écriture échouait tout simplement.
Ce que recouvre vraiment le catalogue REST Iceberg ici
Petit point de vocabulaire. Apache Iceberg est le format de table ouvert qui vous permet de lire et d'écrire des fichiers parquet comme des tables (select, insert, etc.), avec en plus un arbre de métadonnées qui offre des commits ACID, l'évolution de schéma et le time travel. Le catalogue REST est la spécification d'API ouverte qui indique à un moteur où se trouvent les métadonnées courantes et coordonne les commits SQL.
Snowflake Horizon implémente cette API de catalogue REST et la pointe vers des tables Iceberg gérées par Snowflake. Donc quand DuckDB ou dlt parle le protocole REST Iceberg, c'est Snowflake qui répond, en tant que catalogue. L'endpoint ressemble à ceci :
1https://<your-account>.snowflakecomputing.com/polaris/api/catalog
Deux choses à bien intégrer :
- Dans le vocabulaire du catalogue REST, le
warehousedésigne votre base de données Snowflake (dans notre exemple ci-dessous, nous l'appelonsICE_RAW), et non un virtual warehouse. Aucun compute n'est impliqué par le motwarehousedans ce contexte. - L'authentification est un échange de tokens OAuth2. Vous transmettez à Horizon un Programmatic Access Token (PAT) Snowflake en guise de
client_secret, avec un scope du typesession:role:TRANSFORMER, et il vous renvoie un bearer token à courte durée de vie. Votre rôle, et chaque grant qui lui est attaché, voyage avec ce token.
Ce second point résume toute la gouvernance en une phrase : le catalogue distribue les accès par rôle Snowflake. Gardez cette idée en tête ; elle revient dans la section "servir".
L'architecture, sur un seul écran
Chaque flèche allant d'un moteur vers le catalogue n'implique aucun compute Snowflake. Les moteurs font le travail ; Horizon gouverne et orchestre. Les données restent dans votre bucket du début à la fin.
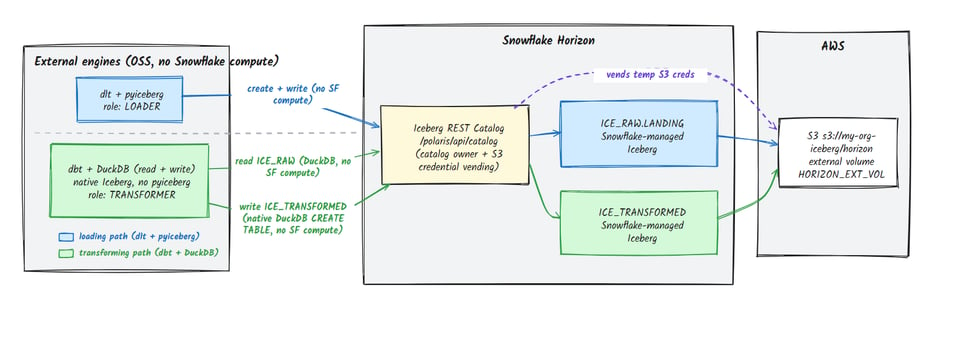
Le socle à poser une seule fois (et pourquoi ce n'est pas le catalogue)
La mise en place est étonnamment simple. Snowflake a éliminé presque toute la complexité liée à la configuration du catalogue Iceberg. Voici ce qu'il vous faut configurer.
- Où vivent les données. Un bucket S3 et un external volume Snowflake qui pointe dessus, avec un rôle IAM que Snowflake assume. C'est la partie "votre stockage, votre bucket" du lakehouse ouvert.
- Qui peut y toucher. Quelques rôles Snowflake et un utilisateur de service avec des Programmatic Access Tokens. C'est simplement du RBAC Snowflake. Vous le connaissez déjà.
Le repo d'accompagnement fait tout cela avec Terraform + un peu de SQL, pour que vous puissiez lire chaque ligne. Le stockage :
# tf/snowflake: the external volume + Iceberg-by-default databases
resource "snowflake_external_volume" "horizon" {
  name = "HORIZON_EXT_VOL"
  storage_location {
    storage_location_name = "horizon-s3"
    storage_provider      = "S3"
    storage_base_url      = "s3://my-org-iceberg/horizon/"
    storage_aws_role_arn  = aws_iam_role.snowflake.arn
  }
}

resource "snowflake_database" "ice_raw" {
  name   = "ICE_RAW"
  external_volume = snowflake_external_volume.horizon.name
  catalog  = "SNOWFLAKE"   # Snowflake-managed Iceberg
Déplier le code
L'accès : du RBAC classique, deux rôles, un utilisateur de service qui les porte.
-- sql/horizon_access.sql (abridged)
CREATE ROLE IF NOT EXISTS LOADER;       -- writes ICE_RAW
CREATE ROLE IF NOT EXISTS TRANSFORMER;  -- reads ICE_RAW, writes ICE_TRANSFORMED

GRANT USAGE ON DATABASE ICE_RAW TO ROLE TRANSFORMER;
GRANT USAGE ON SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON ALL ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON FUTURE ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;

GRANT USAGE ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;
GRANT CREATE SCHEMA ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;

CREATE USER IF NOT EXISTS HORIZON_SVC TYPE = SERVICE;
GRANT ROLE LOADER, TRANSFORMER TO USER HORIZON_SVC;
Vous émettez ensuite les tokens. Chaque moteur reçoit un PAT limité à un seul rôle, avec le principe du moindre privilège intégré d'office :
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_LOAD_PAT DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='LOADER'      COMMENT='dlt loader'"      --role ACCOUNTADMIN
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_PAT      DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='TRANSFORMER' COMMENT='dbt transformer'" --role ACCOUNTADMIN
Et voilà. C'est tout le socle. Un stockage que vous possédez, des rôles que vous accordez. Nulle part vous n'avez construit de catalogue, parce que le catalogue, c'est Horizon, et Horizon est tout simplement… actif.
💡Un vrai piège à connaître pour vous épargner une heure : le hostname utilise un tiret, pas un underscore. C'est myorg-myacct.snowflakecomputing.com, et le module ssl de Python rejette la forme avec underscore. curl la tolère, donc tout semblera fonctionner jusqu'à ce que votre pipeline, lui, ne fonctionne plus.
Pilier 1 : charger, sans compute Snowflake
Le code complet est disponible dans le repo ici. Dans cet article, j'en extrais quelques passages pertinents pour la lisibilité.
Côté chargement, c'est dlt avec sa destination open source filesystem et table_format="iceberg", pointée vers le catalogue REST Horizon. Pas de dlt+, pas de connecteur sous licence. dlt écrit le parquet et committe via le catalogue avec pyiceberg ; Horizon délivre les identifiants S3.
La connexion au catalogue vit dans les secrets de dlt, et la seule subtilité spécifique à Snowflake est la suivante : l'Iceberg géré par Snowflake assigne lui-même l'emplacement de la table (sous votre external volume) et rejette donc tout emplacement fourni par le client. Nous surchargeons le create_table de dlt pour l'omettre :
import dlt
from dlt.destinations import filesystem
import dlt.common.libs.pyiceberg as _ice
import pyarrow as _pa

# Snowflake Horizon assigns the table location under the external volume and
# rejects a client-supplied one, so drop `location` on create. That's the
# intended external-write flow.
def _create_no_location(catalog, table_id, table_location, schema, **kw):
    if isinstance(schema, _pa.Schema):
        schema = _ice.ensure_iceberg_compatible_arrow_schema(schema)
    catalog.create_table(identifier=table_id, schema=schema,
                         partition_spec=kw.get("partition_spec", _ice.UNPARTITIONED_PARTITION_SPEC),
                         properties=kw.get("properties") or {})
_ice.create_table = _create_no_location
Déplier le code
Lancez-le :
1uv run python hello_world_pipeline.py
Et voici le moment clé. Allez dans Snowflake (là, vous pouvez utiliser un warehouse, puisque vous êtes un humain qui exécute une requête) et la table est là, gouvernée, interrogeable, de type MANAGED :
1SELECT * FROM ICE_RAW.LANDING.HELLO_WORLD;
Des lignes, écrites par un processus Python open source, sans jamais démarrer de warehouse Snowflake. Les octets sont dans votre bucket. La gouvernance est celle de Snowflake. Élégant.
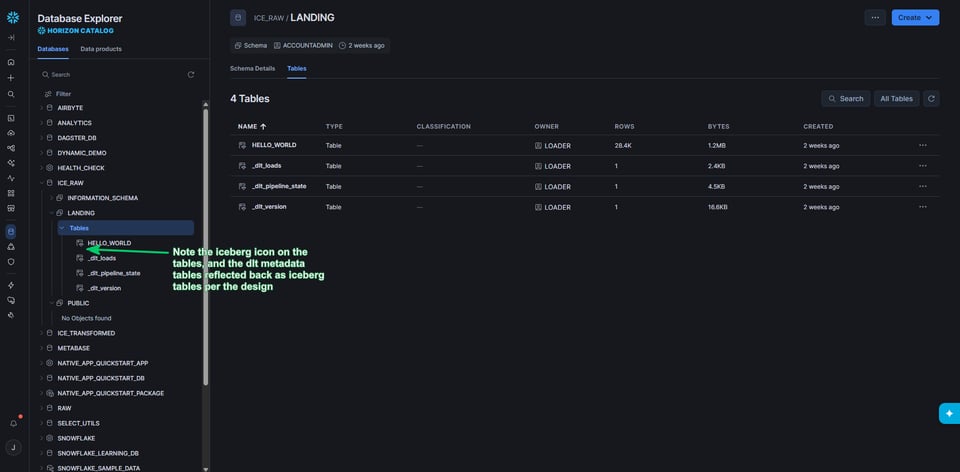
Bonus du Pilier 1 :
Pour la science, j'ai décidé de planifier le job EL sur la nouvelle plateforme SaaS de dltHub, dltHub Pro. Je mesure l'inutilité de planifier un job qui écrit les mots "hello" et "world" dans Snowflake, mais face à un nouveau jouet tout brillant, je n'ai pas pu résister.
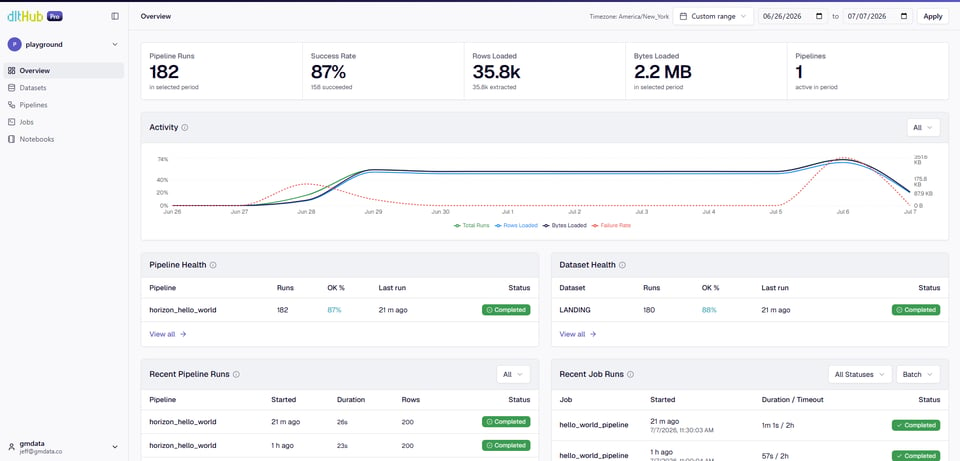
Le pipeline tourne désormais depuis deux semaines, toutes les 30 minutes pendant les heures ouvrées. Il a été exécuté environ 200 fois et a coûté environ 2 $ jusqu'ici. (Les catalogues REST sont notoirement lents, donc l'essentiel de cette somme a été dépensé à attendre.)
Pilier 2 : transformer, sans compute Snowflake
Cette partie est la plus enthousiasmante, car elle était encore impossible il y a une semaine.
La transformation est assurée par dbt, avec DuckDB qui fait le travail. DuckDB attache le catalogue REST Horizon deux fois : ICE_RAW pour lire ce que dlt a déposé, ICE_TRANSFORMED pour écrire le résultat. Il lit, exécute votre SQL et écrit une toute nouvelle table Iceberg gérée par Snowflake, directement via le catalogue. Sans tour de passe-passe.
Ce qui l'a débloqué : DuckDB 1.5.4 a livré un ensemble d'options de compatibilité d'écriture Iceberg-REST (duckdb-iceberg#1017), et dbt Fusion (preview.194+) les expose dans catalogs.yml v2. Quatre options apprennent à DuckDB à committer exactement dans la forme qu'Horizon accepte. Voici la configuration du catalogue ; la cible d'écriture porte toute la magie :
# dbt/catalogs.yml
catalogs:
  - name: ice_raw          # READ
    type: iceberg_rest
    table_format: iceberg
    config:
      duckdb:
        endpoint: " env_var('HORIZON_CATALOG_URI') "
        warehouse: ICE_RAW          # = the Snowflake database
        secret: horizon
        attach_as: ice_raw
        access_delegation_mode: VENDED_CREDENTIALS

  - name: ice_transformed  # WRITE
    type: iceberg_rest
Déplier le code
Activez le projet avec le flag catalogs v2, et liez votre modèle de staging au catalogue d'écriture :
# dbt/dbt_project.yml
flags:
  use_catalogs_v2: true

models:
  horizon_iceberg:
    staging:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: STAGING
    marts:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: MARTS
Ces valeurs +schema: placent chaque modèle dans son propre namespace Iceberg (STAGING, MARTS) au sein d'ICE_TRANSFORMED. Comme avec un usage classique de dbt, vous ne pré-créez pas les schémas : dbt exécute create schema if not exists avant chaque modèle (comme d'habitude), DuckDB-iceberg le traduit en création de namespace auprès du catalogue REST Horizon, détenu par le rôle transformer qui l'a créé.
💡Gardez les noms de schémas en majuscules. Comme duckdb gère la création des schémas, vous ne bénéficiez pas du comportement de Snowflake sur les identifiants non quotés.
Dans le repo, vous trouverez un modèle de staging basique qui montre simplement que nous pouvons faire un CTAS vers une nouvelle table dans un autre schéma à partir de la table ice_raw. Ainsi qu'un ensemble de requêtes marts, juste pour démontrer l'usage de plusieurs schémas.
Voici les tables marts dans Snowflake, détenues par le rôle transformer :
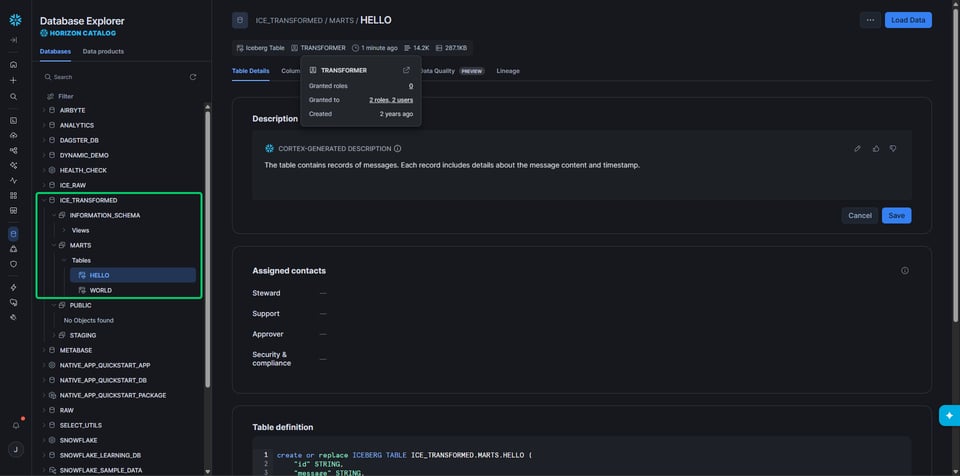
Si nous voulons la preuve que ces tables écrites par dbt sont de vrais commits de catalogue et non une astuce locale, nous pouvons les relire depuis un moteur complètement différent : pyiceberg ou duckdb, directement depuis le catalogue. (Le repo inclut aussi un ensemble de requêtes duckdb pour lire les tables depuis Horizon.)
import os
from pyiceberg.catalog.rest import RestCatalog
cat = RestCatalog("h", uri=os.environ["HORIZON_CATALOG_URI"], warehouse="ICE_TRANSFORMED",
    credential=os.environ["HORIZON_PAT"], scope="session:role:TRANSFORMER",
    **{"header.X-Iceberg-Access-Delegation": "vended-credentials"})
t = cat.load_table(("STAGING", "stg_hello_world")).scan().to_arrow()
print(t.num_rows, "rows")
Pour vérifier directement depuis Duckdb, lancez Duckdb dans le terminal, puis :
INSTALL iceberg;

LOAD iceberg;

-- see repo, it will tell you how to generate the token
CREATE OR REPLACE SECRET horizon (
    TYPE ICEBERG,
    TOKEN getenv('HORIZON_TOKEN')
);

-- 3. Attach the Snowflake-managed Iceberg catalog. warehouse = database name (ICE_RAW).
ATTACH 'ICE_RAW' AS horizon (
    TYPE ICEBERG,
    ENDPOINT 'https://myorg-myacct.snowflakecomputing.com/polaris/api/catalog',
    SECRET horizon
Déplier le code
Un modèle écrit dans dbt, exécuté par DuckDB, déposé comme Iceberg gouverné dans Snowflake, et relu par pyiceberg. Trois moteurs, une table, un catalogue. C'est le lakehouse ouvert qui fonctionne comme promis.
💡Si vous ne pouvez pas encore exécuter Fusion, la même écriture native fonctionne avec dbt-core standard + dbt-duckdb, moyennant une petite materialization personnalisée. Le repo la fournit en solution de repli dans dbt/macros-duckdb/, avec les deux pièges propres à dbt-core documentés (dbt-duckdb ignore silencieusement les options d'attach booléennes à false ; et l'ajout de données nécessite un commit explicite). Fusion gère les deux pour vous, et c'est pourquoi il constitue la voie mise en avant.
Pilier 3 : servir l'IA et la BI, avec gouvernance
Ce sont des tables gérées par Snowflake, donc le Pilier 3 peut rester très court. Tout ce que vous faites déjà dans Snowflake fonctionne : politiques d'accès aux lignes, masquage de colonnes, tags d'objets, lignage, fonctions Cortex, vues sémantiques, agents, outils BI. Aucune configuration Iceberg particulière n'est requise.
Plus simple que DuckLake ?
Il y a quelques semaines, j'ai partagé une démo bien accueillie sur la simplicité de DuckLake. Mais oserais-je dire qu'Iceberg sur Horizon est encore plus simple ?
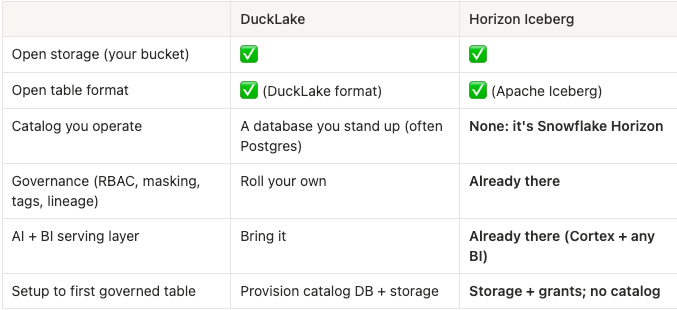
DuckLake Horizon Iceberg Stockage ouvert (votre bucket) ✅ ✅ Format de table ouvert ✅ (format DuckLake) ✅ (Apache Iceberg) Catalogue à opérer Une base de données à déployer (souvent Postgres) Aucun : c'est Snowflake Horizon Gouvernance (RBAC, masquage, tags, lignage) À construire vous-même Déjà là Couche de service IA + BI À apporter Déjà là (Cortex + n'importe quel outil BI) Mise en place jusqu'à la première table gouvernée Provisionner la base du catalogue + le stockage Stockage + grants ; pas de catalogue
La ligne du catalogue résume tout. Avec DuckLake, vous provisionnez et bichonnez la base de métadonnées. Ici, non, parce que la base de métadonnées, c'est Horizon, et vous n'avez pas construit Horizon : vous avez acheté Snowflake, et il était livré avec.
C'est cette sensation de simplicité déconcertante que les gens décrivent sans cesse. Ce n'est pas que le lakehouse soit devenu plus puissant. C'est que la pièce la plus difficile (un catalogue gouverné et digne de confiance) s'est révélée être celle que vous n'avez pas à fabriquer.
Essayez par vous-même
Le repo complet et reproductible est ici. Le chemin rapide, tel que décrit dans le readme :
# 1. Foundation: your storage + Snowflake grants (one time)
cd tf/aws && terraform init && terraform apply
cd ../snowflake && terraform init && terraform apply
snow sql -f sql/horizon_access.sql --role ACCOUNTADMIN

# 2. Load: no Snowflake compute
cd dlt && uv run python hello_world_pipeline.py

# 3. Transform: no Snowflake compute
cd ../dbt && dbt system update && dbt run   # dbt Fusion >= preview.194

# 4. Serve: governed, from Snowflake
snow sql -q "SELECT * FROM ICE_TRANSFORMED.STAGING.STG_HELLO_WORLD"
Pour conclure
Des données ouvertes dans votre bucket. Un catalogue que vous n'avez pas eu à construire. Des chargements et des transformations qui ne consomment pas de temps de warehouse. Et à la seconde où ces données existent, elles portent toute la gouvernance de Snowflake (le RBAC, le masquage, les tags, le lignage, l'IA), parce que pour Snowflake, elles n'ont jamais été "externes".
dbt embrasse l'Open Data Infrastructure (oui, encore un nouveau buzzword pour vous) et prend des mesures pour rendre dbt plus compatible avec cette vision.
Maintenant, essayez par vous-même et dites-moi si Iceberg vous semble enfin moins complexe et moins intimidant !
Frequently asked
questions
Opérationnel en moins de 15 minutes
Connectez votre compte Snowflake, Databricks ou BigQuery et visualisez instantanément votre potentiel d'économies.