

TL;DR
Der Iceberg REST Catalog von Snowflake Horizon ermöglicht es, Daten als governed Iceberg Tables zu laden und zu transformieren – ganz ohne Snowflake-Compute. dlt schreibt Rohdaten über eine Open-Source-Pipeline nach Iceberg, dbt Fusion mit DuckDB transformiert sie, und beide committen direkt über den Catalog von Snowflake, ohne jemals ein Warehouse zu starten. Sobald die Daten landen, unterliegen sie vollständig der Governance von Snowflake: RBAC, Masking, Lineage, Tags, Cortex. Möglich wurde das Ende Juni 2026, als DuckDB 1.5.4, dbt Fusion preview.194+ und der External-Write-Support von Snowflake Horizon gleichzeitig erschienen.
Auf dem Snowflake Summit 2026 verkündete Snowflake, die breiteste Unterstützung für Iceberg V3 zu bieten – als erster vollständig offener Catalog, der externe Lese- und Schreibzugriffe auf Iceberg ermöglicht, inklusive Deletion Vectors, Row Lineage, Variant Type und Default Values. Das musste ich natürlich auf die Probe stellen.
Der Aspekt der "external writes" ermöglicht – zusammen mit einigen jüngsten Entwicklungen bei dbt und DuckDB – eine Version des Lakehouse, die ich für meine Kunden schon lange bauen wollte und die bis Ende Juni 2026 schlicht nicht möglich war. Sie sieht so aus: Ihre Tabellen liegen in Ihrem eigenen Cloud-Storage, in einem offenen Format, mit einem Catalog, der keinerlei Verwaltung erfordert, schnell eingerichtet ist, sich einfach lesen und beschreiben lässt, von jeder Engine gelesen und von anderen Engines wie DuckDB beschrieben werden kann. Und trotzdem unterliegen diese Tabellen weiterhin der Governance von Snowflake: ein Catalog, ein Satz an Grants, ein Ort, an dem Masking, Lineage und Tags zu Hause sind. Offener Storage unten, echte Governance + Snowflake AI oben.
- Laden Sie Rohdaten als Apache Iceberg in Ihren eigenen S3-Bucket – ohne laufendes Snowflake-Warehouse.
- Transformieren Sie sie mit dbt in eine neue Iceberg Table. Auch hier: kein laufendes Snowflake-Warehouse.
- Stellen Sie sie für AI und BI bereit – mit dem kompletten Governance-Stack von Snowflake: RBAC, Masking Policies, Row-Access Policies, Tags, Lineage, Cortex.
Möglich macht das der Iceberg REST Catalog von Snowflake Horizon. Externe Engines (dlt, DuckDB, dbt auf Ihrem Laptop oder in einem kleinen Container) schreiben Snowflake-managed Iceberg Tables direkt über diese API. Snowflake besitzt den Catalog, stellt zur Schreibzeit eingeschränkte S3-Credentials aus, und Ihre Engine übernimmt das eigentliche Compute. Heraus kommt eine vollwertige governed Table. Keine External Table, die Snowflake nur argwöhnisch beäugt – eine echte. Und der Catalog ist bereits da. Sie richten ihn nicht ein. Sie schalten ihn nicht ein. Er kam mit Snowflake.
Der Transform-Schritt ist der neueste Teil dieses Stacks – der Rest war schon vorher möglich. Nötig waren drei konkrete Releases, die alle gleichzeitig erschienen: DuckDB 1.5.4 brachte die Write-Compat-Optionen, mit denen DuckDB Iceberg über einen REST Catalog zurück committen kann, dbt Fusion preview.194+ machte diese Optionen in catalogs.yml v2 verfügbar, und Snowflake Horizon vervollständigte seinen External-Engine-Write-Pfad über die Iceberg REST Catalog API. Wer das vor dem 30. Juni 2026 (Release von Fusion 194) versucht hat: Der Write schlug schlicht fehl.
Was "Iceberg REST Catalog" hier wirklich bedeutet
Kurz zur Begriffsklärung. Apache Iceberg ist das offene Tabellenformat, mit dem Sie Parquet-Dateien wie Tabellen lesen und schreiben können (select, insert usw.) – plus ein Metadaten-Baum, der ACID-Commits, Schema Evolution und Time Travel mitbringt. Der REST Catalog ist die offene API-Spezifikation, die einer Engine sagt, wo die aktuellen Metadaten liegen, und SQL-Commits koordiniert.
Snowflake Horizon implementiert diese REST Catalog API und verweist damit auf Snowflake-managed Iceberg Tables. Wenn DuckDB oder dlt also das Iceberg-REST-Protokoll spricht, antwortet Snowflake – als Catalog. Der Endpoint sieht so aus:
1https://<your-account>.snowflakecomputing.com/polaris/api/catalog
Zwei Dinge sollten Sie verinnerlichen:
- Im REST-Catalog-Jargon ist der
warehouseIhre Snowflake-Datenbank (in unserem Beispiel unten heißt sieICE_RAW), nicht ein Virtual Warehouse. Das Wortwarehouseimpliziert in diesem Fall also kein Compute. - Die Authentifizierung ist ein OAuth2 Token Exchange. Sie übergeben Horizon ein Snowflake Programmatic Access Token (PAT) als
client_secret, mit einem Scope wiesession:role:TRANSFORMER, und erhalten im Gegenzug ein kurzlebiges Bearer Token. Ihre Rolle – samt aller daran hängenden Grants – reist auf diesem Token mit.
Der zweite Punkt ist die komplette Governance-Story in einem Satz: Der Catalog vergibt Zugriff nach Snowflake-Rolle. Merken Sie sich das – es kommt im Abschnitt "Bereitstellen" wieder.
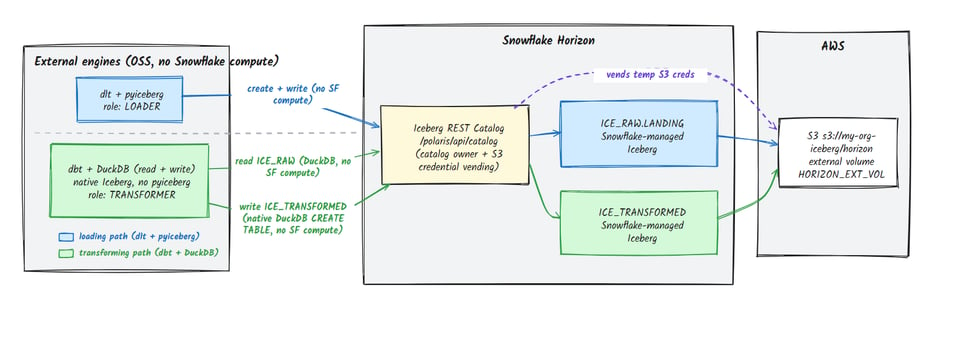
Die Architektur auf einen Blick
Kein einziger Pfeil von einer Engine in den Catalog benötigt Snowflake-Compute. Die Engines erledigen die Arbeit; Horizon übernimmt Governance und Vermittlung. Die Daten liegen die ganze Zeit in Ihrem Bucket.
Das einmalige Fundament (und warum es nicht der Catalog ist)
Das Setup ist überraschend einfach. Snowflake hat fast die gesamte Komplexität rund um die Einrichtung des Iceberg Catalog beseitigt. Folgendes müssen Sie aufsetzen:
- Wo die Daten liegen. Ein S3-Bucket und ein Snowflake-External Volume, das darauf zeigt, mit einer IAM-Rolle, die Snowflake annimmt. Das ist der "Ihr Storage, Ihr Bucket"-Teil des offenen Lakehouse.
- Wer darauf zugreifen darf. Ein paar Snowflake-Rollen und ein Service User mit Programmatic Access Tokens. Das ist schlicht Snowflake RBAC – das kennen Sie bereits.
Das Begleit-Repo erledigt all das mit Terraform + etwas SQL, Sie können also jede Zeile nachlesen. Storage:
# tf/snowflake: the external volume + Iceberg-by-default databases
resource "snowflake_external_volume" "horizon" {
  name = "HORIZON_EXT_VOL"
  storage_location {
    storage_location_name = "horizon-s3"
    storage_provider      = "S3"
    storage_base_url      = "s3://my-org-iceberg/horizon/"
    storage_aws_role_arn  = aws_iam_role.snowflake.arn
  }
}

resource "snowflake_database" "ice_raw" {
  name   = "ICE_RAW"
  external_volume = snowflake_external_volume.horizon.name
  catalog  = "SNOWFLAKE"   # Snowflake-managed Iceberg
Code aufklappen
Zugriff: schlichtes RBAC, zwei Rollen, ein Service User, der sie hält.
-- sql/horizon_access.sql (abridged)
CREATE ROLE IF NOT EXISTS LOADER;       -- writes ICE_RAW
CREATE ROLE IF NOT EXISTS TRANSFORMER;  -- reads ICE_RAW, writes ICE_TRANSFORMED

GRANT USAGE ON DATABASE ICE_RAW TO ROLE TRANSFORMER;
GRANT USAGE ON SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON ALL ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON FUTURE ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;

GRANT USAGE ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;
GRANT CREATE SCHEMA ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;

CREATE USER IF NOT EXISTS HORIZON_SVC TYPE = SERVICE;
GRANT ROLE LOADER, TRANSFORMER TO USER HORIZON_SVC;
Anschließend stellen Sie die Tokens aus. Jede Engine erhält ein PAT, das auf genau eine Rolle beschränkt ist – Least Privilege von Haus aus:
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_LOAD_PAT DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='LOADER'      COMMENT='dlt loader'"      --role ACCOUNTADMIN
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_PAT      DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='TRANSFORMER' COMMENT='dbt transformer'" --role ACCOUNTADMIN
Das war's. Das ist das Fundament. Storage, den Sie besitzen, Rollen, die Sie vergeben. Nirgendwo haben Sie dabei einen Catalog gebaut, denn der Catalog ist Horizon – und Horizon ist einfach… an.
💡Ein echter Stolperstein, der Ihnen eine Stunde ersparen kann: Der Hostname verwendet einen Bindestrich, keinen Unterstrich. Es heißt myorg-myacct.snowflakecomputing.com, und Pythons ssl lehnt die Variante mit Unterstrich ab. curl toleriert sie – es sieht also so aus, als würde alles funktionieren, bis Ihre Pipeline es nicht mehr tut.
Säule 1: Laden – ohne Snowflake-Compute
Der vollständige Code ist hier im Repo verfügbar. In diesem Beitrag greife ich der Lesbarkeit halber einige relevante Ausschnitte heraus.
Der Loader ist dlt mit seiner Open-Source-filesystem-Destination und table_format="iceberg", gerichtet auf den Horizon REST Catalog. Kein dlt+, kein lizenzierter Connector. dlt schreibt das Parquet und committet über den Catalog mit pyiceberg; Horizon stellt die S3-Credentials aus.
Die Catalog-Verbindung liegt in den Secrets von dlt, und der einzige Snowflake-spezifische Kniff ist dieser: Snowflake-managed Iceberg vergibt die Table Location selbst (unter Ihrem External Volume) und lehnt daher eine vom Client mitgelieferte Location ab. Wir wrappen dlts create_table, um sie wegzulassen:
import dlt
from dlt.destinations import filesystem
import dlt.common.libs.pyiceberg as _ice
import pyarrow as _pa

# Snowflake Horizon assigns the table location under the external volume and
# rejects a client-supplied one, so drop `location` on create. That's the
# intended external-write flow.
def _create_no_location(catalog, table_id, table_location, schema, **kw):
    if isinstance(schema, _pa.Schema):
        schema = _ice.ensure_iceberg_compatible_arrow_schema(schema)
    catalog.create_table(identifier=table_id, schema=schema,
                         partition_spec=kw.get("partition_spec", _ice.UNPARTITIONED_PARTITION_SPEC),
                         properties=kw.get("properties") or {})
_ice.create_table = _create_no_location
Code aufklappen
Ausführen:
1uv run python hello_world_pipeline.py
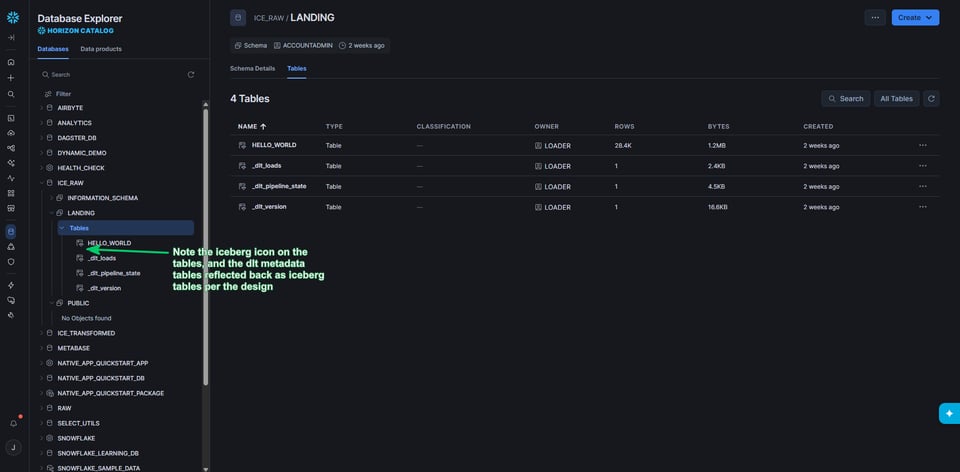
Und jetzt kommt der Moment. Gehen Sie zu Snowflake (jetzt dürfen Sie ein Warehouse verwenden, schließlich sind Sie ein Mensch, der eine Query ausführt) – und die Tabelle ist da: governed, abfragbar, vom Typ MANAGED:
1SELECT * FROM ICE_RAW.LANDING.HELLO_WORLD;
Zeilen, geschrieben von einem Open-Source-Python-Prozess, der nie ein Snowflake-Warehouse gestartet hat. Die Bytes liegen in Ihrem Bucket. Die Governance kommt von Snowflake. Großartig.
Bonus zu Säule 1:
Der Wissenschaft zuliebe habe ich den EL-Job auf dltHubs neuer SaaS-Plattform dltHub Pro eingeplant. Mir ist klar, wie sinnlos es ist, einen Job zu schedulen, der die Wörter "hello" und "world" nach Snowflake schreibt – aber bei neuem, glänzendem Spielzeug konnte ich einfach nicht widerstehen.
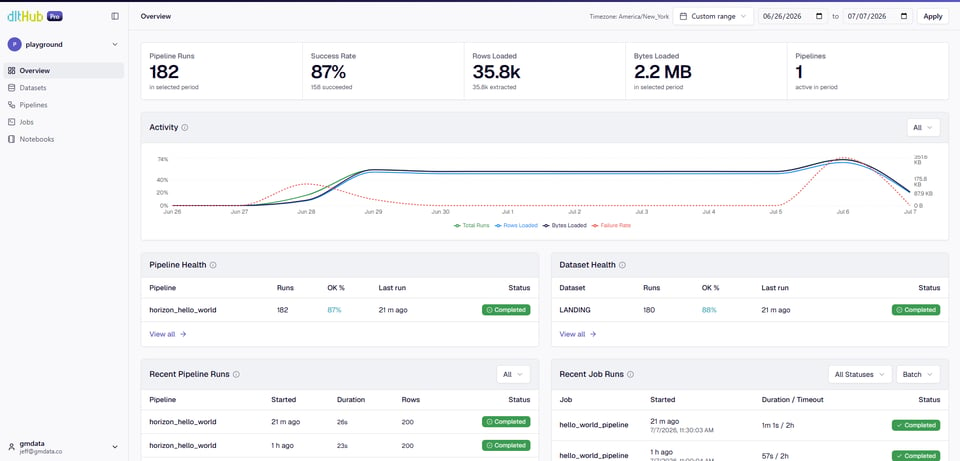
Die Pipeline läuft nun seit zwei Wochen, alle 30 Minuten während der Geschäftszeiten. Sie wurde etwa 200-mal ausgeführt und hat bisher rund 2 $ gekostet. (REST Catalogs sind notorisch langsam, der Großteil des Geldes ging also fürs Warten drauf.)
Säule 2: Transformieren – ohne Snowflake-Compute
Dieser nächste Teil ist der spannendste, denn vor einer Woche war er noch nicht möglich.
Der Transformer ist dbt, wobei DuckDB die Arbeit erledigt. DuckDB bindet den Horizon REST Catalog zweimal ein: ICE_RAW, um zu lesen, was dlt abgelegt hat, und ICE_TRANSFORMED, um das Ergebnis zu schreiben. Es liest, führt Ihr SQL aus und schreibt eine brandneue Snowflake-managed Iceberg Table direkt über den Catalog zurück. Keine Tricks, keine Taschenspielerei.
So wurde das möglich: DuckDB 1.5.4 lieferte eine Reihe von Iceberg-REST-Write-Compat-Optionen (duckdb-iceberg#1017), und dbt Fusion (preview.194+) macht sie in catalogs.yml v2 verfügbar. Vier Optionen bringen DuckDB bei, exakt in der Form zu committen, die Horizon akzeptiert. Hier die Catalog-Konfiguration; die Magie steckt im Write-Target:
# dbt/catalogs.yml
catalogs:
  - name: ice_raw          # READ
    type: iceberg_rest
    table_format: iceberg
    config:
      duckdb:
        endpoint: " env_var('HORIZON_CATALOG_URI') "
        warehouse: ICE_RAW          # = the Snowflake database
        secret: horizon
        attach_as: ice_raw
        access_delegation_mode: VENDED_CREDENTIALS

  - name: ice_transformed  # WRITE
    type: iceberg_rest
Code aufklappen
Aktivieren Sie das Projekt mit dem Catalogs-v2-Flag und binden Sie Ihr Staging-Modell an den Write-Catalog:
# dbt/dbt_project.yml
flags:
  use_catalogs_v2: true

models:
  horizon_iceberg:
    staging:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: STAGING
    marts:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: MARTS
Diese +schema:-Werte legen jedes Modell in seinem eigenen Iceberg-Namespace (STAGING, MARTS) innerhalb von ICE_TRANSFORMED ab. Wie bei der normalen Nutzung von dbt müssen Sie Schemata nicht vorab anlegen: dbt führt vor jedem Modell create schema if not exists aus (wie gewohnt), DuckDB-Iceberg übersetzt das in einen Namespace-Create gegen den Horizon REST Catalog – im Besitz der transformer-Rolle, die ihn erstellt hat.
💡Halten Sie die Schema-Namen in Großbuchstaben. Da duckdb die Schema-Erstellung übernimmt, greift das Snowflake-Verhalten für Unquoted Identifiers hier nicht.
Im Repo finden Sie ein einfaches Staging-Modell, das lediglich zeigt, dass wir per CTAS eine neue Tabelle in einem anderen Schema auf Basis der ice_raw-Tabelle erstellen können. Dazu eine Reihe von marts-Queries, nur um zu demonstrieren, wie sich mehrere Schemata nutzen lassen.
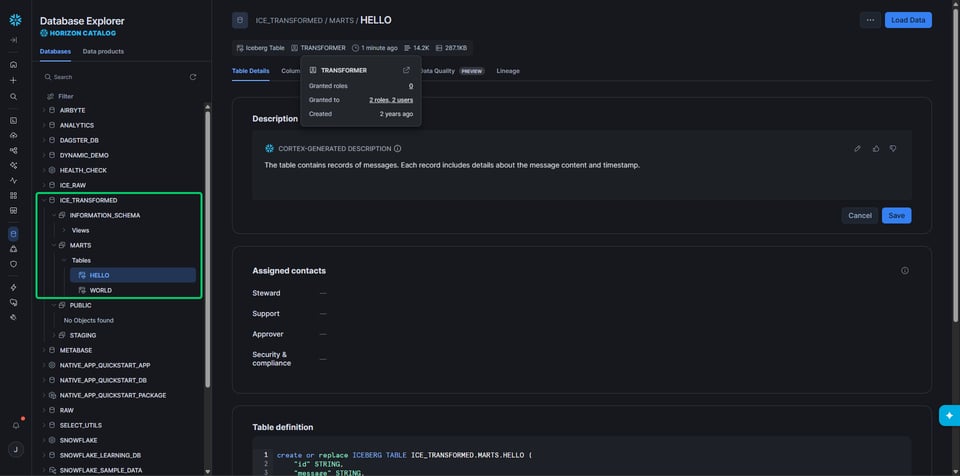
Hier die marts-Tabellen in Snowflake, im Besitz der transformer-Rolle:
Wenn wir den Beweis wollen, dass diese von dbt geschriebenen Tabellen echte Catalog-Commits sind und kein lokaler Trick, lesen wir sie mit einer völlig anderen Engine zurück: pyiceberg oder duckdb direkt vom Catalog. (Das Repo enthält außerdem eine Reihe von duckdb-Queries, um die Tabellen aus Horizon zu lesen.)
import os
from pyiceberg.catalog.rest import RestCatalog
cat = RestCatalog("h", uri=os.environ["HORIZON_CATALOG_URI"], warehouse="ICE_TRANSFORMED",
    credential=os.environ["HORIZON_PAT"], scope="session:role:TRANSFORMER",
    **{"header.X-Iceberg-Access-Delegation": "vended-credentials"})
t = cat.load_table(("STAGING", "stg_hello_world")).scan().to_arrow()
print(t.num_rows, "rows")
Um direkt aus Duckdb zu prüfen, starten Sie Duckdb im Terminal und dann:
INSTALL iceberg;

LOAD iceberg;

-- see repo, it will tell you how to generate the token
CREATE OR REPLACE SECRET horizon (
    TYPE ICEBERG,
    TOKEN getenv('HORIZON_TOKEN')
);

-- 3. Attach the Snowflake-managed Iceberg catalog. warehouse = database name (ICE_RAW).
ATTACH 'ICE_RAW' AS horizon (
    TYPE ICEBERG,
    ENDPOINT 'https://myorg-myacct.snowflakecomputing.com/polaris/api/catalog',
    SECRET horizon
Code aufklappen
Ein Modell, geschrieben in dbt, ausgeführt von DuckDB, gelandet als governed Iceberg in Snowflake und zurückgelesen von pyiceberg. Drei Engines, eine Tabelle, ein Catalog. Das offene Lakehouse – genau so, wie es versprochen wurde.
💡Wenn Sie Fusion noch nicht einsetzen können: Derselbe native Write funktioniert auch mit Standard-dbt-core + dbt-duckdb und einer winzigen Custom Materialization. Das Repo liefert sie als Fallback in dbt/macros-duckdb/ mit, inklusive der zwei dbt-core-spezifischen Stolperfallen (dbt-duckdb verwirft stillschweigend Attach-Optionen mit dem Boolean-Wert false; und der Data-Append braucht einen expliziten Commit). Fusion erledigt beides für Sie – deshalb ist es hier der empfohlene Weg.
Säule 3: Governed für AI und BI bereitstellen
Es handelt sich um Snowflake-managed Tables, daher können wir Säule 3 sehr kurz halten. Alles, was Sie in Snowflake ohnehin tun, funktioniert: Row-Access Policies, Column Masking, Object Tags, Lineage, Cortex-Funktionen, Semantic Views, Agents, BI-Tools. Keine spezielle Iceberg-Konfiguration nötig.
Einfacher als DuckLake?
Vor einigen Wochen habe ich eine gut aufgenommene Demo darüber geteilt, wie einfach DuckLake ist. Aber ich wage zu behaupten: Iceberg auf Horizon ist sogar noch einfacher.
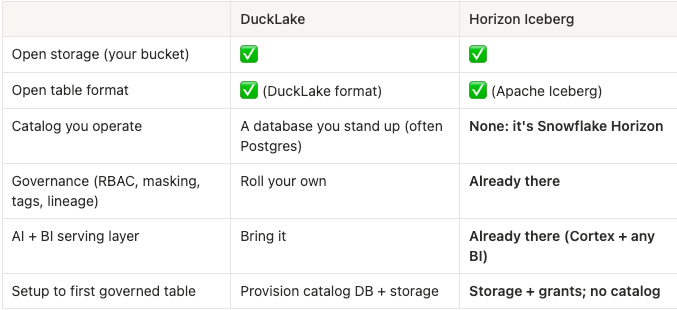
DuckLake Horizon Iceberg Offener Storage (Ihr Bucket) ✅ ✅ Offenes Tabellenformat ✅ (DuckLake-Format) ✅ (Apache Iceberg) Catalog, den Sie selbst betreiben Eine Datenbank, die Sie aufsetzen (oft Postgres) Keiner: es ist Snowflake Horizon Governance (RBAC, Masking, Tags, Lineage) Selbst bauen Bereits vorhanden AI- + BI-Serving-Layer Selbst mitbringen Bereits vorhanden (Cortex + beliebiges BI-Tool) Setup bis zur ersten governed Table Catalog-DB + Storage provisionieren Storage + Grants; kein Catalog
Die Catalog-Zeile ist die ganze Geschichte. Bei DuckLake provisionieren und betreuen Sie die Metadaten-Datenbank selbst. Hier nicht – denn die Metadaten-Datenbank ist Horizon, und Horizon haben Sie nicht gebaut; Sie haben Snowflake gekauft, und Horizon war einfach dabei.
Genau das ist dieses "einfacher geht es kaum"-Gefühl, das viele beschreiben. Nicht das Lakehouse ist mächtiger geworden. Sondern der schwierigste Teil (ein vertrauenswürdiger, governed Catalog) hat sich als der Teil entpuppt, den Sie gar nicht bauen müssen.
Probieren Sie es aus
Das vollständige, reproduzierbare Repo finden Sie hier. Der schnelle Weg laut Readme:
# 1. Foundation: your storage + Snowflake grants (one time)
cd tf/aws && terraform init && terraform apply
cd ../snowflake && terraform init && terraform apply
snow sql -f sql/horizon_access.sql --role ACCOUNTADMIN

# 2. Load: no Snowflake compute
cd dlt && uv run python hello_world_pipeline.py

# 3. Transform: no Snowflake compute
cd ../dbt && dbt system update && dbt run   # dbt Fusion >= preview.194

# 4. Serve: governed, from Snowflake
snow sql -q "SELECT * FROM ICE_TRANSFORMED.STAGING.STG_HELLO_WORLD"
Fazit
Offene Daten in Ihrem Bucket. Ein Catalog, den Sie nicht bauen mussten. Loads und Transformationen, die keine Warehouse-Zeit verbrennen. Und in der Sekunde, in der die Daten existieren, tragen sie die komplette Governance von Snowflake (RBAC, Masking, Tags, Lineage, AI) – denn für Snowflake waren sie nie "extern".
dbt setzt auf Open Data Infrastructure (ja, ein neues Buzzword für Sie) und arbeitet daran, dbt mit dieser Vision noch kompatibler zu machen.
Probieren Sie es jetzt aus – und lassen Sie mich wissen, ob sich Iceberg jetzt nicht mehr kompliziert und einschüchternd anfühlt!
Frequently asked
questions
In weniger als 15 Minuten startklar
Verbinden Sie Ihr Snowflake-, Databricks- oder BigQuery-Konto und erkennen Sie sofort Ihr Einsparpotenzial.