

TLDR
O Iceberg REST Catalog do Snowflake Horizon permite carregar e transformar dados como tabelas Iceberg governadas usando zero compute do Snowflake. O dlt grava os dados brutos em Iceberg usando um pipeline open source, o dbt Fusion com DuckDB os transforma, e ambos fazem commit diretamente pelo catálogo do Snowflake sem nunca iniciar um warehouse. No momento em que os dados chegam, eles já estão totalmente governados pelo Snowflake: RBAC, masking, linhagem, tags, Cortex. Isso se tornou possível no fim de junho de 2026, quando o DuckDB 1.5.4, o dbt Fusion preview.194+ e o suporte a escrita externa do Snowflake Horizon foram lançados juntos.
No Snowflake Summit 2026, a Snowflake afirmou ter o suporte mais amplo ao Iceberg V3, sendo o primeiro catálogo totalmente aberto a habilitar leituras e escritas externas no Iceberg, incluindo deletion vectors, row lineage, tipo variant e valores padrão. Então, eu tinha que colocar isso à prova.
O aspecto das "escritas externas", somado a alguns avanços recentes do dbt e do DuckDB, viabiliza uma versão do lakehouse que eu queria construir para meus clientes e que não era possível até o fim de junho de 2026. Funciona assim: suas tabelas vivem no seu próprio cloud storage, em um formato aberto, com um catálogo que exige zero gerenciamento, fácil de subir, simples de ler e escrever, legível por qualquer engine e gravável por outras engines, como o DuckDB. Mas essas tabelas continuam governadas pelo Snowflake: um catálogo, um conjunto de grants, um só lugar onde vivem masking, linhagem e tags. Armazenamento aberto embaixo, governança de verdade + IA do Snowflake em cima.
- Carregue os dados brutos como Apache Iceberg no seu próprio bucket S3, sem nenhum warehouse do Snowflake rodando.
- Transforme-os em uma nova tabela Iceberg usando dbt. De novo: nenhum warehouse do Snowflake rodando.
- Sirva-os para IA e BI com a stack completa de governança do Snowflake: RBAC, políticas de masking, políticas de acesso por linha, tags, linhagem, Cortex.
O que torna isso possível é o Iceberg REST Catalog do Snowflake Horizon. Engines externas (dlt, DuckDB, dbt rodando no seu laptop ou em um container minúsculo) escrevem tabelas Iceberg gerenciadas pelo Snowflake diretamente por essa API. O Snowflake é dono do catálogo, fornece credenciais S3 com escopo no momento da escrita, e a sua engine faz o compute de verdade. O que sai do outro lado é uma tabela governada de primeira classe. Não uma tabela externa que o Snowflake olha de soslaio. Uma tabela de verdade. E o catálogo já está lá. Você não configura. Você não liga. Ele veio com o Snowflake.
A etapa de transformação é a parte mais recente dessa stack, já que o restante já era possível antes. Foram necessárias três releases específicas chegando ao mesmo tempo: o DuckDB 1.5.4 adicionou as opções de compatibilidade de escrita que permitem ao DuckDB fazer commit de Iceberg de volta por um catálogo REST, o dbt Fusion preview.194+ expôs essas opções no catalogs.yml v2, e o Snowflake Horizon completou seu caminho de escrita por engines externas via API do Iceberg REST Catalog. Se você tentou isso antes de 30 de junho de 2026 (release do Fusion 194), a escrita simplesmente falhava.
O que "Iceberg REST Catalog" realmente significa aqui
Um rápido alinhamento de vocabulário. O Apache Iceberg é o formato aberto de tabela que permite ler e escrever arquivos parquet como tabelas (select, insert etc.), além de uma árvore de metadados que oferece commits ACID, evolução de schema e time travel. O REST Catalog é a especificação aberta de API que diz a uma engine onde estão os metadados atuais e coordena os commits SQL.
O Snowflake Horizon implementa essa API de REST Catalog e a aponta para tabelas Iceberg gerenciadas pelo Snowflake. Então, quando o DuckDB ou o dlt fala o protocolo Iceberg REST, o Snowflake responde, como catálogo. O endpoint fica assim:
1https://<your-account>.snowflakecomputing.com/polaris/api/catalog
Duas coisas para internalizar:
- Na linguagem do catálogo REST, o
warehouseé o seu database do Snowflake (no nosso exemplo abaixo, o chamamos deICE_RAW), e não um virtual warehouse. Nesse caso, a palavrawarehousenão implica nenhum compute. - A autenticação é uma troca de tokens OAuth2. Você entrega ao Horizon um Programmatic Access Token (PAT) do Snowflake como
client_secret, com um escopo comosession:role:TRANSFORMER, e ele devolve um bearer token de curta duração. Sua role, e todos os grants associados a ela, viajam juntos nesse token.
Esse segundo ponto resume toda a história de governança em uma frase: o catálogo concede acesso por role do Snowflake. Guarde essa ideia; ela volta na seção de "servir".
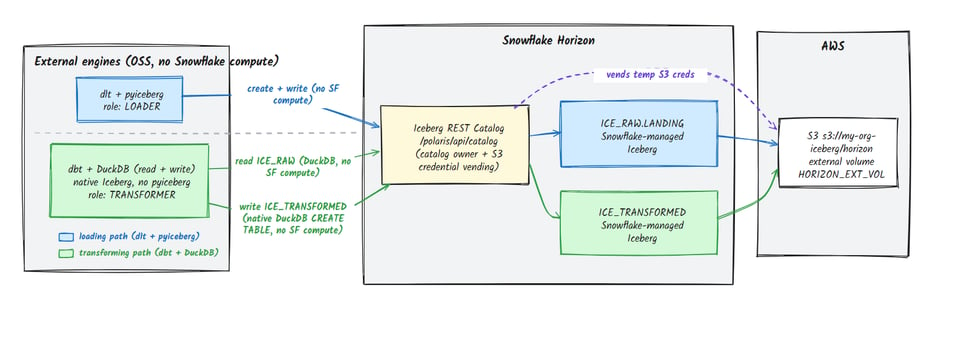
A arquitetura, em uma única tela
Cada seta de uma engine para o catálogo envolve zero compute do Snowflake. As engines fazem o trabalho; o Horizon governa e intermedeia. Os dados ficam no seu bucket o tempo todo.
A base configurada uma única vez (e por que ela não é o catálogo)
A configuração necessária é surpreendentemente fácil. O Snowflake removeu quase toda a complexidade de configurar o Iceberg Catalog. Aqui está o que você precisa configurar.
- Onde os dados vivem. Um bucket S3 e um external volume do Snowflake apontando para ele, com uma role do IAM que o Snowflake assume. Essa é a parte "seu storage, seu bucket" do lakehouse aberto.
- Quem pode tocar neles. Algumas roles do Snowflake e um usuário de serviço com Programmatic Access Tokens. Isso é só RBAC do Snowflake. Você já conhece.
O repositório que acompanha este post faz tudo isso com Terraform + um pouco de SQL, então você pode ler cada linha. Storage:
# tf/snowflake: the external volume + Iceberg-by-default databases
resource "snowflake_external_volume" "horizon" {
  name = "HORIZON_EXT_VOL"
  storage_location {
    storage_location_name = "horizon-s3"
    storage_provider      = "S3"
    storage_base_url      = "s3://my-org-iceberg/horizon/"
    storage_aws_role_arn  = aws_iam_role.snowflake.arn
  }
}

resource "snowflake_database" "ice_raw" {
  name   = "ICE_RAW"
  external_volume = snowflake_external_volume.horizon.name
  catalog  = "SNOWFLAKE"   # Snowflake-managed Iceberg
Expandir código
Acesso: RBAC puro, duas roles, um usuário de serviço que as detém.
-- sql/horizon_access.sql (abridged)
CREATE ROLE IF NOT EXISTS LOADER;       -- writes ICE_RAW
CREATE ROLE IF NOT EXISTS TRANSFORMER;  -- reads ICE_RAW, writes ICE_TRANSFORMED

GRANT USAGE ON DATABASE ICE_RAW TO ROLE TRANSFORMER;
GRANT USAGE ON SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON ALL ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON FUTURE ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;

GRANT USAGE ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;
GRANT CREATE SCHEMA ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;

CREATE USER IF NOT EXISTS HORIZON_SVC TYPE = SERVICE;
GRANT ROLE LOADER, TRANSFORMER TO USER HORIZON_SVC;
Depois, você emite os tokens. Cada engine recebe um PAT com escopo de exatamente uma role, com o princípio do menor privilégio já embutido:
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_LOAD_PAT DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='LOADER'      COMMENT='dlt loader'"      --role ACCOUNTADMIN
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_PAT      DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='TRANSFORMER' COMMENT='dbt transformer'" --role ACCOUNTADMIN
É isso. Essa é a base. Storage que é seu, roles que você concede. Em nenhum momento você construiu um catálogo, porque o catálogo é o Horizon, e o Horizon está simplesmente… ligado.
💡Uma pegadinha real que pode te poupar uma hora: o hostname usa hífen, não underscore. É myorg-myacct.snowflakecomputing.com, e o ssl do Python rejeita a forma com underscore. O curl tolera, então vai parecer que funciona, até o seu pipeline quebrar.
Pilar 1: Carregar, sem compute do Snowflake
O código completo está disponível no repositório aqui. Neste post, vou destacar alguns trechos relevantes para facilitar a leitura.
O loader é o dlt usando seu destino open source filesystem com table_format="iceberg", apontado para o catálogo REST do Horizon. Sem dlt+, sem conector licenciado. O dlt grava o parquet e faz commit pelo catálogo com pyiceberg; o Horizon fornece as credenciais S3.
A conexão com o catálogo vive nos secrets do dlt, e o único truque específico do Snowflake é este: o Iceberg gerenciado pelo Snowflake atribui a localização da tabela sozinho (sob o seu external volume), então ele rejeita uma localização fornecida pelo cliente. Encapsulamos o create_table do dlt para omiti-la:
import dlt
from dlt.destinations import filesystem
import dlt.common.libs.pyiceberg as _ice
import pyarrow as _pa

# Snowflake Horizon assigns the table location under the external volume and
# rejects a client-supplied one, so drop `location` on create. That's the
# intended external-write flow.
def _create_no_location(catalog, table_id, table_location, schema, **kw):
    if isinstance(schema, _pa.Schema):
        schema = _ice.ensure_iceberg_compatible_arrow_schema(schema)
    catalog.create_table(identifier=table_id, schema=schema,
                         partition_spec=kw.get("partition_spec", _ice.UNPARTITIONED_PARTITION_SPEC),
                         properties=kw.get("properties") or {})
_ice.create_table = _create_no_location
Expandir código
Execute:
1uv run python hello_world_pipeline.py
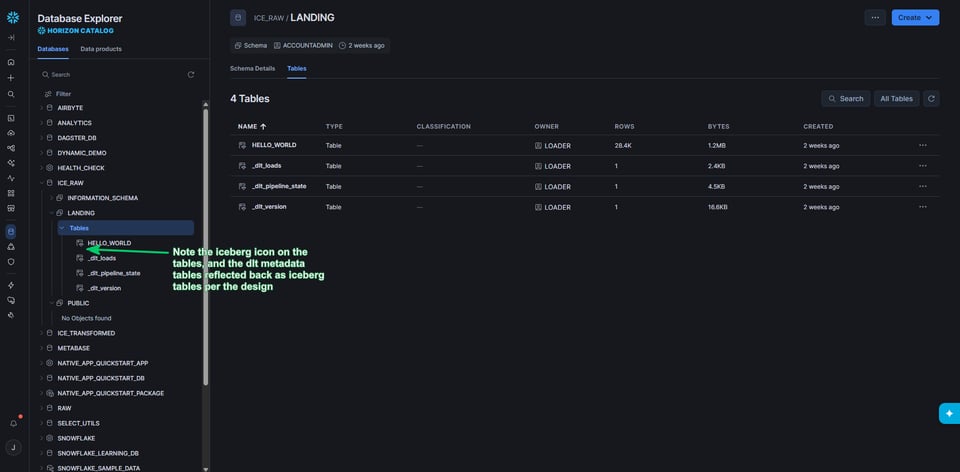
E aqui está o momento. Vá ao Snowflake (agora você pode usar um warehouse, porque você é um humano rodando uma query) e a tabela está bem ali, governada, consultável, do tipo MANAGED:
1SELECT * FROM ICE_RAW.LANDING.HELLO_WORLD;
Linhas escritas por um processo Python open source que nunca iniciou um warehouse do Snowflake. Os bytes estão no seu bucket. A governança é do Snowflake. Uma beleza.
Bônus do Pilar 1:
Em nome da ciência, decidi agendar o job de EL na nova plataforma SaaS da dltHub, o dltHub Pro. Eu sei o quanto é inútil agendar um job que escreve as palavras "hello" e "world" no Snowflake, mas brinquedo novo é brinquedo novo: não resisti.
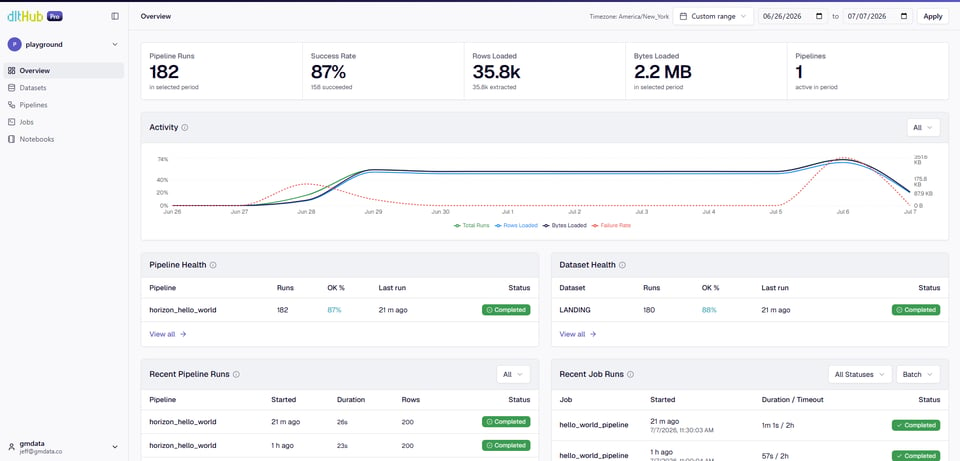
O pipeline está rodando há duas semanas, a cada 30 minutos em horário comercial. Ele já foi executado cerca de 200 vezes e custou cerca de US$ 2 até agora. (Catálogos REST são notoriamente lentos, então a maior parte desse dinheiro foi gasta esperando.)
Pilar 2: Transformar, sem compute do Snowflake
A próxima parte é a mais empolgante, porque não era possível há uma semana.
O transformador é o dbt com o DuckDB fazendo o trabalho. O DuckDB anexa o catálogo REST do Horizon duas vezes: ICE_RAW para ler o que o dlt carregou, ICE_TRANSFORMED para gravar o resultado. Ele lê, executa o seu SQL e grava uma tabela Iceberg gerenciada pelo Snowflake novinha em folha, direto de volta pelo catálogo. Sem truques nem mágica de palco.
Como isso foi desbloqueado: o DuckDB 1.5.4 lançou um conjunto de opções de compatibilidade de escrita Iceberg-REST (duckdb-iceberg#1017), e o dbt Fusion (preview.194+) as expõe no catalogs.yml v2. Quatro opções ensinam o DuckDB a fazer commit exatamente no formato que o Horizon aceita. Aqui está a configuração do catálogo; o alvo de escrita é quem carrega a mágica:
# dbt/catalogs.yml
catalogs:
  - name: ice_raw          # READ
    type: iceberg_rest
    table_format: iceberg
    config:
      duckdb:
        endpoint: " env_var('HORIZON_CATALOG_URI') "
        warehouse: ICE_RAW          # = the Snowflake database
        secret: horizon
        attach_as: ice_raw
        access_delegation_mode: VENDED_CREDENTIALS

  - name: ice_transformed  # WRITE
    type: iceberg_rest
Expandir código
Ative o projeto com a flag de catalogs v2 e vincule seu modelo de staging ao catálogo de escrita:
# dbt/dbt_project.yml
flags:
  use_catalogs_v2: true

models:
  horizon_iceberg:
    staging:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: STAGING
    marts:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: MARTS
Esses valores de +schema: colocam cada modelo no seu próprio namespace Iceberg (STAGING, MARTS) dentro de ICE_TRANSFORMED. Como no uso normal do dbt, você não pré-cria schemas: o dbt executa create schema if not exists antes de cada modelo (como de costume), e o DuckDB-iceberg transforma isso em uma criação de namespace no catálogo REST do Horizon, pertencente à role transformer que o criou.
💡Mantenha os nomes dos schemas em maiúsculas. Como o duckdb cuida da criação dos schemas, você não tem o comportamento de identificadores sem aspas do Snowflake.
No repositório, você vai encontrar um modelo de staging básico que apenas mostra que podemos fazer um CTAS de uma nova tabela em um schema diferente com base na tabela ice_raw. E um conjunto de queries de marts só para demonstrar como podemos usar múltiplos schemas.
Aqui estão as tabelas de marts no Snowflake, pertencentes à role transformer:
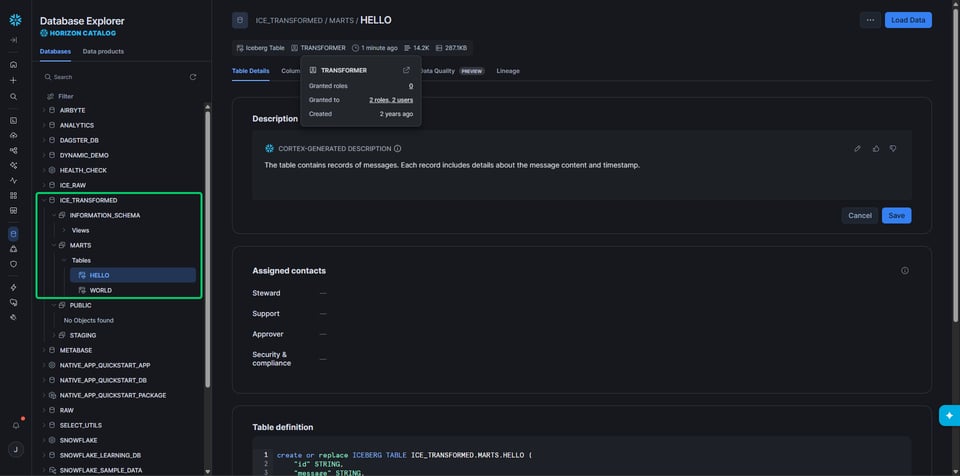
Se quisermos provas de que essas tabelas escritas pelo dbt são commits reais no catálogo, e não um truque local, podemos lê-las de volta a partir de uma engine completamente diferente: pyiceberg ou duckdb direto do catálogo. (O repositório também inclui um conjunto de queries duckdb para ler as tabelas do Horizon.)
import os
from pyiceberg.catalog.rest import RestCatalog
cat = RestCatalog("h", uri=os.environ["HORIZON_CATALOG_URI"], warehouse="ICE_TRANSFORMED",
    credential=os.environ["HORIZON_PAT"], scope="session:role:TRANSFORMER",
    **{"header.X-Iceberg-Access-Delegation": "vended-credentials"})
t = cat.load_table(("STAGING", "stg_hello_world")).scan().to_arrow()
print(t.num_rows, "rows")
Para checar direto no Duckdb, inicie o Duckdb no terminal e então:
INSTALL iceberg;

LOAD iceberg;

-- see repo, it will tell you how to generate the token
CREATE OR REPLACE SECRET horizon (
    TYPE ICEBERG,
    TOKEN getenv('HORIZON_TOKEN')
);

-- 3. Attach the Snowflake-managed Iceberg catalog. warehouse = database name (ICE_RAW).
ATTACH 'ICE_RAW' AS horizon (
    TYPE ICEBERG,
    ENDPOINT 'https://myorg-myacct.snowflakecomputing.com/polaris/api/catalog',
    SECRET horizon
Expandir código
Um modelo escrito em dbt, executado pelo DuckDB, gravado como Iceberg governado no Snowflake e lido de volta pelo pyiceberg. Três engines, uma tabela, um catálogo. Esse é o lakehouse aberto funcionando como prometido.
💡Se você ainda não pode rodar o Fusion, a mesma escrita nativa funciona no dbt-core padrão + dbt-duckdb com uma pequena materialization customizada. O repositório a inclui como fallback em dbt/macros-duckdb/, com as duas pegadinhas exclusivas do dbt-core documentadas (o dbt-duckdb descarta silenciosamente opções booleanas de attach com valor false; e o append de dados precisa de um commit explícito). O Fusion cuida das duas para você, e é por isso que ele é o caminho principal.
Pilar 3: Servir para IA e BI, com governança
Essas são tabelas gerenciadas pelo Snowflake, então podemos manter o Pilar 3 bem curto. Tudo o que você já faz no Snowflake funciona: políticas de acesso por linha, masking de colunas, tags de objetos, linhagem, funções do Cortex, views semânticas, agentes, ferramentas de BI. Nenhuma configuração especial de Iceberg é necessária.
Mais fácil que o DuckLake?
Algumas semanas atrás, compartilhei uma demo bem recebida sobre como o DuckLake é fácil. Mas ouso dizer: será que o Iceberg no Horizon é ainda mais fácil?
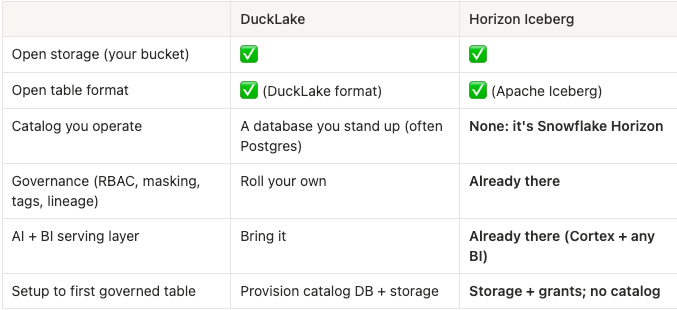
DuckLake Horizon Iceberg Armazenamento aberto (seu bucket) ✅ ✅ Formato aberto de tabela ✅ (formato DuckLake) ✅ (Apache Iceberg) Catálogo que você opera Um banco de dados que você sobe (geralmente Postgres) Nenhum: é o Snowflake Horizon Governança (RBAC, masking, tags, linhagem) Construa a sua Já está lá Camada de serving para IA + BI Traga a sua Já está lá (Cortex + qualquer BI) Setup até a primeira tabela governada Provisionar DB do catálogo + storage Storage + grants; sem catálogo
A linha do catálogo é toda a história. No DuckLake, você provisiona e fica de babá do banco de metadados. Aqui, não, porque o banco de metadados é o Horizon, e você não construiu o Horizon; você comprou o Snowflake, e ele já veio ligado.
É essa sensação de "nunca foi tão fácil" que as pessoas vivem descrevendo. Não é que o lakehouse ficou mais poderoso. É que a peça mais difícil (um catálogo confiável e governado) acabou sendo justamente a peça que você não precisa fazer.
Experimente
O repositório completo e reproduzível está aqui. O caminho rápido, conforme o readme:
# 1. Foundation: your storage + Snowflake grants (one time)
cd tf/aws && terraform init && terraform apply
cd ../snowflake && terraform init && terraform apply
snow sql -f sql/horizon_access.sql --role ACCOUNTADMIN

# 2. Load: no Snowflake compute
cd dlt && uv run python hello_world_pipeline.py

# 3. Transform: no Snowflake compute
cd ../dbt && dbt system update && dbt run   # dbt Fusion >= preview.194

# 4. Serve: governed, from Snowflake
snow sql -q "SELECT * FROM ICE_TRANSFORMED.STAGING.STG_HELLO_WORLD"
Para encerrar
Dados abertos no seu bucket. Um catálogo que você não precisou construir. Cargas e transformações que não queimam tempo de warehouse. E no segundo em que esses dados passam a existir, eles já chegam vestindo toda a governança do Snowflake (o RBAC, o masking, as tags, a linhagem, a IA), porque, para o Snowflake, eles nunca foram "externos", para começo de conversa.
O dbt está abraçando a Open Data Infrastructure (sim, mais um chavão novo para você) e dando passos para tornar o dbt mais compatível com essa visão.
Agora vá experimentar e me conte se o Iceberg deixou de parecer complicado e intimidador!
Frequently asked
questions
Comece a usar em menos de 15 minutos
Conecte sua conta do Snowflake, Databricks ou BigQuery e entenda na hora o seu potencial de economia.