

TLDR
L'Iceberg REST Catalog di Snowflake Horizon permette di caricare e trasformare dati come tabelle Iceberg governate senza consumare compute Snowflake. dlt scrive i dati grezzi su Iceberg tramite una pipeline open source, dbt Fusion con DuckDB li trasforma, ed entrambi committano direttamente attraverso il catalogo di Snowflake senza mai avviare un warehouse. Nel momento in cui i dati atterrano, sono completamente governati da Snowflake: RBAC, masking, lineage, tag, Cortex. Tutto questo è diventato possibile a fine giugno 2026, quando DuckDB 1.5.4, dbt Fusion preview.194+ e il supporto alle scritture esterne di Snowflake Horizon sono usciti insieme.
Allo Snowflake Summit 2026 Snowflake ha dichiarato di offrire il supporto più ampio per Iceberg V3, essendo il primo catalogo completamente aperto ad abilitare letture e scritture esterne su Iceberg, inclusi deletion vector, row lineage, tipo variant e valori di default. Quindi non potevo non metterlo alla prova.
L'aspetto delle "scritture esterne", insieme ad alcuni sviluppi recenti di dbt e DuckDB, rende possibile una versione del lakehouse che volevo costruire per i miei clienti e che fino a fine giugno 2026 non era realizzabile. Funziona così: le tue tabelle vivono nel tuo cloud storage, in un formato aperto, con un catalogo che non richiede alcuna gestione, facile da mettere in piedi, semplice da leggere e da scrivere, leggibile da qualsiasi engine e scrivibile da altri engine come DuckDB. Ma queste tabelle restano comunque governate da Snowflake: un solo catalogo, un solo set di grant, un unico posto dove vivono masking, lineage e tag. Storage aperto sotto, governance vera + Snowflake AI sopra.
- Carica i dati grezzi come Apache Iceberg nel tuo bucket S3, senza alcun warehouse Snowflake in esecuzione.
- Trasformali in una nuova tabella Iceberg con dbt. Di nuovo: nessun warehouse Snowflake in esecuzione.
- Servili ad AI e BI con l'intero stack di governance di Snowflake: RBAC, masking policy, row-access policy, tag, lineage, Cortex.
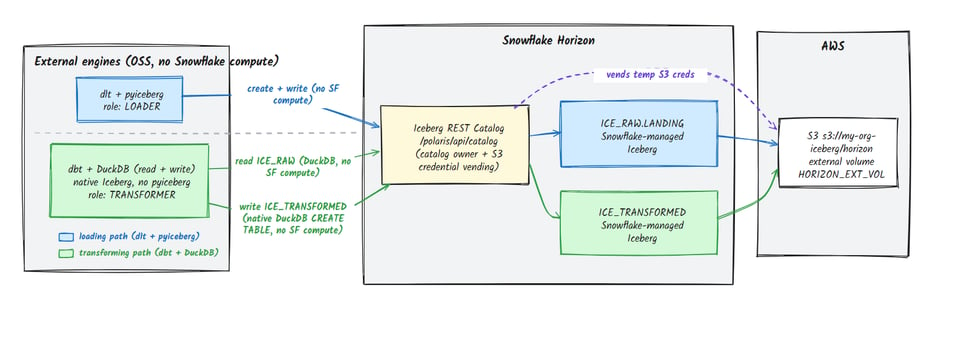
Ciò che rende tutto questo possibile è l'Iceberg REST Catalog di Snowflake Horizon. Gli engine esterni (dlt, DuckDB, dbt in esecuzione sul tuo laptop o in un piccolo container) scrivono tabelle Iceberg gestite da Snowflake direttamente tramite quella API. Snowflake è il proprietario del catalogo, fornisce credenziali S3 con scope limitato al momento della scrittura, e il tuo engine esegue il compute vero e proprio. Il risultato è una tabella governata a tutti gli effetti. Non una tabella esterna che Snowflake guarda con sospetto. Una tabella vera. E il catalogo è già lì. Non lo configuri. Non lo attivi. Arriva già con Snowflake.
Lo step di trasformazione è la parte più recente di questo stack, perché il resto era già possibile in precedenza. Ci sono volute tre release specifiche uscite tutte insieme: DuckDB 1.5.4 ha aggiunto le opzioni di write-compatibility che permettono a DuckDB di committare Iceberg attraverso un catalogo REST, dbt Fusion preview.194+ le ha esposte in catalogs.yml v2, e Snowflake Horizon ha completato il percorso di scrittura per engine esterni tramite l'API Iceberg REST Catalog. Se ci avessi provato prima del 30 giugno 2026 (release di Fusion 194), la scrittura semplicemente falliva.
Cosa significa davvero "Iceberg REST Catalog" in questo contesto
Un rapido allineamento sui termini. Apache Iceberg è il formato tabellare aperto che permette di leggere e scrivere file parquet come fossero tabelle (select, insert, ecc.), più un albero di metadati che offre commit ACID, schema evolution e time travel. Il REST Catalog è la specifica API aperta che dice a un engine dove si trovano i metadati correnti e coordina i commit SQL.
Snowflake Horizon implementa quella API REST Catalog e la fa puntare alle tabelle Iceberg gestite da Snowflake. Quindi, quando DuckDB o dlt parlano il protocollo Iceberg REST, a rispondere è Snowflake, nel ruolo di catalogo. L'endpoint ha questo aspetto:
1https://<your-account>.snowflakecomputing.com/polaris/api/catalog
Due cose da tenere bene a mente:
- Nel gergo del REST catalog, il
warehouseè il tuo database Snowflake (nell'esempio qui sotto lo chiamiamoICE_RAW), non un virtual warehouse. In questo caso la parolawarehousenon implica alcun compute. - L'autenticazione è uno scambio di token OAuth2. Passi a Horizon un Programmatic Access Token (PAT) di Snowflake come
client_secret, con uno scope tiposession:role:TRANSFORMER, e in cambio ricevi un bearer token a breve scadenza. Il tuo ruolo, e ogni grant a esso associato, viaggia insieme a quel token.
Questo secondo punto riassume tutta la governance in una sola frase: il catalogo concede l'accesso in base al ruolo Snowflake. Tienilo a mente: tornerà nella sezione dedicata al "servire".
L'architettura, in una sola schermata
Ogni freccia che va da un engine verso il catalogo non comporta alcun compute Snowflake. Gli engine fanno il lavoro; Horizon governa e fa da intermediario. I dati restano nel tuo bucket per tutto il tempo.
Le fondamenta una tantum (e perché non sono il catalogo)
Il setup necessario è sorprendentemente semplice. Snowflake ha eliminato quasi tutta la complessità legata alla configurazione dell'Iceberg Catalog. Ecco cosa serve configurare.
- Dove vivono i dati. Un bucket S3 e un external volume Snowflake che ci punta, con un ruolo IAM che Snowflake assume. Questa è la parte "il tuo storage, il tuo bucket" del lakehouse aperto.
- Chi può toccarli. Un paio di ruoli Snowflake e un service user con Programmatic Access Token. È semplicemente l'RBAC di Snowflake. Lo conosci già.
Il repo di accompagnamento fa tutto questo con Terraform + un po' di SQL, così puoi leggere ogni singola riga. Lo storage:
# tf/snowflake: the external volume + Iceberg-by-default databases
resource "snowflake_external_volume" "horizon" {
  name = "HORIZON_EXT_VOL"
  storage_location {
    storage_location_name = "horizon-s3"
    storage_provider      = "S3"
    storage_base_url      = "s3://my-org-iceberg/horizon/"
    storage_aws_role_arn  = aws_iam_role.snowflake.arn
  }
}

resource "snowflake_database" "ice_raw" {
  name   = "ICE_RAW"
  external_volume = snowflake_external_volume.horizon.name
  catalog  = "SNOWFLAKE"   # Snowflake-managed Iceberg
Espandi il codice
L'accesso: semplice RBAC, due ruoli, un service user che li detiene.
-- sql/horizon_access.sql (abridged)
CREATE ROLE IF NOT EXISTS LOADER;       -- writes ICE_RAW
CREATE ROLE IF NOT EXISTS TRANSFORMER;  -- reads ICE_RAW, writes ICE_TRANSFORMED

GRANT USAGE ON DATABASE ICE_RAW TO ROLE TRANSFORMER;
GRANT USAGE ON SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON ALL ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON FUTURE ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;

GRANT USAGE ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;
GRANT CREATE SCHEMA ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;

CREATE USER IF NOT EXISTS HORIZON_SVC TYPE = SERVICE;
GRANT ROLE LOADER, TRANSFORMER TO USER HORIZON_SVC;
Poi emetti i token. Ogni engine riceve un PAT limitato esattamente a un ruolo, con il principio del least privilege già incorporato:
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_LOAD_PAT DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='LOADER'      COMMENT='dlt loader'"      --role ACCOUNTADMIN
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_PAT      DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='TRANSFORMER' COMMENT='dbt transformer'" --role ACCOUNTADMIN
Tutto qui. Queste sono le fondamenta. Storage di tua proprietà, ruoli che concedi tu. In nessun punto hai costruito un catalogo, perché il catalogo è Horizon, e Horizon è semplicemente… acceso.
💡Un'insidia concreta che vale la pena segnalarti per risparmiarti un'ora: l'hostname usa un trattino, non un underscore. È myorg-myacct.snowflakecomputing.com, e il modulo ssl di Python rifiuta la forma con l'underscore. curl la tollera, quindi sembrerà tutto funzionare finché la pipeline non si romperà.
Pilastro 1: caricare, senza compute Snowflake
Il codice completo è disponibile nel repo qui. In questo articolo estrarrò solo le parti di codice rilevanti per facilitarne la lettura.
Il loader è dlt con la sua destination open source filesystem e table_format="iceberg", puntata verso il catalogo REST di Horizon. Niente dlt+, nessun connettore su licenza. dlt scrive i parquet e committa attraverso il catalogo con pyiceberg; Horizon fornisce le credenziali S3.
La connessione al catalogo vive nei secrets di dlt, e l'unico trucco specifico di Snowflake è questo: le tabelle Iceberg gestite da Snowflake ricevono la location da Snowflake stesso (sotto il tuo external volume), quindi una location fornita dal client viene rifiutata. Facciamo il wrap della create_table di dlt per ometterla:
import dlt
from dlt.destinations import filesystem
import dlt.common.libs.pyiceberg as _ice
import pyarrow as _pa

# Snowflake Horizon assigns the table location under the external volume and
# rejects a client-supplied one, so drop `location` on create. That's the
# intended external-write flow.
def _create_no_location(catalog, table_id, table_location, schema, **kw):
    if isinstance(schema, _pa.Schema):
        schema = _ice.ensure_iceberg_compatible_arrow_schema(schema)
    catalog.create_table(identifier=table_id, schema=schema,
                         partition_spec=kw.get("partition_spec", _ice.UNPARTITIONED_PARTITION_SPEC),
                         properties=kw.get("properties") or {})
_ice.create_table = _create_no_location
Espandi il codice
Eseguilo:
1uv run python hello_world_pipeline.py
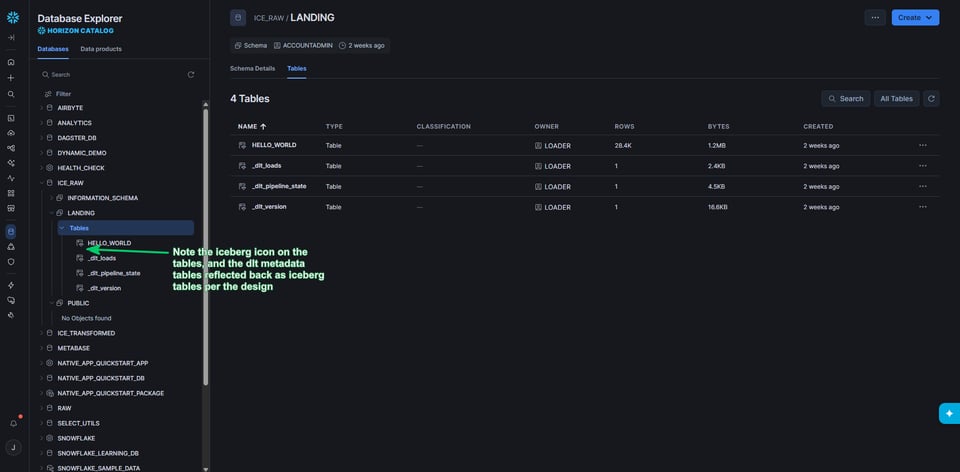
Ed ecco il momento clou. Vai su Snowflake (ora puoi usare un warehouse, perché sei un essere umano che esegue una query) e la tabella è lì, governata, interrogabile, di tipo MANAGED:
1SELECT * FROM ICE_RAW.LANDING.HELLO_WORLD;
Righe scritte da un processo Python open source che non ha mai avviato un warehouse Snowflake. I byte sono nel tuo bucket. La governance è di Snowflake. Fantastico.
Bonus del Pilastro 1:
Per amore della scienza, ho deciso di schedulare il job EL sulla nuova piattaforma SaaS di dltHub, dltHub Pro. Mi rendo conto di quanto sia inutile schedulare un job che scrive le parole "hello" e "world" su Snowflake, ma davanti ai giocattoli nuovi e luccicanti non ho saputo resistere.
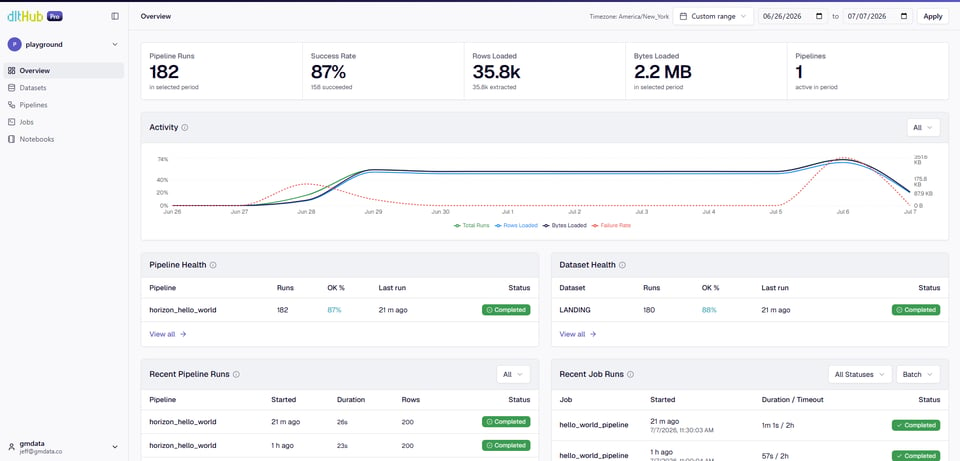
La pipeline è ormai in esecuzione da due settimane, ogni 30 minuti durante l'orario lavorativo. È stata eseguita circa 200 volte ed è costata finora circa 2 dollari. (I cataloghi REST sono notoriamente lenti, quindi la maggior parte di quei soldi è stata spesa aspettando.)
Pilastro 2: trasformare, senza compute Snowflake
Questa parte è la più entusiasmante, perché una settimana fa non era possibile.
Il transformer è dbt, con DuckDB a fare il lavoro. DuckDB esegue l'attach del catalogo REST di Horizon due volte: ICE_RAW per leggere ciò che dlt ha caricato, ICE_TRANSFORMED per scrivere il risultato. Legge, esegue il tuo SQL e scrive una tabella Iceberg gestita da Snowflake nuova di zecca direttamente attraverso il catalogo. Nessun gioco di prestigio, nessun trucco.
Com'è stato sbloccato tutto questo: DuckDB 1.5.4 ha introdotto una serie di opzioni di write-compat per Iceberg REST (duckdb-iceberg#1017), e dbt Fusion (preview.194+) le espone in catalogs.yml v2. Quattro opzioni insegnano a DuckDB a committare esattamente nella forma che Horizon accetta. Ecco la configurazione del catalogo; la magia sta nel target di scrittura:
# dbt/catalogs.yml
catalogs:
  - name: ice_raw          # READ
    type: iceberg_rest
    table_format: iceberg
    config:
      duckdb:
        endpoint: " env_var('HORIZON_CATALOG_URI') "
        warehouse: ICE_RAW          # = the Snowflake database
        secret: horizon
        attach_as: ice_raw
        access_delegation_mode: VENDED_CREDENTIALS

  - name: ice_transformed  # WRITE
    type: iceberg_rest
Espandi il codice
Attiva il progetto con il flag catalogs v2 e associa il tuo modello di staging al catalogo di scrittura:
# dbt/dbt_project.yml
flags:
  use_catalogs_v2: true

models:
  horizon_iceberg:
    staging:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: STAGING
    marts:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: MARTS
Quei valori +schema: collocano ciascun modello nel proprio namespace Iceberg (STAGING, MARTS) dentro ICE_TRANSFORMED. Come nell'uso normale di dbt, non pre-crei gli schemi: dbt esegue create schema if not exists prima di ogni modello (esattamente come al solito), DuckDB-iceberg lo traduce in una creazione di namespace sul catalogo REST di Horizon, di proprietà del ruolo transformer che l'ha creato.
💡Mantieni i nomi degli schemi in maiuscolo. Dato che è duckdb a gestire la creazione degli schemi, non ottieni il comportamento di Snowflake sugli identificatori senza virgolette.
Nel repo troverai un modello di staging basilare che mostra semplicemente come si possa fare un CTAS di una nuova tabella in uno schema diverso a partire dalla tabella ice_raw. E un set di query marts, giusto per dimostrare come usare più schemi.
Ecco le tabelle marts in Snowflake, di proprietà del ruolo transformer:
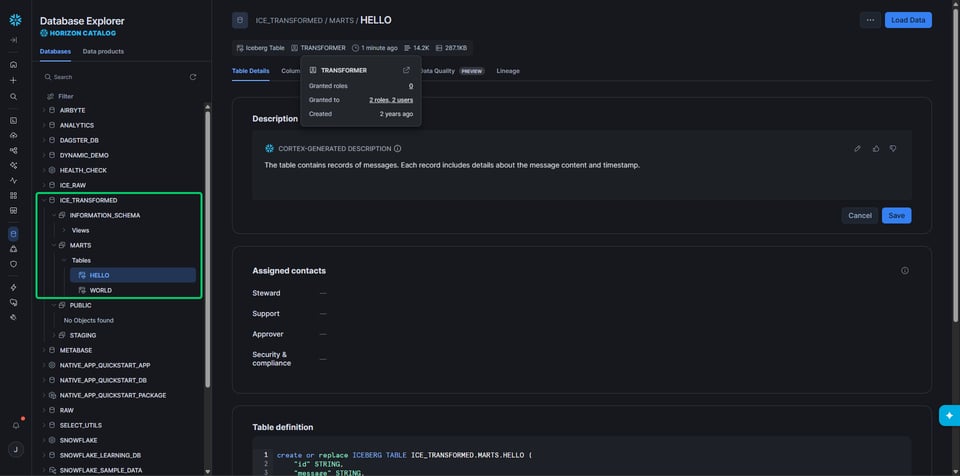
Se vogliamo la prova che queste tabelle scritte da dbt sono veri commit a catalogo e non un trucco locale, possiamo rileggerle da un engine completamente diverso: pyiceberg o duckdb, direttamente dal catalogo. (Il repo include anche un set di query duckdb per leggere le tabelle da Horizon.)
import os
from pyiceberg.catalog.rest import RestCatalog
cat = RestCatalog("h", uri=os.environ["HORIZON_CATALOG_URI"], warehouse="ICE_TRANSFORMED",
    credential=os.environ["HORIZON_PAT"], scope="session:role:TRANSFORMER",
    **{"header.X-Iceberg-Access-Delegation": "vended-credentials"})
t = cat.load_table(("STAGING", "stg_hello_world")).scan().to_arrow()
print(t.num_rows, "rows")
Per verificare direttamente da Duckdb, avvia Duckdb nel terminale e poi:
INSTALL iceberg;

LOAD iceberg;

-- see repo, it will tell you how to generate the token
CREATE OR REPLACE SECRET horizon (
    TYPE ICEBERG,
    TOKEN getenv('HORIZON_TOKEN')
);

-- 3. Attach the Snowflake-managed Iceberg catalog. warehouse = database name (ICE_RAW).
ATTACH 'ICE_RAW' AS horizon (
    TYPE ICEBERG,
    ENDPOINT 'https://myorg-myacct.snowflakecomputing.com/polaris/api/catalog',
    SECRET horizon
Espandi il codice
Un modello scritto in dbt, eseguito da DuckDB, atterrato come Iceberg governato in Snowflake e riletto da pyiceberg. Tre engine, una tabella, un catalogo. Questo è il lakehouse aperto che funziona esattamente come promesso.
💡Se non puoi ancora usare Fusion, la stessa scrittura nativa funziona con dbt-core standard + dbt-duckdb tramite una piccola materialization personalizzata. Il repo la include come fallback in dbt/macros-duckdb/, con le due insidie specifiche di dbt-core documentate (dbt-duckdb scarta silenziosamente le opzioni di attach booleane impostate a false; e l'append dei dati richiede un commit esplicito). Fusion gestisce entrambe le cose per te, ed è per questo che è il percorso di riferimento.
Pilastro 3: servire ad AI e BI, con la governance
Essendo tabelle gestite da Snowflake, possiamo tenere il Pilastro 3 molto breve. Tutto ciò che fai già in Snowflake funziona: row-access policy, column masking, object tag, lineage, funzioni Cortex, semantic view, agenti, strumenti di BI. Nessuna configurazione Iceberg speciale richiesta.
Più facile di DuckLake?
Qualche settimana fa ho condiviso una demo molto apprezzata su quanto sia facile DuckLake. Ma oserei dire che Iceberg su Horizon è persino più facile?
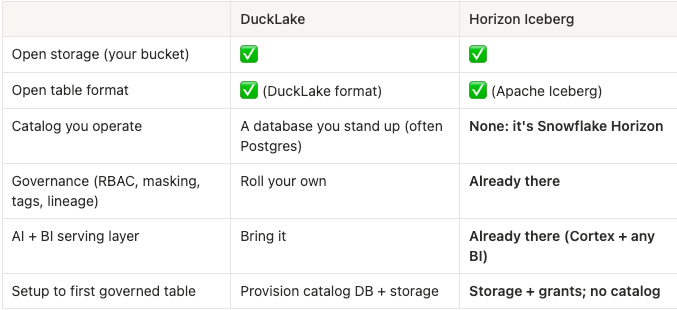
DuckLake Horizon Iceberg Storage aperto (il tuo bucket) ✅ ✅ Formato tabellare aperto ✅ (formato DuckLake) ✅ (Apache Iceberg) Catalogo da gestire Un database da mettere in piedi (spesso Postgres) Nessuno: è Snowflake Horizon Governance (RBAC, masking, tag, lineage) Fai da te Già inclusa Livello di serving AI + BI Lo porti tu Già incluso (Cortex + qualsiasi BI) Setup fino alla prima tabella governata Provisioning del DB del catalogo + storage Storage + grant; nessun catalogo
La riga sul catalogo dice tutto. In DuckLake devi effettuare il provisioning del database dei metadati e fargli da babysitter. Qui no, perché il database dei metadati è Horizon, e Horizon non l'hai costruito tu: hai comprato Snowflake, ed era già acceso.
È quella sensazione di "la cosa più semplice del mondo" che la gente continua a descrivere. Non è che il lakehouse sia diventato più potente. È che il pezzo più difficile (un catalogo affidabile e governato) si è rivelato il pezzo che non devi costruire tu.
Provalo
Il repo completo e riproducibile è qui. La via rapida, come da readme:
# 1. Foundation: your storage + Snowflake grants (one time)
cd tf/aws && terraform init && terraform apply
cd ../snowflake && terraform init && terraform apply
snow sql -f sql/horizon_access.sql --role ACCOUNTADMIN

# 2. Load: no Snowflake compute
cd dlt && uv run python hello_world_pipeline.py

# 3. Transform: no Snowflake compute
cd ../dbt && dbt system update && dbt run   # dbt Fusion >= preview.194

# 4. Serve: governed, from Snowflake
snow sql -q "SELECT * FROM ICE_TRANSFORMED.STAGING.STG_HELLO_WORLD"
In conclusione
Dati aperti nel tuo bucket. Un catalogo che non hai dovuto costruire. Load e trasformazioni che non bruciano tempo di warehouse. E nell'istante in cui quei dati esistono, sono già avvolti da tutta la governance di Snowflake (l'RBAC, il masking, i tag, il lineage, l'AI) perché per Snowflake non sono mai stati "esterni" fin dall'inizio.
dbt sta abbracciando la Open Data Infrastructure (sì, una nuova buzzword per te) e si sta muovendo per rendere dbt più compatibile con questa visione.
Ora vai a provarlo e fammi sapere se Iceberg ha smesso di sembrarti complicato e intimidante!
Frequently asked
questions
Diventa operativo in meno di 15 minuti
Collega il tuo account Snowflake, Databricks o BigQuery e scopri subito il tuo potenziale di risparmio.