

TLDR
El Iceberg REST Catalog de Snowflake Horizon te permite cargar y transformar datos como tablas Iceberg gobernadas sin usar nada de cómputo de Snowflake. dlt escribe los datos crudos en Iceberg mediante un pipeline open source, dbt Fusion con DuckDB los transforma, y ambos hacen commit directamente a través del catálogo de Snowflake sin iniciar jamás un warehouse. En el momento en que esos datos aterrizan, quedan totalmente gobernados por Snowflake: RBAC, enmascaramiento, linaje, tags, Cortex. Esto se volvió posible a fines de junio de 2026, cuando DuckDB 1.5.4, dbt Fusion preview.194+ y el soporte de escritura externa de Snowflake Horizon se lanzaron al mismo tiempo.
En el Snowflake Summit 2026, Snowflake afirmó tener el soporte más amplio para Iceberg V3, siendo el primer catálogo totalmente abierto en habilitar lecturas y escrituras externas a Iceberg, incluyendo deletion vectors, row lineage, el tipo variant y valores por defecto. Así que tuve que ponerlo a prueba.
El aspecto de las "escrituras externas", junto con algunos avances recientes de dbt y DuckDB, hace posible una versión del lakehouse que quería construir para mis clientes y que no era posible hasta fines de junio de 2026. Funciona así: tus tablas viven en tu propio almacenamiento en la nube, en un formato abierto, con un catálogo que no requiere gestión, fácil de montar, simple de leer y escribir, legible por cualquier motor y escribible por otros motores como DuckDB. Pero esas tablas siguen estando gobernadas por Snowflake: un solo catálogo, un solo conjunto de grants, un solo lugar donde viven el enmascaramiento, el linaje y los tags. Almacenamiento abierto por debajo, gobernanza real + la IA de Snowflake por encima.
- Deposita los datos crudos como Apache Iceberg en tu propio bucket de S3, sin ningún warehouse de Snowflake en ejecución.
- Transfórmalos en una nueva tabla Iceberg con dbt. De nuevo: sin ningún warehouse de Snowflake en ejecución.
- Sírvelos a la IA y al BI con todo el stack de gobernanza de Snowflake: RBAC, políticas de enmascaramiento, políticas de acceso por filas, tags, linaje, Cortex.
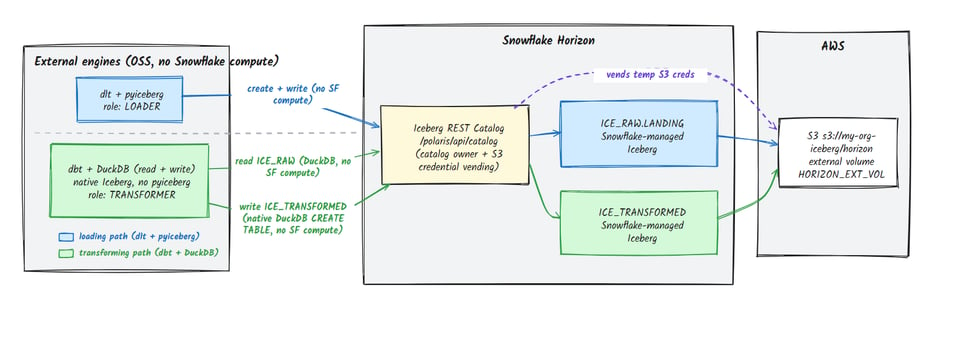
Lo que hace esto posible es el Iceberg REST Catalog de Snowflake Horizon. Los motores externos (dlt, DuckDB, dbt corriendo en tu laptop o en un contenedor pequeño) escriben tablas Iceberg gestionadas por Snowflake directamente sobre esa API. Snowflake es dueño del catálogo, entrega credenciales de S3 con alcance limitado al momento de escribir, y tu motor hace el cómputo real. El resultado es una tabla gobernada de primera clase. No una tabla externa que Snowflake mira con desconfianza. Una de verdad. Y el catálogo ya está ahí. No lo configuras. No lo activas. Vino con Snowflake.
El paso de transformación es la novedad más reciente de este stack, ya que el resto era posible desde antes. Hicieron falta tres lanzamientos específicos que llegaron al mismo tiempo: DuckDB 1.5.4 agregó las opciones de compatibilidad de escritura que permiten a DuckDB hacer commit de Iceberg a través de un catálogo REST, dbt Fusion preview.194+ expuso esas opciones en catalogs.yml v2, y Snowflake Horizon completó su ruta de escritura para motores externos vía la API del Iceberg REST Catalog. Si intentabas esto antes del 30 de junio de 2026 (lanzamiento de Fusion 194), la escritura simplemente fallaba.
Qué significa realmente "Iceberg REST Catalog" aquí
Repasemos rápido el vocabulario. Apache Iceberg es el formato de tabla abierto que te permite leer y escribir archivos parquet como si fueran tablas (select, insert, etc.), además de un árbol de metadatos que te da commits ACID, evolución de esquema y time travel. El REST Catalog es la especificación de API abierta que le indica a un motor dónde están los metadatos actuales y coordina los commits de SQL.
Snowflake Horizon implementa esa API de REST Catalog y la apunta a tablas Iceberg gestionadas por Snowflake. Así que cuando DuckDB o dlt hablan el protocolo Iceberg REST, Snowflake responde como el catálogo. El endpoint se ve así:
1https://<your-account>.snowflakecomputing.com/polaris/api/catalog
Dos cosas que conviene tener claras:
- En el lenguaje del catálogo REST, el
warehousees tu base de datos de Snowflake (en nuestro ejemplo de abajo la llamamosICE_RAW), no un virtual warehouse. En este caso, la palabrawarehouseno implica ningún cómputo. - La autenticación es un intercambio de tokens OAuth2. Le entregas a Horizon un Programmatic Access Token (PAT) de Snowflake como
client_secret, con un scope comosession:role:TRANSFORMER, y te devuelve un bearer token de corta duración. Tu rol, y cada grant asociado a él, viaja con ese token.
Ese segundo punto resume toda la historia de gobernanza en una sola frase: el catálogo otorga el acceso según el rol de Snowflake. Quédate con esa idea; volverá a aparecer en la sección de "servir".
La arquitectura, en una sola pantalla
Cada flecha que va de un motor al catálogo implica cero cómputo de Snowflake. Los motores hacen el trabajo; Horizon gobierna y actúa como intermediario. Los datos permanecen en tu bucket todo el tiempo.
La base que se configura una sola vez (y por qué no es el catálogo)
La configuración necesaria es sorprendentemente fácil. Snowflake eliminó casi toda la complejidad de montar el Iceberg Catalog. Esto es lo que necesitas configurar.
- Dónde viven los datos. Un bucket de S3 y un external volume de Snowflake que apunta a él, con un rol de IAM que Snowflake asume. Esta es la parte de "tu almacenamiento, tu bucket" del lakehouse abierto.
- Quién puede tocarlos. Un par de roles de Snowflake y un usuario de servicio con Programmatic Access Tokens. Esto es simplemente RBAC de Snowflake. Ya lo conoces.
El repo complementario hace todo esto con Terraform + un poco de SQL, así que puedes leer cada línea. Almacenamiento:
# tf/snowflake: the external volume + Iceberg-by-default databases
resource "snowflake_external_volume" "horizon" {
  name = "HORIZON_EXT_VOL"
  storage_location {
    storage_location_name = "horizon-s3"
    storage_provider      = "S3"
    storage_base_url      = "s3://my-org-iceberg/horizon/"
    storage_aws_role_arn  = aws_iam_role.snowflake.arn
  }
}

resource "snowflake_database" "ice_raw" {
  name   = "ICE_RAW"
  external_volume = snowflake_external_volume.horizon.name
  catalog  = "SNOWFLAKE"   # Snowflake-managed Iceberg
Expandir código
Acceso: RBAC simple, dos roles y un usuario de servicio que los tiene.
-- sql/horizon_access.sql (abridged)
CREATE ROLE IF NOT EXISTS LOADER;       -- writes ICE_RAW
CREATE ROLE IF NOT EXISTS TRANSFORMER;  -- reads ICE_RAW, writes ICE_TRANSFORMED

GRANT USAGE ON DATABASE ICE_RAW TO ROLE TRANSFORMER;
GRANT USAGE ON SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON ALL ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON FUTURE ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;

GRANT USAGE ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;
GRANT CREATE SCHEMA ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;

CREATE USER IF NOT EXISTS HORIZON_SVC TYPE = SERVICE;
GRANT ROLE LOADER, TRANSFORMER TO USER HORIZON_SVC;
Luego emites los tokens. Cada motor recibe un PAT limitado a exactamente un rol, con el mínimo privilegio incorporado:
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_LOAD_PAT DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='LOADER'      COMMENT='dlt loader'"      --role ACCOUNTADMIN
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_PAT      DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='TRANSFORMER' COMMENT='dbt transformer'" --role ACCOUNTADMIN
Eso es todo. Esa es la base. Almacenamiento que es tuyo, roles que tú otorgas. En ningún momento construiste un catálogo, porque el catálogo es Horizon, y Horizon simplemente… ya está encendido.
💡Un detalle que te puede ahorrar una hora: el hostname usa guion, no guion bajo. Es myorg-myacct.snowflakecomputing.com, y el ssl de Python rechaza la forma con guion bajo. curl la tolera, así que parecerá que funciona hasta que tu pipeline deje de hacerlo.
Pilar 1: Carga, sin cómputo de Snowflake
El código completo está disponible en el repo aquí. En este blog voy a extraer solo el código relevante para facilitar la lectura.
El cargador es dlt usando su destino open source filesystem con table_format="iceberg", apuntando al catálogo REST de Horizon. Sin dlt+, sin conectores con licencia. dlt escribe el parquet y hace commit a través del catálogo con pyiceberg; Horizon entrega las credenciales de S3.
La conexión al catálogo vive en los secrets de dlt, y el único truco específico de Snowflake es este: el Iceberg gestionado por Snowflake asigna la ubicación de la tabla por sí mismo (bajo tu external volume), así que rechaza una ubicación suministrada por el cliente. Envolvemos el create_table de dlt para omitirla:
import dlt
from dlt.destinations import filesystem
import dlt.common.libs.pyiceberg as _ice
import pyarrow as _pa

# Snowflake Horizon assigns the table location under the external volume and
# rejects a client-supplied one, so drop `location` on create. That's the
# intended external-write flow.
def _create_no_location(catalog, table_id, table_location, schema, **kw):
    if isinstance(schema, _pa.Schema):
        schema = _ice.ensure_iceberg_compatible_arrow_schema(schema)
    catalog.create_table(identifier=table_id, schema=schema,
                         partition_spec=kw.get("partition_spec", _ice.UNPARTITIONED_PARTITION_SPEC),
                         properties=kw.get("properties") or {})
_ice.create_table = _create_no_location
Expandir código
Ejecútalo:
1uv run python hello_world_pipeline.py
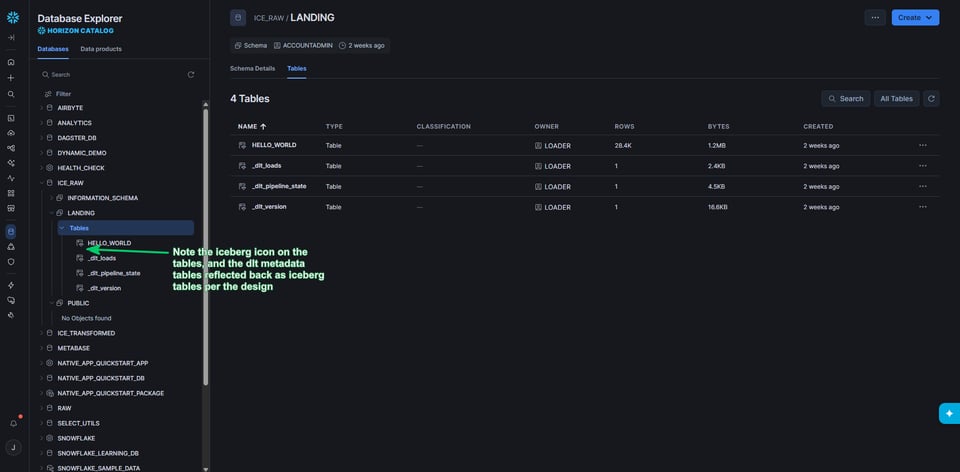
Y aquí llega el momento. Ve a Snowflake (ahora sí puedes usar un warehouse, porque eres un humano ejecutando una consulta) y la tabla está ahí mismo, gobernada, consultable, de tipo MANAGED:
1SELECT * FROM ICE_RAW.LANDING.HELLO_WORLD;
Filas escritas por un proceso de Python open source que nunca inició un warehouse de Snowflake. Los bytes están en tu bucket. La gobernanza es de Snowflake. Una maravilla.
Bonus del Pilar 1:
En nombre de la ciencia, decidí programar el job de EL en la nueva plataforma SaaS de dltHub, dltHub Pro. Sé lo inútil que es programar un job que escribe las palabras "hello" y "world" en Snowflake, pero los juguetes nuevos y brillantes… no pude resistirme.
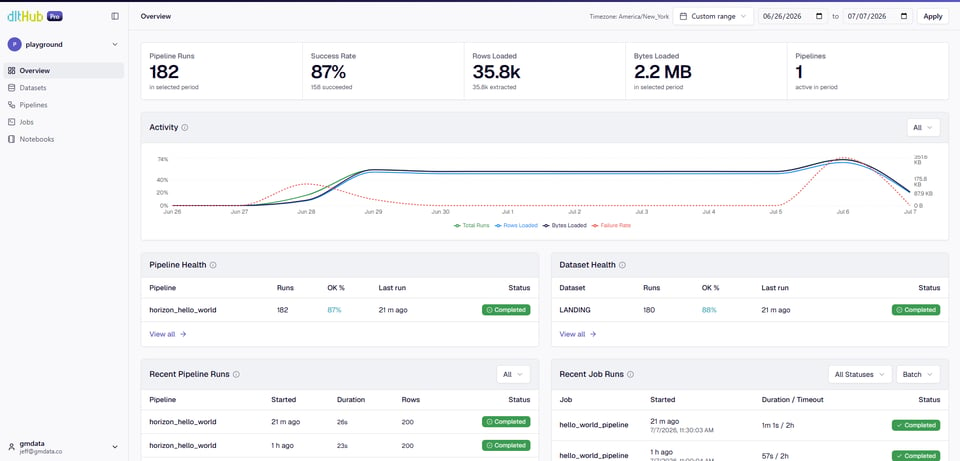
El pipeline lleva dos semanas corriendo, cada 30 minutos en horario laboral. Se ha ejecutado unas 200 veces y hasta ahora ha costado unos $2. (Los catálogos REST tienen fama de lentos, así que la mayor parte de ese dinero se gastó esperando.)
Pilar 2: Transforma, sin cómputo de Snowflake
Esta parte es la más emocionante, porque hace una semana no era posible.
El transformador es dbt con DuckDB haciendo el trabajo. DuckDB adjunta el catálogo REST de Horizon dos veces: ICE_RAW para leer lo que dlt cargó, ICE_TRANSFORMED para escribir el resultado. Lee, ejecuta tu SQL y escribe una tabla Iceberg gestionada por Snowflake completamente nueva, directo de vuelta a través del catálogo. Sin humo ni trucos.
Así se destrabó esto: DuckDB 1.5.4 lanzó un conjunto de opciones de compatibilidad de escritura para Iceberg REST (duckdb-iceberg#1017), y dbt Fusion (preview.194+) las expone en catalogs.yml v2. Cuatro opciones le enseñan a DuckDB a hacer commit exactamente en la forma que Horizon acepta. Aquí está la configuración del catálogo; el destino de escritura es donde ocurre la magia:
# dbt/catalogs.yml
catalogs:
  - name: ice_raw          # READ
    type: iceberg_rest
    table_format: iceberg
    config:
      duckdb:
        endpoint: " env_var('HORIZON_CATALOG_URI') "
        warehouse: ICE_RAW          # = the Snowflake database
        secret: horizon
        attach_as: ice_raw
        access_delegation_mode: VENDED_CREDENTIALS

  - name: ice_transformed  # WRITE
    type: iceberg_rest
Expandir código
Activa el proyecto con el flag de catalogs v2 y vincula tu modelo de staging al catálogo de escritura:
# dbt/dbt_project.yml
flags:
  use_catalogs_v2: true

models:
  horizon_iceberg:
    staging:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: STAGING
    marts:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: MARTS
Esos valores de +schema: colocan cada modelo en su propio namespace de Iceberg (STAGING, MARTS) dentro de ICE_TRANSFORMED. Como en el uso normal de dbt, no necesitas crear los esquemas de antemano: dbt ejecuta create schema if not exists antes de cada modelo (como siempre), DuckDB-iceberg lo convierte en una creación de namespace contra el catálogo REST de Horizon, propiedad del rol transformer que lo creó.
💡Mantén los nombres de esquema en mayúsculas. Como duckdb maneja la creación del esquema, no obtienes el comportamiento de identificadores sin comillas de Snowflake.
En el repo encontrarás un modelo de staging básico que solo demuestra que se puede hacer CTAS de una tabla nueva en un esquema diferente a partir de la tabla ice_raw. Y un conjunto de consultas de marts solo para mostrar cómo se pueden usar múltiples esquemas.
Aquí están las tablas de marts en Snowflake, propiedad del rol transformer:
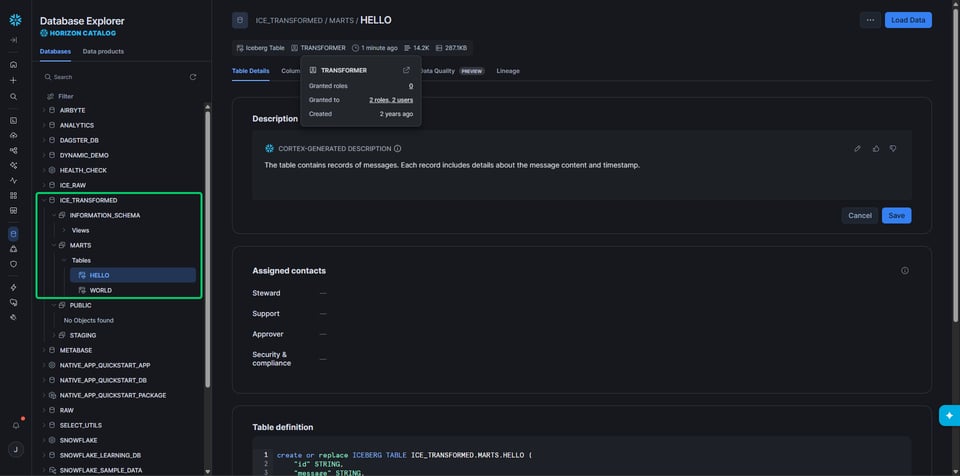
Si queremos pruebas de que estas tablas escritas por dbt son commits reales del catálogo y no un truco local, podemos leerlas de vuelta desde un motor completamente diferente: pyiceberg o duckdb directo desde el catálogo. (El repo también incluye un conjunto de consultas de duckdb para leer las tablas desde Horizon.)
import os
from pyiceberg.catalog.rest import RestCatalog
cat = RestCatalog("h", uri=os.environ["HORIZON_CATALOG_URI"], warehouse="ICE_TRANSFORMED",
    credential=os.environ["HORIZON_PAT"], scope="session:role:TRANSFORMER",
    **{"header.X-Iceberg-Access-Delegation": "vended-credentials"})
t = cat.load_table(("STAGING", "stg_hello_world")).scan().to_arrow()
print(t.num_rows, "rows")
Para verificar directamente desde Duckdb, inicia Duckdb en la terminal y luego,
INSTALL iceberg;

LOAD iceberg;

-- see repo, it will tell you how to generate the token
CREATE OR REPLACE SECRET horizon (
    TYPE ICEBERG,
    TOKEN getenv('HORIZON_TOKEN')
);

-- 3. Attach the Snowflake-managed Iceberg catalog. warehouse = database name (ICE_RAW).
ATTACH 'ICE_RAW' AS horizon (
    TYPE ICEBERG,
    ENDPOINT 'https://myorg-myacct.snowflakecomputing.com/polaris/api/catalog',
    SECRET horizon
Expandir código
Un modelo escrito en dbt, ejecutado por DuckDB, aterrizado como Iceberg gobernado en Snowflake y leído de vuelta por pyiceberg. Tres motores, una tabla, un catálogo. Ese es el lakehouse abierto funcionando tal como se promete.
💡Si todavía no puedes correr Fusion, la misma escritura nativa funciona con dbt-core estándar + dbt-duckdb mediante una pequeña materialización personalizada. El repo la incluye como alternativa en dbt/macros-duckdb/, con las dos particularidades exclusivas de dbt-core documentadas (dbt-duckdb descarta silenciosamente las opciones booleanas de attach en false; y el agregado de datos necesita un commit explícito). Fusion maneja ambas por ti, y por eso es la ruta principal.
Pilar 3: Sírvelo a la IA y al BI, con gobernanza
Estas son tablas gestionadas por Snowflake, así que podemos mantener el Pilar 3 muy corto. Todo lo que ya haces en Snowflake funciona: políticas de acceso por filas, enmascaramiento de columnas, tags de objetos, linaje, funciones de Cortex, vistas semánticas, agentes, herramientas de BI. No se requiere ninguna configuración especial de Iceberg.
¿Más fácil que DuckLake?
Hace unas semanas compartí una demo muy bien recibida sobre lo fácil que es DuckLake. Pero ¿me atrevo a decir que Iceberg en Horizon es aún más fácil?
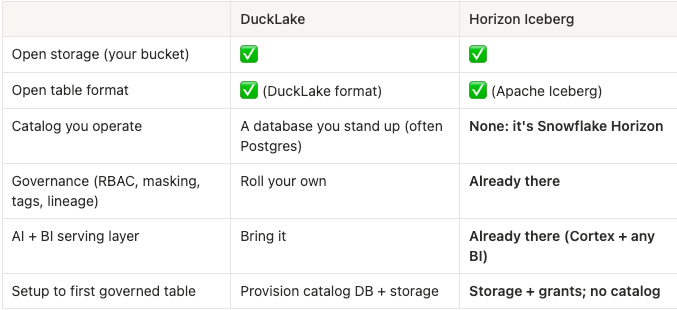
DuckLake Horizon Iceberg Almacenamiento abierto (tu bucket) ✅ ✅ Formato de tabla abierto ✅ (formato DuckLake) ✅ (Apache Iceberg) Catálogo que tú operas Una base de datos que debes montar (a menudo Postgres) Ninguno: es Snowflake Horizon Gobernanza (RBAC, enmascaramiento, tags, linaje) Constrúyela por tu cuenta Ya está ahí Capa de servicio de IA + BI Tráela tú Ya está ahí (Cortex + cualquier BI) Configuración hasta la primera tabla gobernada Aprovisionar la BD del catálogo + almacenamiento Almacenamiento + grants; sin catálogo
La fila del catálogo es toda la historia. En DuckLake aprovisionas y cuidas la base de datos de metadatos. Aquí no, porque la base de datos de metadatos es Horizon, y tú no construiste Horizon; compraste Snowflake, y vino encendido de fábrica.
Esa es la sensación de "lo más fácil desde la invención del pan rebanado" que la gente no deja de describir. No es que el lakehouse se haya vuelto más poderoso. Es que la pieza más difícil (un catálogo confiable y gobernado) resultó ser la pieza que no tienes que fabricar.
Pruébalo
El repo completo y reproducible está aquí. La ruta rápida según el readme:
# 1. Foundation: your storage + Snowflake grants (one time)
cd tf/aws && terraform init && terraform apply
cd ../snowflake && terraform init && terraform apply
snow sql -f sql/horizon_access.sql --role ACCOUNTADMIN

# 2. Load: no Snowflake compute
cd dlt && uv run python hello_world_pipeline.py

# 3. Transform: no Snowflake compute
cd ../dbt && dbt system update && dbt run   # dbt Fusion >= preview.194

# 4. Serve: governed, from Snowflake
snow sql -q "SELECT * FROM ICE_TRANSFORMED.STAGING.STG_HELLO_WORLD"
Para cerrar
Datos abiertos en tu bucket. Un catálogo que no tuviste que construir. Cargas y transformaciones que no queman tiempo de warehouse. Y en el segundo en que esos datos existen, ya llevan puesta toda la gobernanza de Snowflake (el RBAC, el enmascaramiento, los tags, el linaje, la IA), porque para Snowflake nunca fueron datos "externos".
dbt está adoptando la Open Data Infrastructure (sí, una nueva frase de moda para tu colección) y dando pasos para que dbt sea más compatible con esta visión.
Ahora ve a probarlo y cuéntame si Iceberg dejó de parecerte complicado e intimidante.
Frequently asked
questions
Ponte en marcha en menos de 15 minutos
Conecta tu cuenta de Snowflake, Databricks o BigQuery y conoce al instante tu potencial de ahorro.