

TLDR
Snowflake HorizonのIceberg REST Catalogを使えば、Snowflakeのコンピュートを一切使わずに、ガバナンスの効いたIcebergテーブルとしてデータをロード・変換できます。dltがオープンソースのパイプラインでrawデータをIcebergに書き込み、dbt FusionとDuckDBがそれを変換します。どちらもウェアハウスを一度も起動することなく、Snowflakeのカタログを通じて直接コミットします。データが着地した瞬間から、RBAC、マスキング、リネージ、タグ、CortexといったSnowflakeのガバナンスが完全に適用されます。これが可能になったのは2026年6月下旬、DuckDB 1.5.4、dbt Fusion preview.194以降、そしてSnowflake Horizonの外部書き込みサポートが同時に揃ってリリースされたタイミングです。
Snowflake Summit 2026でSnowflakeは、Iceberg V3への最も幅広いサポートを有し、削除ベクトル、行リネージ、variant型、デフォルト値を含むIcebergへの外部読み書きを可能にした初の完全オープンなカタログであると主張しました。これは検証せずにはいられませんでした。
この「外部書き込み」という側面と、dbtおよびDuckDBの最近の進化により、私がクライアントのために構築したかったレイクハウスの形が実現可能になりました。2026年6月下旬までは不可能だったものです。その姿はこうです:テーブルは自社のクラウドストレージにオープンフォーマットで置かれ、カタログは管理ゼロで、立ち上げが簡単、読み書きもシンプル。どのエンジンからも読め、DuckDBなど他のエンジンからも書き込めます。それでいて、これらのテーブルは依然としてSnowflakeにガバナンスされているのです。1つのカタログ、1つの権限セット、マスキング・リネージ・タグが集約された1つの場所。下層はオープンなストレージ、上層は本物のガバナンスとSnowflake AIです。
- ロード:rawデータをApache Icebergとして自社のS3バケットに着地させます。Snowflakeウェアハウスは一切起動しません。
- 変換:dbtで新しいIcebergテーブルへと変換します。ここでもSnowflakeウェアハウスは起動しません。
- 提供:RBAC、マスキングポリシー、行アクセスポリシー、タグ、リネージ、CortexといったSnowflakeのフルガバナンススタックとともに、AIとBIに提供します。
これを可能にしているのがSnowflake HorizonのIceberg REST Catalogです。外部エンジン(dlt、DuckDB、ラップトップや小さなコンテナで動くdbt)が、このAPIを介してSnowflake管理のIcebergテーブルを直接書き込みます。カタログはSnowflakeが所有し、書き込み時にスコープ付きのS3認証情報を払い出し、実際のコンピュートはエンジン側が担います。出来上がるのは、ファーストクラスのガバナンスされたテーブルです。Snowflakeが遠巻きに扱う外部テーブルではなく、正真正銘の本物です。しかもカタログは最初からそこにあります。セットアップも有効化も不要。Snowflakeに付いてきたのです。
このスタックで最も新しいのは変換ステップです。それ以外の部分は以前から可能でした。実現には3つのリリースが同時に揃う必要がありました。DuckDB 1.5.4はDuckDBがRESTカタログ経由でIcebergにコミットできる書き込み互換オプションを追加し、dbt Fusion preview.194以降はそれらのオプションをcatalogs.yml v2で公開し、Snowflake HorizonはIceberg REST Catalog API経由の外部エンジン書き込みパスを完成させました。2026年6月30日(Fusion 194リリース)より前に試していたら、書き込みは単純に失敗していたはずです。
ここでいう「Iceberg REST Catalog」とは何か
まず用語を整理しましょう。Apache Icebergは、parquetファイルをテーブルのように読み書き(select、insertなど)できるオープンなテーブルフォーマットで、ACIDコミット、スキーマ進化、タイムトラベルを実現するメタデータツリーを備えています。REST Catalogは、現在のメタデータがどこにあるかをエンジンに伝え、SQLコミットを調整するオープンなAPI仕様です。
Snowflake HorizonはこのREST Catalog APIを実装し、Snowflake管理のIcebergテーブルに向けています。つまり、DuckDBやdltがIceberg RESTプロトコルで話しかけると、Snowflakeがカタログとして応答するのです。エンドポイントは次のようになります:
1https://<your-account>.snowflakecomputing.com/polaris/api/catalog
押さえておくべきポイントは2つあります:
- RESTカタログの用語における
warehouseは、Snowflakeのデータベース(以下の例ではICE_RAW)であり、仮想ウェアハウスではありません。この場合、warehouseという単語にコンピュートの意味は含まれません。 - 認証はOAuth2トークン交換です。SnowflakeのProgrammatic Access Token(PAT)を
client_secretとして、session:role:TRANSFORMERのようなスコープとともにHorizonに渡すと、有効期限の短いベアラートークンが返ってきます。あなたのロールと、それに付与されたすべての権限が、このトークンに乗って伝わります。
この2つ目のポイントこそ、ガバナンスの全体像を一文で表しています:カタログはSnowflakeのロール単位でアクセスを払い出すのです。この点を覚えておいてください。「提供」のセクションで再び登場します。
アーキテクチャ全体を1画面で
エンジンからカタログへ向かうすべての矢印はSnowflakeコンピュートを一切使いません。処理はエンジンが行い、Horizonはガバナンスと仲介を担います。データは常にあなたのバケットの中にあります。
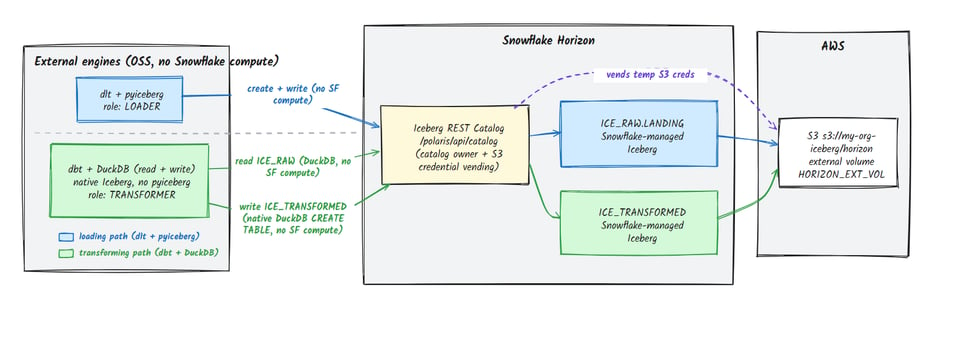
一度きりの土台づくり(そしてそれがカタログ構築ではない理由)
必要なセットアップは驚くほど簡単です。SnowflakeはIcebergカタログのセットアップにまつわる複雑さをほぼすべて取り除きました。用意するのは次の2つです。
- データの置き場所。S3バケットと、それを指すSnowflakeの外部ボリューム、そしてSnowflakeが引き受けるIAMロール。これがオープンレイクハウスにおける「自分のストレージ、自分のバケット」の部分です。
- 誰が触れるか。いくつかのSnowflakeロールと、Programmatic Access Tokenを持つサービスユーザー。これはただのSnowflake RBACです。すでにご存じのものです。
付属のリポジトリはこれらすべてをTerraformと少しのSQLで実現しているので、1行ずつ確認できます。ストレージ:
# tf/snowflake: the external volume + Iceberg-by-default databases
resource "snowflake_external_volume" "horizon" {
  name = "HORIZON_EXT_VOL"
  storage_location {
    storage_location_name = "horizon-s3"
    storage_provider      = "S3"
    storage_base_url      = "s3://my-org-iceberg/horizon/"
    storage_aws_role_arn  = aws_iam_role.snowflake.arn
  }
}

resource "snowflake_database" "ice_raw" {
  name   = "ICE_RAW"
  external_volume = snowflake_external_volume.horizon.name
  catalog  = "SNOWFLAKE"   # Snowflake-managed Iceberg
コードを展開
アクセス:素のRBAC、2つのロール、それらを保持するサービスユーザーだけです。
-- sql/horizon_access.sql (abridged)
CREATE ROLE IF NOT EXISTS LOADER;       -- writes ICE_RAW
CREATE ROLE IF NOT EXISTS TRANSFORMER;  -- reads ICE_RAW, writes ICE_TRANSFORMED

GRANT USAGE ON DATABASE ICE_RAW TO ROLE TRANSFORMER;
GRANT USAGE ON SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON ALL ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;
GRANT SELECT ON FUTURE ICEBERG TABLES IN SCHEMA ICE_RAW.LANDING TO ROLE TRANSFORMER;

GRANT USAGE ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;
GRANT CREATE SCHEMA ON DATABASE ICE_TRANSFORMED TO ROLE TRANSFORMER;

CREATE USER IF NOT EXISTS HORIZON_SVC TYPE = SERVICE;
GRANT ROLE LOADER, TRANSFORMER TO USER HORIZON_SVC;
次にトークンを発行します。各エンジンには、単一のロールだけにスコープを限定したPATを割り当て、最小権限を最初から徹底します:
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_LOAD_PAT DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='LOADER'      COMMENT='dlt loader'"      --role ACCOUNTADMIN
snow sql -q "ALTER USER HORIZON_SVC ADD PAT HORIZON_PAT      DAYS_TO_EXPIRY=7 \
  ROLE_RESTRICTION='TRANSFORMER' COMMENT='dbt transformer'" --role ACCOUNTADMIN
これで終わりです。これが土台のすべて。所有するストレージと、付与するロールだけです。この中でカタログを構築した箇所はどこにもありません。カタログはHorizonであり、Horizonは最初から…オンになっているのです。
💡1時間を無駄にしないための実践的な注意点を1つ:ホスト名にはアンダースコアではなくハイフンを使います。正しくはmyorg-myacct.snowflakecomputing.comで、Pythonのsslはアンダースコア形式を拒否します。curlは許容するため、パイプラインが失敗するまでは動いているように見えてしまいます。
第1の柱:Snowflakeコンピュートなしでロード
完全なコードはリポジトリ(こちら)にあります。このブログでは読みやすさのため、関連するコードを抜粋して紹介します。
ローダーはdltで、オープンソースのfilesystemデスティネーションをtable_format="iceberg"で使い、Horizon RESTカタログに向けています。dlt+も、ライセンス付きコネクタも不要です。dltがparquetを書き込み、pyicebergでカタログ経由のコミットを行い、HorizonがS3認証情報を払い出します。
カタログへの接続情報はdltのsecretsに置きます。Snowflake特有の工夫は1つだけです。Snowflake管理のIcebergはテーブルのロケーションを(外部ボリュームの下に)自ら割り当てるため、クライアントが指定したロケーションを拒否します。そこでdltのcreate_tableをラップしてロケーション指定を省きます:
import dlt
from dlt.destinations import filesystem
import dlt.common.libs.pyiceberg as _ice
import pyarrow as _pa

# Snowflake Horizon assigns the table location under the external volume and
# rejects a client-supplied one, so drop `location` on create. That's the
# intended external-write flow.
def _create_no_location(catalog, table_id, table_location, schema, **kw):
    if isinstance(schema, _pa.Schema):
        schema = _ice.ensure_iceberg_compatible_arrow_schema(schema)
    catalog.create_table(identifier=table_id, schema=schema,
                         partition_spec=kw.get("partition_spec", _ice.UNPARTITIONED_PARTITION_SPEC),
                         properties=kw.get("properties") or {})
_ice.create_table = _create_no_location
コードを展開
実行します:
1uv run python hello_world_pipeline.py
そしてこの瞬間です。Snowflakeに移動すると(今度は人間としてクエリを実行するので、ウェアハウスを使って構いません)、テーブルがそこにあります。ガバナンスが効いていて、クエリ可能で、kindはMANAGEDです:
1SELECT * FROM ICE_RAW.LANDING.HELLO_WORLD;
オープンソースのPythonプロセスが書き込んだ行であり、Snowflakeウェアハウスは一度も起動していません。バイトはあなたのバケットにあり、ガバナンスはSnowflakeのもの。最高ですね。
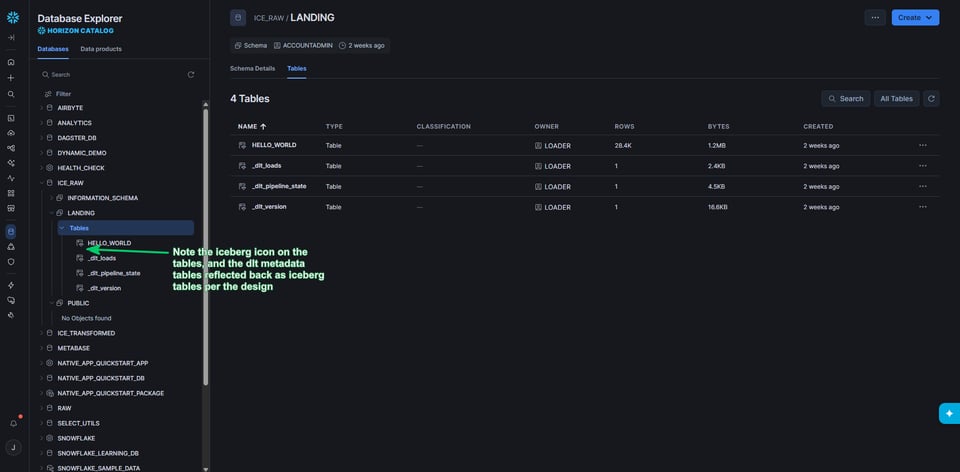
第1の柱のおまけ:
興味本位の実験として、このELジョブをdltHubの新しいSaaSプラットフォームであるdltHub Proでスケジュール実行してみました。「hello」と「world」という単語をSnowflakeに書き込むだけのジョブをスケジュールすることの無意味さは重々承知していますが、新しいおもちゃを前にすると我慢できませんでした。
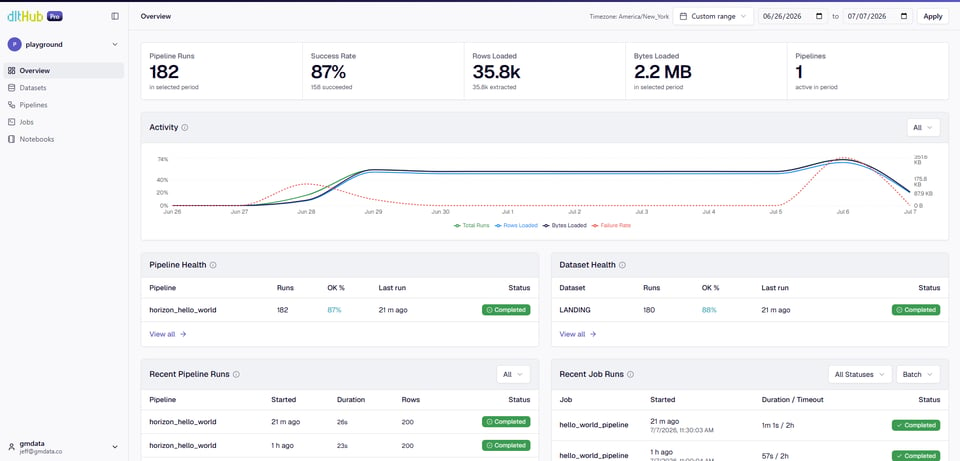
このパイプラインは2週間にわたり、営業時間中30分おきに実行されています。これまでに約200回実行され、コストは約2ドルです。(RESTカタログは遅いことで有名なので、その費用のほとんどは待ち時間に費やされています。)
第2の柱:Snowflakeコンピュートなしで変換
この次のパートが最もエキサイティングです。なぜなら1週間前には不可能だったからです。
変換を担うのはdbtで、実際の処理はDuckDBが行います。DuckDBはHorizon RESTカタログを2回アタッチします。dltが着地させたデータを読むためのICE_RAWと、結果を書き込むためのICE_TRANSFORMEDです。データを読み込み、SQLを実行し、まったく新しいSnowflake管理のIcebergテーブルをカタログ経由でそのまま書き戻します。ごまかしも小細工もありません。
これを可能にしたのは次の組み合わせです。DuckDB 1.5.4がIceberg-REST書き込み互換オプション一式(duckdb-iceberg#1017)を搭載し、dbt Fusion(preview.194以降)がそれらをcatalogs.yml v2で公開しました。4つのオプションによって、DuckDBはHorizonが受け入れる形式どおりにコミットできるようになります。以下がカタログ設定で、書き込みターゲットに肝心の部分があります:
# dbt/catalogs.yml
catalogs:
  - name: ice_raw          # READ
    type: iceberg_rest
    table_format: iceberg
    config:
      duckdb:
        endpoint: " env_var('HORIZON_CATALOG_URI') "
        warehouse: ICE_RAW          # = the Snowflake database
        secret: horizon
        attach_as: ice_raw
        access_delegation_mode: VENDED_CREDENTIALS

  - name: ice_transformed  # WRITE
    type: iceberg_rest
コードを展開
catalogs v2フラグでプロジェクトを有効化し、ステージングモデルを書き込み用カタログにバインドします:
# dbt/dbt_project.yml
flags:
  use_catalogs_v2: true

models:
  horizon_iceberg:
    staging:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: STAGING
    marts:
      +materialized: table
      +catalog_name: ice_transformed
      +schema: MARTS
これらの+schema:の値により、各モデルはICE_TRANSFORMED内のそれぞれのIceberg名前空間(STAGING、MARTS)に着地します。通常のdbtの使い方と同じく、スキーマの事前作成は不要です。dbtは各モデルの前にcreate schema if not existsを実行し(いつもどおり)、DuckDB-icebergがそれをHorizon RESTカタログに対する名前空間作成へと変換します。所有者は作成したtransformerロールです。
💡スキーマ名は大文字のままにしてください。スキーマ作成はduckdbが行うため、Snowflakeの引用符なし識別子の挙動は適用されません。
リポジトリには、ice_rawテーブルをもとに別スキーマへCTASで新しいテーブルを作成できることを示す基本的なステージングモデルと、複数スキーマの使い方をデモするmartsクエリ一式が含まれています。
こちらがSnowflake上のmartsテーブルで、所有者はtransformerロールです:
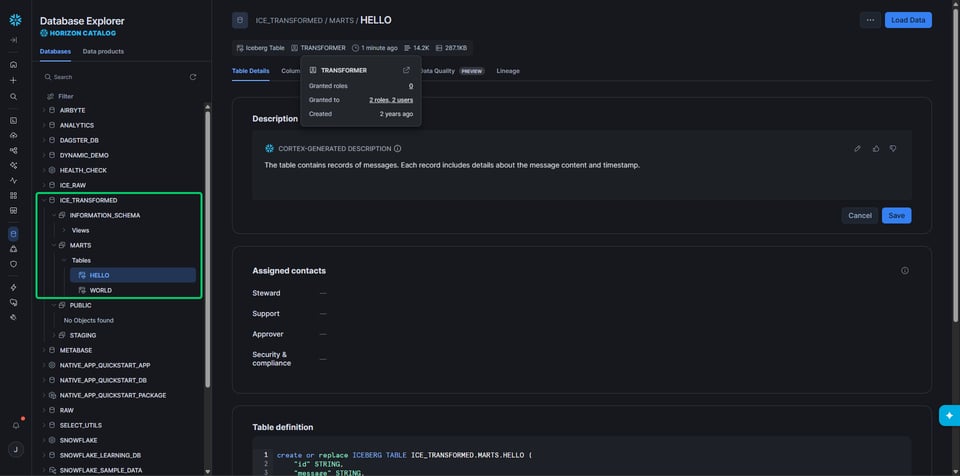
dbtが書き込んだこれらのテーブルがローカルのトリックではなく本物のカタログコミットである証拠が欲しければ、まったく別のエンジン、つまりpyicebergやduckdbからカタログ経由で直接読み戻せます。(リポジトリにはHorizonからテーブルを読むためのduckdbクエリ一式も含まれています。)
import os
from pyiceberg.catalog.rest import RestCatalog
cat = RestCatalog("h", uri=os.environ["HORIZON_CATALOG_URI"], warehouse="ICE_TRANSFORMED",
    credential=os.environ["HORIZON_PAT"], scope="session:role:TRANSFORMER",
    **{"header.X-Iceberg-Access-Delegation": "vended-credentials"})
t = cat.load_table(("STAGING", "stg_hello_world")).scan().to_arrow()
print(t.num_rows, "rows")
Duckdbから直接確認するには、ターミナルでDuckdbを起動して次を実行します。
INSTALL iceberg;

LOAD iceberg;

-- see repo, it will tell you how to generate the token
CREATE OR REPLACE SECRET horizon (
    TYPE ICEBERG,
    TOKEN getenv('HORIZON_TOKEN')
);

-- 3. Attach the Snowflake-managed Iceberg catalog. warehouse = database name (ICE_RAW).
ATTACH 'ICE_RAW' AS horizon (
    TYPE ICEBERG,
    ENDPOINT 'https://myorg-myacct.snowflakecomputing.com/polaris/api/catalog',
    SECRET horizon
コードを展開
dbtで書かれ、DuckDBで実行され、Snowflake内のガバナンスされたIcebergとして着地し、pyicebergで読み戻されたモデル。3つのエンジン、1つのテーブル、1つのカタログ。これこそ、謳い文句どおりに機能するオープンレイクハウスです。
💡Fusionをまだ実行できない場合でも、素のdbt-core + dbt-duckdbと小さなカスタムマテリアライゼーションで同じネイティブ書き込みが可能です。リポジトリではdbt/macros-duckdb/にフォールバックとして同梱されており、dbt-core特有の2つの注意点(dbt-duckdbはfalseのブール型attachオプションを黙って破棄すること、データ追記には明示的なコミットが必要なこと)もドキュメント化されています。Fusionはこの両方を自動で処理してくれるため、本記事の主役となっています。
第3の柱:ガバナンスを効かせてAIとBIに提供
これらはSnowflake管理のテーブルなので、第3の柱の説明はごく短く済みます。Snowflakeで普段行っていることがすべてそのまま機能します。行アクセスポリシー、カラムマスキング、オブジェクトタグ、リネージ、Cortex関数、セマンティックビュー、エージェント、BIツール。特別なIceberg設定は不要です。
DuckLakeより簡単?
数週間前、DuckLakeがいかに簡単かを紹介したデモを公開し、好評をいただきました。しかし、あえて言わせてください。Horizon上のIcebergはそれ以上に簡単なのではないでしょうか?
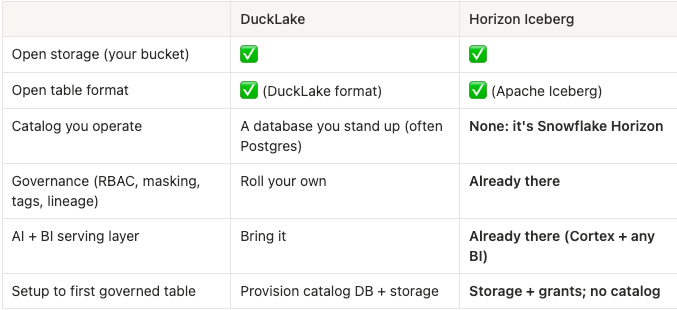
DuckLake Horizon Iceberg オープンストレージ(自分のバケット) ✅ ✅ オープンテーブルフォーマット ✅(DuckLakeフォーマット) ✅(Apache Iceberg) 自分で運用するカタログ 自分で立ち上げるデータベース(多くはPostgres) 不要:Snowflake Horizonがその役割を担う ガバナンス(RBAC、マスキング、タグ、リネージ) 自前で構築 最初から揃っている AI + BIの提供レイヤー 自分で用意 最初から揃っている(Cortex + 任意のBI) 最初のガバナンス付きテーブルまでのセットアップ カタログDB + ストレージのプロビジョニング ストレージ + 権限付与のみ。カタログ不要
カタログの行がすべてを物語っています。DuckLakeではメタデータ用データベースをプロビジョニングし、面倒を見続ける必要があります。ここではその必要がありません。メタデータデータベースはHorizonであり、Horizonを構築したのはあなたではないからです。Snowflakeを購入したら、最初からオンになっていたのです。
これが、多くの人が口々に語る「これ以上ないほど簡単」という感覚の正体です。レイクハウスがより強力になったわけではありません。最も難しいピース(信頼できる、ガバナンスの効いたカタログ)が、実は自分で作らなくてよいピースだったと判明したのです。
試してみる
完全に再現可能なリポジトリはこちらです。READMEに沿った最短手順は次のとおりです:
# 1. Foundation: your storage + Snowflake grants (one time)
cd tf/aws && terraform init && terraform apply
cd ../snowflake && terraform init && terraform apply
snow sql -f sql/horizon_access.sql --role ACCOUNTADMIN

# 2. Load: no Snowflake compute
cd dlt && uv run python hello_world_pipeline.py

# 3. Transform: no Snowflake compute
cd ../dbt && dbt system update && dbt run   # dbt Fusion >= preview.194

# 4. Serve: governed, from Snowflake
snow sql -q "SELECT * FROM ICE_TRANSFORMED.STAGING.STG_HELLO_WORLD"
まとめ
自分のバケットにあるオープンなデータ。構築不要だったカタログ。ウェアハウス時間を消費しないロードと変換。そしてデータが存在した瞬間から、Snowflakeのガバナンスのすべて(RBAC、マスキング、タグ、リネージ、AI)をまとっています。Snowflakeにとって、そのデータは最初から「外部」ではなかったからです。
dbtはOpen Data Infrastructure(そう、新しいバズワードです)を推進しており、dbtをこのビジョンとより親和性の高いものにする動きを進めています。
さあ、実際に試してみてください。Icebergがもう複雑で手強いものに感じられなくなったら、ぜひ教えてください!
Frequently asked
questions
15分以内に使い始められます
Snowflake、Databricks、またはBigQueryのアカウントを接続すれば、削減可能なコストをすぐに把握できます。