

Activer le liquid clustering Databricks tient en une ligne de SQL. Déclarez CLUSTER BY sur une table et Databricks s'occupe du reste. C'est aussi là que s'arrêtent la plupart des explications sur cette fonctionnalité. Or, c'est ce qui se passe ensuite qui détermine réellement si le liquid clustering profite à votre table.
En tirer de la valeur commence par le choix de clés de clustering alignées sur la façon dont la table est interrogée. Il faut aussi comprendre pourquoi OPTIMIZE ignore des fichiers que ZORDER réécrirait encore, décider si CLUSTER BY AUTO convient à la table, et vérifier si le coût de calcul justifie d'aller au-delà de ce que le partitionnement offre déjà.
Le liquid clustering est devenu la recommandation de Databricks pour les nouvelles tables en 2025 et 2026, et la syntaxe est facile à trouver. Choisir la bonne stratégie l'est beaucoup moins — et c'est précisément la question à laquelle cet article répond.
TL;DR
- Les clés de clustering comptent plus que la syntaxe CLUSTER BY. Choisissez des colonnes sur lesquelles les requêtes filtrent fréquemment : les colonnes à faible cardinalité offrent à OPTIMIZE moins d'occasions d'ignorer des fichiers.
- ZORDER réécrit tous les fichiers concernés à chaque exécution. Sur une table en liquid clustering, OPTIMIZE ne re-clusterise que les fichiers écrits ou modifiés depuis l'exécution précédente.
- CLUSTER BY AUTO sélectionne et met à jour les clés de clustering automatiquement, mais nécessite Unity Catalog et Predictive Optimization.
- Même allégées, les exécutions d'OPTIMIZE consomment des Databricks Units (DBU) : comparez donc les coûts de maintenance aux gains de performance des requêtes avant de valider la migration.
Quel est le vrai coût d'une mauvaise organisation des tables ?
Le liquid clustering Databricks existe parce qu'une mauvaise organisation de table engendre des coûts difficiles à corriger. Deux écueils fréquents en sont à l'origine : un mauvais choix de partitionnement et le coût d'OPTIMIZE.
Le mauvais choix de partitionnement survient généralement en premier. Vous choisissez une colonne à la création de la table, avant de savoir comment elle sera interrogée. Databricks a constaté que le partitionnement de type Hive conduit à un sur-partitionnement et à des problèmes de petits fichiers dans plus de 75 % des cas. Delta Lake n'offre aucun moyen de changer cette colonne par la suite : la corriger impose une réécriture complète.
Le coût d'OPTIMIZE vient ensuite. Comme expliqué dans réduire les coûts Databricks au-delà des gains faciles, les équipes exécutent souvent OPTIMIZE ZORDER BY de façon planifiée. Chaque exécution réécrit la table entière, consomme des ressources du warehouse et laisse derrière elle d'anciennes versions de fichiers, que VACUUM ne peut supprimer avant l'expiration de la fenêtre de rétention.
Les ingénieurs décrivent régulièrement le même problème sur les forums de la communauté Databricks. Une table est partitionnée pour un filtre donné, puis un nouveau dashboard ou un nouveau workload commence à interroger une autre colonne, réduisant l'intérêt du partition pruning.
Les requêtes en langage naturel ajoutent encore plus de variabilité à la manière dont les tables sont interrogées. Databricks Genie Explained montre comment Genie transforme des questions en langage courant en SQL sur des tables Delta, créant des workloads de requêtes que votre stratégie de partitionnement n'a jamais été conçue pour absorber.
Databricks a rencontré le même problème sur une table interne de 1,1 Po. Elle était partitionnée par date et heure, mais les ingénieurs filtraient aussi fréquemment sur la source et l'ID. Chaque requête devait parcourir tous les fichiers des partitions date-heure correspondantes pour renvoyer un petit nombre de lignes, alors qu'ajouter la source et l'ID comme colonnes de partition aurait créé des milliards de petits fichiers.
Sur 16 requêtes de production représentatives, la table demandait 406 secondes et scannait 3,5 To de données. Après adoption du liquid clustering, ces mêmes requêtes se sont exécutées en 70 secondes en ne scannant que 0,48 To, soit une accélération de 5,9× avec 86 % de données lues en moins. La taille de la table est également passée de 1,1 Po à 0,8 Po, une réduction de 27 % sans aucune modification des données sous-jacentes.
Qu'est-ce que le Liquid Clustering Databricks ?
Le liquid clustering Databricks remplace deux techniques bien connues : PARTITIONED BY et ZORDER BY. Au lieu de figer l'organisation de la table à sa création, CLUSTER BY vous permet de désigner les colonnes importantes pour vos requêtes, et OPTIMIZE réorganise les données de manière incrémentale pour regrouper les lignes apparentées. Databricks utilise une courbe de remplissage de Hilbert pour organiser les données clusterisées.
Ce mécanisme est en disponibilité générale (GA) pour les tables Delta Lake à partir de Databricks Runtime (DBR) 15.4 LTS. La prise en charge d'Apache Iceberg reste en Public Preview et nécessite DBR 16.4 LTS ou supérieur : soyez donc plus prudent avec les tables Iceberg avant un déploiement en production.
Databricks recommande désormais le liquid clustering automatique pour toutes les tables managées Unity Catalog, et CLUSTER BY est également disponible pour les tables de streaming et les vues matérialisées. La recommandation est simple à énoncer, mais l'essentiel est ailleurs : la façon dont OPTIMIZE entretient cette organisation dans le temps, car son fonctionnement diffère d'une réécriture périodique complète de la table.
Comment fonctionne le liquid clustering sous le capot ?
Le liquid clustering dissocie l'organisation des fichiers de la fréquence à laquelle ils sont réécrits, et ces deux aspects influencent les performances pour des raisons différentes. L'organisation explique pourquoi le liquid clustering ignore plus de fichiers que ZORDER sur une même requête. La fréquence de réécriture explique pourquoi il coûte moins cher à entretenir.
Courbe en Z ou courbe de Hilbert
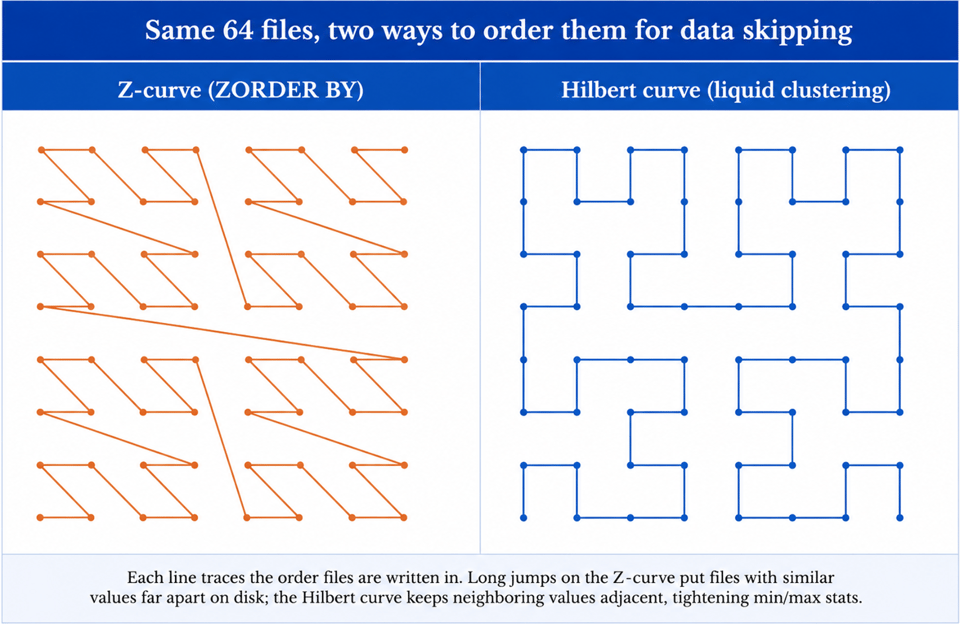
L'organisation commence par la manière dont les fichiers d'une table sont triés au départ. ZORDER BY utilise une courbe en Z, une courbe de remplissage de l'espace qui projette plusieurs valeurs de colonnes sur une seule dimension afin que Delta puisse trier les fichiers selon plusieurs prédicats à la fois. Le liquid clustering utilise une courbe de Hilbert pour le même rôle, et la différence devient plus marquée à mesure que la cardinalité augmente. Une courbe de Hilbert préserve mieux la localité qu'une courbe en Z : les lignes aux valeurs proches sur vos colonnes de clustering se retrouvent plus près les unes des autres sur la courbe, et donc dans les mêmes fichiers.
Cet avantage de localité est le moteur des performances de requêtes. Une localité plus serrée produit des statistiques min/max par fichier plus resserrées, ce qui permet à OPTIMIZE d'ignorer davantage de fichiers lors d'un scan. C'est pourquoi le liquid clustering surpasse ZORDER sur le même ensemble de colonnes dès que les requêtes filtrent sur plusieurs colonnes à la fois.
OPTIMIZE incrémental
Cet avantage de localité coûterait cher à maintenir si chaque exécution d'OPTIMIZE reconstruisait l'organisation de zéro. C'est la fréquence de réécriture qui l'évite. L'OPTIMIZE standard ne re-clusterise que les fichiers écrits ou modifiés depuis l'exécution précédente. Les fichiers déjà positionnés à leurs coordonnées de Hilbert et tailles cibles sont ignorés, conformément au comportement idempotent que Databricks documente pour les commandes d'optimisation de fichiers. Le Z-Ordering n'offre aucune garantie de ce type. Il n'est pas idempotent : une exécution sans restriction de partition peut retraiter des fichiers qu'une passe de Z-Ordering précédente avait déjà traités.
OPTIMIZE FULL écarte volontairement ce comportement incrémental. Il re-clusterise chaque fichier, que quelque chose ait changé ou non, et nécessite Databricks Runtime (DBR) 16.0 LTS ou supérieur. On l'utilise typiquement après un changement de clés de clustering, quand les données historiques doivent adopter la nouvelle organisation immédiatement plutôt qu'au fil du temps.
OPTIMIZE sur une table en liquid clustering ne coûte qu'une fraction de ZORDER sur la même table, car ZORDER réécrit tous les fichiers concernés à chaque exécution, quels que soient les changements. L'optimisation des coûts Databricks explore d'autres postes où les coûts Databricks s'accumulent.
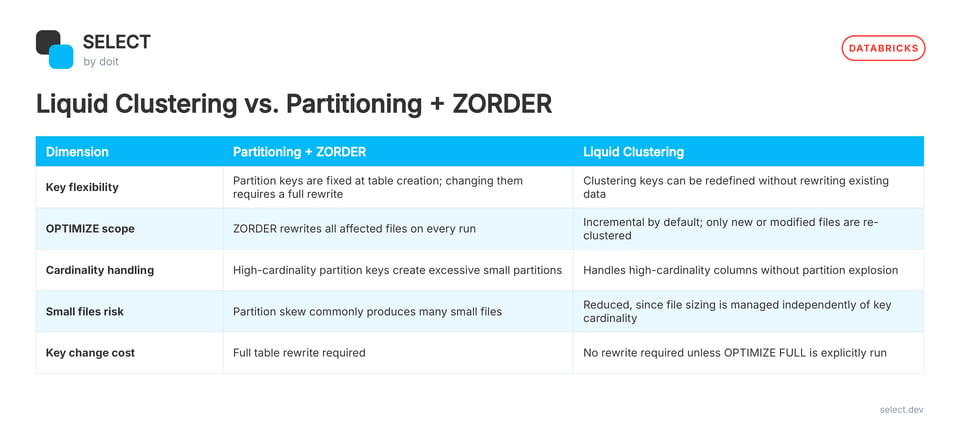
Ce tableau explique pourquoi le liquid clustering ignore les fichiers plus efficacement que ZORDER, mais il ne dit rien des colonnes à inclure dans la clause CLUSTER BY. C'est pourtant là qu'une grande partie de la valeur se gagne ou se perd.
Comment choisir les bonnes clés de clustering ?
Choisissez vos clés de clustering en fonction des filtres les plus fréquents de vos requêtes, en privilégiant les colonnes présentes dans les clauses WHERE et les jointures, y compris celles à forte cardinalité. Le liquid clustering ignore des fichiers grâce aux statistiques min/max stockées plutôt que par séparation physique en dossiers : des millions de valeurs distinctes ne provoquent donc pas l'explosion de petites partitions propre au partitionnement traditionnel.
Les colonnes à faible cardinalité sont généralement moins efficaces. Quand une colonne ne compte qu'une poignée de valeurs distinctes, OPTIMIZE a peu d'occasions d'ignorer des fichiers. La limite de quatre colonnes s'applique toujours, mais deux ou trois colonnes couvrent bien la plupart des tables de production, une quatrième n'apportant souvent que peu de bénéfice supplémentaire.
Corriger de mauvaises clés plus tard est bien moins perturbant que corriger une mauvaise colonne de partition. ALTER TABLE ... CLUSTER BY est une opération portant uniquement sur les métadonnées. Les nouvelles écritures et les exécutions d'OPTIMIZE suivantes adoptent immédiatement les nouvelles clés, tandis que les données existantes conservent leur organisation actuelle jusqu'à ce que vous lanciez OPTIMIZE FULL pour les re-clusteriser selon les nouvelles clés. Vous évitez ainsi la réécriture forcée qu'impose le changement d'une colonne de partition : c'est vous qui décidez quand assumer ce coût, plutôt que de le déclencher au moment du changement.
Les équipes qui préfèrent ne pas gérer les clés de clustering manuellement peuvent utiliser CLUSTER BY AUTO, à condition qu'Unity Catalog et Predictive Optimization soient activés. Databricks analyse l'historique des requêtes et ajuste les clés de clustering à mesure que vos filtres évoluent. Vérifiez ensuite avec DESCRIBE DETAIL : le champ clusteringColumns affiche les clés sélectionnées par AUTO et se met à jour à chaque nouvel ajustement.
Peut-on migrer une table existante vers le liquid clustering ?
Comprendre en quoi le liquid clustering diffère du partitionnement et du Z-order n'a d'intérêt que si vous disposez d'un moyen concret de migrer vos tables existantes. Le liquid clustering ne peut pas coexister avec PARTITIONED BY ou ZORDER BY. Une table utilise l'une ou l'autre approche : la migration remplace donc les deux, elle ne s'ajoute pas par-dessus.
Le processus de migration dépend de votre version de runtime. Sur Databricks Runtime (DBR) 18.1 et supérieur, une seule instruction suffit : ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (...). Cette commande supprime le schéma de partitionnement existant et définit les clés de clustering en une seule étape. Les runtimes antérieurs ne la prennent pas en charge. La solution habituelle consiste à créer une nouvelle table non partitionnée avec CLUSTER BY via un CTAS, à la remplir par lots de plages de dates, puis à échanger les noms de tables une fois la nouvelle table prête.
Les colonnes de clustering comptent plus que la méthode de migration. Dans la mesure du possible, restez proche des colonnes auparavant utilisées pour le partitionnement. Databricks recommande cette approche, car un ensemble de colonnes très différent peut déclencher un re-clustering massif lors de la première exécution d'OPTIMIZE au lieu d'un passage incrémental plus léger.
Après la conversion, cessez d'exécuter OPTIMIZE avec ZORDER BY. L'OPTIMIZE standard prend le relais à partir de ce moment. La première exécution traite les données écrites depuis la dernière opération de Z-order, puis les suivantes restent incrémentales. Les exemples ci-dessous illustrent les deux chemins de migration : l'approche ALTER TABLE pour DBR 18.1 et supérieur, et le repli CTAS pour les runtimes antérieurs.
-- DBR 18.1 and above
ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (event_ts, user_id);

OPTIMIZE events;
-- Plain OPTIMIZE is sufficient here. The table was not previously clustered,
-- so there is no existing clustering state to reconcile.
-- Older runtimes (before DBR 18.1): CTAS fallback
CREATE OR REPLACE TABLE events_v2
CLUSTER BY (event_ts, user_id)
AS SELECT * FROM events
WHERE event_ts >= '2024-01-01' AND event_ts < '2025-01-01';

INSERT INTO events_v2
SELECT * FROM events
WHERE event_ts >= '2023-01-01' AND event_ts < '2024-01-01';

-- Repeat for each date range, then swap table names
OPTIMIZE events_v2;
-- Cluster the newly inserted data before the swap
Les deux approches aboutissent au même résultat : un processus OPTIMIZE concentré sur les données nouvellement écrites ou modifiées plutôt que des réécritures complètes et répétées de la table. Reste à savoir ce que ce changement implique côté coûts, et si les économies justifient la migration.
Combien coûte OPTIMIZE, et que vous montre SELECT ?
Le Liquid Clustering réduit le coût récurrent d'OPTIMIZE, mais chaque exécution consomme toujours du compute Databricks et des Databricks Units (DBU), la métrique sur laquelle Databricks facture. Photon peut encore influer sur ce coût. Bien que Photon ait un tarif DBU plus élevé, il traite souvent moins de données sur une table en liquid clustering, puisque OPTIMIZE travaille de façon incrémentale au lieu de réécrire de larges portions de la table. Le surcoût s'applique donc à un workload plus réduit.
Predictive Optimization supprime la charge de planification. Une fois la fonctionnalité activée sur une table managée Unity Catalog, Databricks décide quand OPTIMIZE s'exécute et enregistre la consommation sous le SKU predictive_optimization dans system.billing.usage, aux côtés des autres activités facturables de votre compte.
Savoir qu'OPTIMIZE consomme des DBU est utile. Voir combien un job précis en a consommé dans le temps, c'est ce qui permet de valider que la migration a bien généré les économies attendues. Le lancement de SELECT pour Databricks en juin 2026 a été conçu pour ce niveau de visibilité, avec une attribution des DBU suffisamment fine pour suivre chaque job OPTIMIZE par cluster et par workload.
Les équipes qui souhaitent comparer les coûts d'OPTIMIZE avant et après migration peuvent réserver une démo de SELECT pour Databricks et se connecter en 20 minutes environ.
Frequently asked
questions
Le Liquid Clustering fonctionne-t-il sur les tables de streaming et les vues matérialisées ?
Oui. Le liquid clustering s'applique aux tables de streaming et aux vues matérialisées comme aux tables Delta standard. Vous déclarez CLUSTER BY de la même manière, et OPTIMIZE réorganise les fichiers de façon cohérente sur les trois types de tables.
Puis-je encore utiliser OPTIMIZE sur une table en Liquid Clustering ?
Oui. OPTIMIZE est la commande qu'utilise Databricks pour entretenir les tables en liquid clustering, la même que celle utilisée ailleurs pour la compaction de partitions et le Z-order. L'OPTIMIZE standard ne re-clusterise que les fichiers nouveaux ou modifiés, tandis qu'OPTIMIZE FULL, disponible sur Databricks Runtime (DBR) 16.0 LTS et supérieur, force un re-clustering complet. ZORDER BY n'est pas pris en charge sur une table clusterisée.
Qu'est-ce que CLUSTER BY AUTO et quand l'utiliser ?
CLUSTER BY AUTO permet à Databricks de sélectionner et de mettre à jour les clés de clustering en analysant l'historique des requêtes, à condition qu'Unity Catalog et Predictive Optimization soient activés. Il convient bien aux tables dont les workloads évoluent dans le temps, ou aux équipes qui préfèrent ne pas gérer la sélection des clés manuellement.
Comment vérifier sur quelles colonnes une table est clusterisée ?
Exécutez DESCRIBE DETAIL sur la table. Le champ clusteringColumns affiche les clés de clustering actuelles. Lorsque CLUSTER BY AUTO est activé, le champ se met à jour à mesure que Databricks ajuste la sélection des clés.
Quand conserver le partitionnement plutôt que de passer au Liquid Clustering ?
Le liquid clustering est généralement le meilleur choix par défaut pour les jeux de données entre 1 To et 100 To. Pour des workloads plus volumineux, testez-le avant de trancher en faveur du partitionnement. Le partitionnement reste pertinent quand les requêtes ciblent systématiquement une tranche étroite de données, comme une seule journée, car l'élagage de répertoires y demeure très efficace.
Niall Woodward·Co-fondateur & CTO de SELECT
Niall est Co-fondateur et CTO de SELECT, une plateforme SaaS de gestion et d'optimisation des coûts Snowflake. Avant de lancer SELECT, Niall était data engineer chez Brooklyn Data Company et dans plusieurs startups. Passionné d'open source, il est également mainteneur de SQLFluff et créateur de trois packages dbt : dbt_artifacts, dbt_snowflake_monitoring et dbt_query_tags.
Opérationnel en moins de 15 minutes
Connectez votre compte Snowflake, Databricks ou BigQuery et découvrez instantanément votre potentiel d'économies.