

Habilitar o liquid clustering no Databricks exige apenas uma linha de SQL. Declare CLUSTER BY em uma tabela e o Databricks cuida do resto. Essa única linha também é onde a maioria das explicações sobre o recurso para. O que acontece depois dela é o que realmente determina se o liquid clustering vai ajudar a sua tabela.
Extrair valor desse recurso começa pela escolha de clustering keys que reflitam como a tabela é consultada. Também significa entender por que o OPTIMIZE pula arquivos que o ZORDER ainda reescreveria, decidir se o CLUSTER BY AUTO faz sentido para a tabela e avaliar se o custo de computação justifica ir além do que o particionamento já oferece.
O liquid clustering se tornou a recomendação do Databricks para novas tabelas ao longo de 2025 e 2026, e a sintaxe é fácil de encontrar. Escolher a estratégia certa é mais difícil, e é essa a pergunta que este artigo responde.
Resumo
- As clustering keys importam mais do que a sintaxe do CLUSTER BY. Escolha colunas que as consultas filtram com frequência, já que colunas de baixa cardinalidade dão ao OPTIMIZE menos oportunidades de pular arquivos.
- O ZORDER reescreve todos os arquivos afetados a cada execução. O OPTIMIZE em uma tabela com liquid clustering reorganiza apenas os arquivos gravados ou modificados desde a execução anterior.
- O CLUSTER BY AUTO seleciona e atualiza as clustering keys automaticamente, mas exige Unity Catalog e Predictive Optimization.
- Execuções mais leves do OPTIMIZE ainda consomem Databricks Units (DBUs), então compare os custos de manutenção com os ganhos de performance das consultas ao avaliar a migração.
Qual é o custo real de errar o layout da tabela?
O liquid clustering do Databricks existe porque um layout de tabela ruim gera custos difíceis de reverter. Dois cenários de falha são os mais comuns: o arrependimento na escolha da partição e o custo do OPTIMIZE.
O arrependimento na escolha da partição costuma vir primeiro. Você escolhe uma coluna no momento da criação, antes de saber como a tabela será consultada. O Databricks constatou que o particionamento no estilo Hive leva a excesso de partições e problemas de arquivos pequenos em mais de 75% dos casos. O Delta Lake não oferece nenhuma forma de trocar essa coluna depois, então corrigir o erro exige uma reescrita completa.
O custo do OPTIMIZE vem em seguida. Como abordado em como reduzir custos do Databricks além dos ganhos fáceis, muitas equipes executam OPTIMIZE ZORDER BY de forma agendada. Cada execução reescreve a tabela inteira, consumindo recursos do warehouse e deixando versões antigas de arquivos para trás, já que o VACUUM não consegue removê-las antes do fim da janela de retenção.
Engenheiros nos fóruns da comunidade Databricks descrevem com frequência o mesmo problema. Uma tabela é particionada para um filtro específico, e então um novo dashboard ou workload começa a consultar outra coluna, reduzindo o valor do partition pruning.
As consultas em linguagem natural estão adicionando ainda mais variação à forma como as tabelas são consultadas. Databricks Genie Explained mostra como o Genie transforma perguntas em linguagem comum em SQL sobre tabelas Delta, criando workloads de consulta que sua estratégia de particionamento nunca foi projetada para atender.
O próprio Databricks enfrentou esse problema em uma tabela interna de 1,1 PB. Ela era particionada por data e hora, mas os engenheiros também filtravam com frequência por origem e ID. Cada requisição precisava varrer todos os arquivos das partições de data e hora correspondentes para retornar um número pequeno de linhas, enquanto adicionar origem e ID como colunas de partição teria criado bilhões de arquivos pequenos.
Em 16 consultas de produção representativas, a tabela levava 406 segundos e varria 3,5 TB de dados. Após a adoção do liquid clustering, essas mesmas consultas passaram a ser concluídas em 70 segundos varrendo 0,48 TB, uma aceleração de 5,9× com 86% menos dados lidos. O tamanho da tabela também caiu de 1,1 PB para 0,8 PB, uma redução de 27% sem nenhuma mudança nos dados em si.
O que é o Liquid Clustering do Databricks?
O liquid clustering do Databricks substitui duas técnicas conhecidas: PARTITIONED BY e ZORDER BY. Em vez de fixar o layout da tabela na criação, o CLUSTER BY permite nomear as colunas que importam para as suas consultas, e o OPTIMIZE reorganiza os dados de forma incremental para aproximar linhas relacionadas. O Databricks usa uma curva de preenchimento de espaço de Hilbert para organizar os dados clusterizados.
Esse mecanismo atingiu a Disponibilidade Geral (GA) para tabelas Delta Lake no Databricks Runtime (DBR) 15.4 LTS e superior. O suporte ao Apache Iceberg continua em Public Preview e exige DBR 16.4 LTS ou superior, então trate tabelas Iceberg com mais cautela antes de levá-las para produção.
O Databricks agora recomenda o liquid clustering automático para todas as tabelas gerenciadas do Unity Catalog, enquanto o CLUSTER BY também está disponível para streaming tables e materialized views. Essa orientação é fácil de enunciar, mas o que importa mais é como o OPTIMIZE mantém o layout ao longo do tempo, já que ele funciona de maneira diferente de uma reescrita periódica da tabela inteira.
Como o liquid clustering do Databricks funciona por baixo dos panos?
O liquid clustering separa a organização dos arquivos da frequência com que eles são reescritos, e ambos afetam a performance por motivos diferentes. A organização explica por que o liquid clustering pula mais arquivos do que o ZORDER na mesma consulta. A frequência de reescrita explica por que ele custa menos para manter.
Curva Z vs. curva de Hilbert
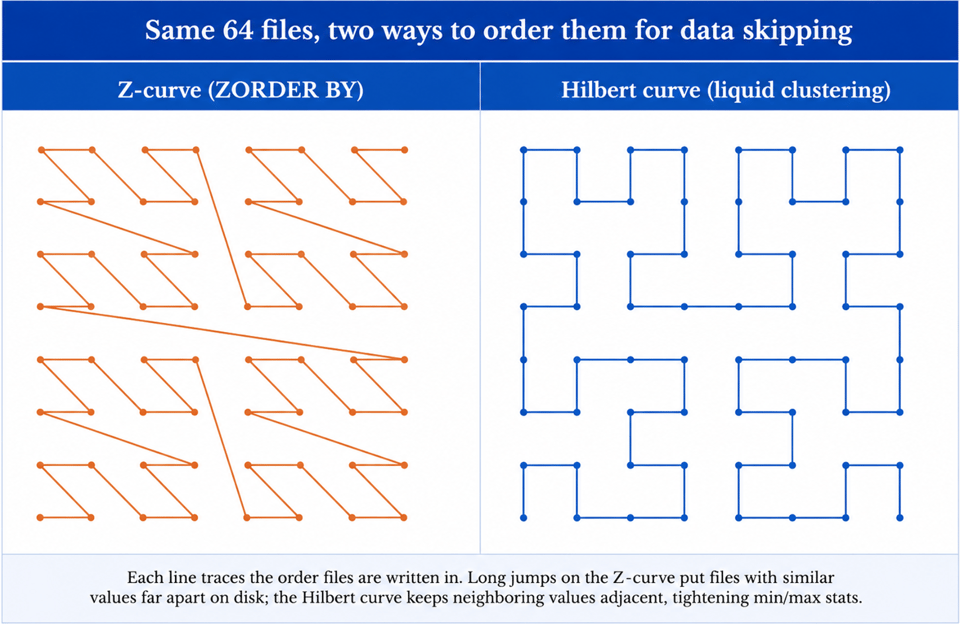
A organização começa pela forma como os arquivos de uma tabela são ordenados em primeiro lugar. O ZORDER BY usa uma curva Z, uma curva de preenchimento de espaço que mapeia valores de várias colunas em uma única dimensão para que o Delta possa ordenar arquivos por mais de um predicado ao mesmo tempo. O liquid clustering usa uma curva de Hilbert para a mesma tarefa, e a diferença fica mais perceptível conforme a cardinalidade aumenta. Uma curva de Hilbert preserva a localidade melhor do que uma curva Z, então linhas com valores semelhantes nas colunas de clustering ficam mais próximas na curva e, portanto, nos mesmos arquivos.
Essa vantagem de localidade é o que impulsiona a performance das consultas. Uma localidade mais compacta produz estatísticas min/max por arquivo mais restritas, o que permite ao OPTIMIZE pular mais arquivos durante uma varredura. É por isso que o liquid clustering supera o ZORDER no mesmo conjunto de colunas quando as consultas filtram por mais de uma coluna ao mesmo tempo.
OPTIMIZE incremental
Essa vantagem de localidade sairia cara de manter se cada execução do OPTIMIZE reconstruísse o layout do zero. A frequência de reescrita é o que impede isso. O OPTIMIZE padrão reorganiza apenas arquivos gravados ou modificados desde a execução anterior. Arquivos que já estão nas coordenadas de Hilbert e nos tamanhos alvo são ignorados, de forma consistente com o comportamento idempotente que o Databricks documenta para comandos de otimização de arquivos. O Z-Ordering não oferece essa garantia. Ele não é idempotente, então uma execução sem escopo de partição pode reprocessar arquivos que uma passagem anterior de Z-Ordering já tocou.
O OPTIMIZE FULL deixa esse comportamento incremental de lado de propósito. Ele reorganiza todos os arquivos, independentemente de algo ter mudado, e exige Databricks Runtime (DBR) 16.0 LTS ou superior. Você normalmente o usaria após trocar as clustering keys, quando os dados históricos precisam adotar o novo layout imediatamente, em vez de gradualmente.
O OPTIMIZE em uma tabela com liquid clustering custa uma fração do ZORDER na mesma tabela porque o ZORDER reescreve todos os arquivos afetados a cada execução, independentemente do que mudou. Otimização de custos do Databricks explora outras áreas em que os custos do Databricks se acumulam.
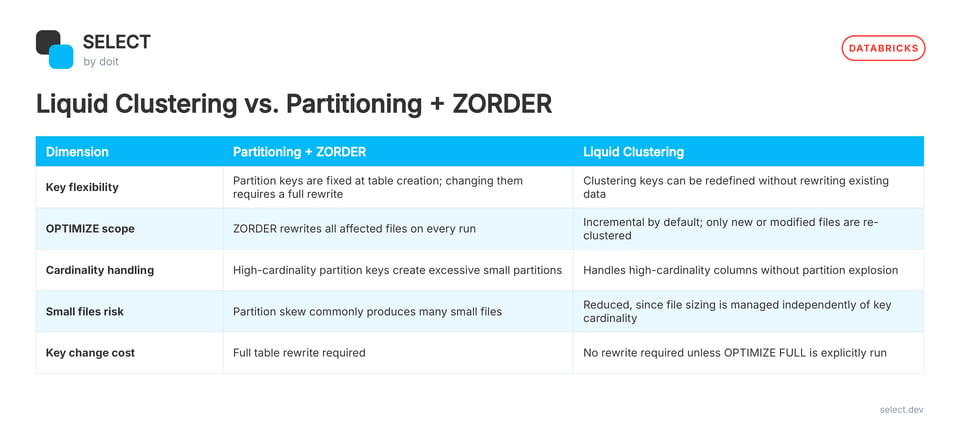
Essa tabela explica por que o liquid clustering pula arquivos com mais eficiência do que o ZORDER, mas não diz nada sobre quais colunas devem entrar na cláusula CLUSTER BY. É nessa escolha que boa parte do valor se ganha ou se perde.
Como escolher as clustering keys certas?
Escolha as clustering keys com base no que suas consultas mais filtram, priorizando colunas que aparecem em cláusulas WHERE e joins, incluindo as de alta cardinalidade. O liquid clustering pula arquivos usando estatísticas min/max armazenadas, e não separação física em pastas, então milhões de valores distintos não geram a explosão de partições pequenas que acompanha o particionamento tradicional.
Colunas de baixa cardinalidade costumam ser menos eficazes. Quando uma coluna tem apenas um punhado de valores distintos, o OPTIMIZE tem pouca oportunidade de pular arquivos. O limite de quatro colunas continua valendo, mas duas ou três colunas atendem bem à maioria das tabelas de produção, enquanto uma quarta geralmente agrega pouco benefício adicional.
Corrigir keys erradas depois é muito menos disruptivo do que corrigir uma coluna de partição errada. ALTER TABLE ... CLUSTER BY é uma operação que afeta apenas metadados. Novas gravações e execuções subsequentes do OPTIMIZE adotam as keys atualizadas imediatamente, enquanto os dados existentes mantêm o layout atual até que você execute OPTIMIZE FULL para reorganizá-los sob as novas keys. Isso ainda evita a reescrita forçada exigida ao trocar uma coluna de partição, já que você decide quando assumir esse custo, em vez de dispará-lo durante a mudança.
Equipes que preferem não gerenciar clustering keys manualmente podem usar o CLUSTER BY AUTO, desde que o Unity Catalog e o Predictive Optimization estejam habilitados. O Databricks analisa o histórico de consultas e ajusta as clustering keys conforme seus filtros mudam. Depois, confira com DESCRIBE DETAIL. O campo clusteringColumns mostra as keys que o AUTO selecionou e é atualizado sempre que isso acontece de novo.
É possível migrar uma tabela existente para o liquid clustering?
Entender como o liquid clustering difere do particionamento e do Z-order só se torna útil quando existe um caminho prático para migrar tabelas existentes. O liquid clustering não pode coexistir com PARTITIONED BY ou ZORDER BY. Uma tabela usa uma abordagem ou outra, então a migração substitui ambas em vez de adicionar o clustering por cima.
O processo de migração depende da versão do runtime. No Databricks Runtime (DBR) 18.1 e superior, uma única instrução resolve a conversão: ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (...). Esse comando remove o esquema de particionamento existente e define as clustering keys em uma única etapa. Runtimes anteriores não oferecem suporte a ele. O caminho alternativo mais comum é criar uma nova tabela sem particionamento com CLUSTER BY usando CTAS, preenchê-la em lotes por intervalo de datas e, então, trocar os nomes das tabelas quando a nova estiver pronta.
As colunas de clustering importam mais do que o método de migração. Sempre que possível, mantenha-as próximas das colunas usadas anteriormente no particionamento. O Databricks recomenda essa abordagem porque um conjunto de colunas muito diferente pode disparar um esforço de reclusterização maior na primeira execução do OPTIMIZE, em vez de uma execução incremental mais leve.
Após a conversão, pare de executar OPTIMIZE com ZORDER BY. O OPTIMIZE padrão assume dali em diante. A primeira execução processa os dados gravados desde a última operação de Z-order, enquanto as execuções seguintes continuam incrementais. Os exemplos abaixo mostram os dois caminhos de migração: a abordagem com ALTER TABLE para DBR 18.1 e superior e o fallback com CTAS para runtimes anteriores.
-- DBR 18.1 e superior
ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (event_ts, user_id);

OPTIMIZE events;
-- O OPTIMIZE simples é suficiente aqui. A tabela não era clusterizada antes,
-- então não há estado de clustering anterior para reconciliar.
-- Runtimes mais antigos (antes do DBR 18.1): fallback com CTAS
CREATE OR REPLACE TABLE events_v2
CLUSTER BY (event_ts, user_id)
AS SELECT * FROM events
WHERE event_ts >= '2024-01-01' AND event_ts < '2025-01-01';

INSERT INTO events_v2
SELECT * FROM events
WHERE event_ts >= '2023-01-01' AND event_ts < '2024-01-01';

-- Repita para cada intervalo de datas e depois troque os nomes das tabelas
OPTIMIZE events_v2;
-- Clusterize os dados recém-inseridos antes da troca
As duas abordagens chegam ao mesmo resultado: um processo de OPTIMIZE focado em dados recém-gravados ou modificados, em vez de reescritas completas e repetidas da tabela. A próxima pergunta é o que essa mudança significa em custo, e se a economia justifica a migração.
Quanto custa o OPTIMIZE, e o que o SELECT mostra?
O Liquid Clustering reduz o custo contínuo do OPTIMIZE, mas cada execução ainda consome computação do Databricks e Databricks Units (DBUs), a métrica que o Databricks usa para cobrar. O Photon pode afetar esse custo ainda mais. Embora o Photon tenha uma taxa de DBU mais alta, ele frequentemente processa menos dados em uma tabela com liquid clustering, porque o OPTIMIZE funciona de forma incremental em vez de reescrever grandes porções da tabela. Como resultado, esse custo extra se aplica a um workload menor.
O Predictive Optimization elimina o trabalho de agendamento. Quando habilitado em uma tabela gerenciada do Unity Catalog, o Databricks decide quando o OPTIMIZE é executado e registra o uso sob o SKU predictive_optimization em system.billing.usage, junto com as demais atividades faturáveis da sua conta.
Saber que o OPTIMIZE consome DBUs é útil. Ver quantas DBUs um job específico consumiu ao longo do tempo é o que valida se uma migração entregou a economia esperada. O lançamento do SELECT para Databricks, em junho de 2026, foi criado para esse nível de visibilidade, oferecendo atribuição de DBUs granular o suficiente para rastrear jobs individuais de OPTIMIZE por cluster e workload.
Equipes que querem comparar os custos do OPTIMIZE antes e depois de uma migração podem agendar uma demo do SELECT para Databricks e conectar tudo em cerca de 20 minutos.
Frequently asked
questions
O Liquid Clustering funciona em streaming tables e materialized views?
Sim. O liquid clustering se aplica a streaming tables e materialized views, além das tabelas Delta padrão. Você declara CLUSTER BY da mesma forma, e o OPTIMIZE reorganiza os arquivos de maneira consistente nos três tipos de tabela.
Ainda posso usar OPTIMIZE em uma tabela com Liquid Clustering?
Sim. O OPTIMIZE é o comando que o Databricks usa para manter tabelas com liquid clustering, o mesmo usado para compactação de partições e Z-order em outros contextos. O OPTIMIZE padrão reorganiza apenas arquivos novos ou modificados, enquanto o OPTIMIZE FULL, disponível no Databricks Runtime (DBR) 16.0 LTS e superior, força uma reclusterização completa. O ZORDER BY não é suportado em uma tabela clusterizada.
O que é o CLUSTER BY AUTO e quando devo usá-lo?
O CLUSTER BY AUTO permite que o Databricks selecione e atualize as clustering keys analisando o histórico de consultas, desde que o Unity Catalog e o Predictive Optimization estejam habilitados. Funciona bem para tabelas cujos workloads mudam ao longo do tempo ou para equipes que preferem não gerenciar a seleção de keys manualmente.
Como verifico por quais colunas uma tabela está clusterizada?
Execute DESCRIBE DETAIL na tabela. O campo clusteringColumns mostra as clustering keys atuais. Quando o CLUSTER BY AUTO está habilitado, o campo é atualizado conforme o Databricks ajusta a seleção de keys ao longo do tempo.
Quando devo manter o particionamento em vez de migrar para o Liquid Clustering?
O liquid clustering costuma ser o melhor padrão para datasets entre 1 TB e 100 TB. Para workloads maiores, teste antes de decidir pelo particionamento. O particionamento ainda faz sentido quando as consultas visam consistentemente uma fatia estreita dos dados, como um único dia, já que o directory pruning continua altamente eficaz nessa situação.
Niall Woodward·Cofundador e CTO do SELECT
Niall é cofundador e CTO do SELECT, uma plataforma SaaS de gestão e otimização de custos do Snowflake. Antes de fundar o SELECT, Niall foi engenheiro de dados na Brooklyn Data Company e em várias startups. Entusiasta de open source, ele também é mantenedor do SQLFluff e criador de três pacotes dbt: dbt_artifacts, dbt_snowflake_monitoring e dbt_query_tags.
Comece a usar em menos de 15 minutos
Conecte sua conta do Snowflake, Databricks ou BigQuery e entenda na hora seu potencial de economia.