

Databricksのliquid clusteringを有効化するのに必要なSQLはわずか1行です。テーブルにCLUSTER BYを宣言すれば、あとはDatabricksが処理してくれます。そして多くの解説は、この1行の説明で終わってしまいます。しかし、liquid clusteringが実際にテーブルの役に立つかどうかを決めるのは、その後に起こることなのです。
この機能から価値を引き出すには、まずテーブルのクエリパターンに合ったクラスタリングキーを選ぶことが欠かせません。さらに、ZORDERなら書き換えるはずのファイルをOPTIMIZEがスキップする理由を理解すること、CLUSTER BY AUTOがそのテーブルに適しているかを判断すること、そしてパーティショニングですでに得られる効果を超えるために、コンピュートコストをかける価値があるかを見極めることも必要です。
Liquid clusteringは、2025年から2026年にかけてDatabricksが新規テーブルに推奨する手法となっており、構文自体は簡単に見つかります。難しいのは正しい戦略の選択であり、本記事はその問いに答えます。
TL;DR
- CLUSTER BYの構文よりもクラスタリングキーの選択が重要です。クエリで頻繁にフィルタされる列を選びましょう。カーディナリティの低い列では、OPTIMIZEがファイルをスキップできる機会が限られます。
- ZORDERは実行のたびに対象となるすべてのファイルを書き換えます。liquid clusteringされたテーブルに対するOPTIMIZEは、前回の実行以降に書き込みまたは変更されたファイルのみを再クラスタリングします。
- CLUSTER BY AUTOはクラスタリングキーを自動的に選択・更新しますが、Unity CatalogとPredictive Optimizationが必要です。
- 軽量化されたOPTIMIZEの実行でもDatabricks Unit(DBU)は消費されるため、移行を評価する際はメンテナンスコストとクエリパフォーマンスの改善を比較しましょう。
テーブルレイアウトを誤る本当のコストとは?
Databricksのliquid clusteringが生まれた背景には、不適切なテーブルレイアウトが取り返しのつかないコストを生むという問題があります。その要因となる典型的な失敗パターンは2つ、パーティション選択の後悔とOPTIMIZEのコストです。
まず先に訪れるのがパーティション選択の後悔です。テーブルがどのようにクエリされるか分からないまま、作成時に列を選ばなければなりません。Databricksの調査によれば、Hiveスタイルのパーティショニングは75%以上のケースで過剰なパーティション分割や小さなファイルの問題を引き起こしています。Delta Lakeでは後からその列を変更する手段がないため、修正にはテーブル全体の書き換えが必要です。
次に来るのがOPTIMIZEのコストです。簡単な施策の先にあるDatabricksコスト削減で取り上げたとおり、OPTIMIZE ZORDER BYをスケジュール実行しているチームは少なくありません。実行のたびにテーブル全体が書き換えられてウェアハウスのリソースを消費し、古いファイルバージョンが残り続けます。保持期間が過ぎるまでVACUUMで削除できないためです。
Databricksのコミュニティフォーラムでも、エンジニアが同じ問題を繰り返し報告しています。あるフィルタ向けにパーティション分割したテーブルに対して、新しいダッシュボードやワークロードが別の列でクエリを始め、パーティションプルーニングの効果が薄れてしまうのです。
自然言語によるクエリの普及で、テーブルへのクエリパターンはさらに多様化しています。Databricks Genie Explainedでは、Genieが平易な英語の質問をDeltaテーブルへのSQLに変換する仕組みを解説していますが、これはパーティショニング戦略が想定していなかったクエリワークロードを生み出します。
Databricks自身も1.1PBの社内テーブルで同じ問題に直面しました。このテーブルは日付と時間でパーティション分割されていましたが、エンジニアはソースとIDでも頻繁にフィルタしていました。各リクエストは、少数の行を返すために該当する日付・時間パーティション内のすべてのファイルをスキャンする必要があり、かといってソースとIDをパーティション列に追加すれば、数十億の小さなファイルが生まれてしまう状況でした。
代表的な16本の本番クエリで計測したところ、このテーブルでは406秒かかり、3.5TBのデータをスキャンしていました。liquid clustering導入後、同じクエリは70秒で完了し、スキャン量は0.48TBになりました。5.9倍の高速化と86%のデータ読み取り削減です。テーブルサイズも1.1PBから0.8PBへと27%減少し、元のデータには一切変更を加えていません。
Databricks Liquid Clusteringとは?
Databricksのliquid clusteringは、PARTITIONED BYとZORDER BYというおなじみの2つの手法を置き換えるものです。テーブル作成時にレイアウトを固定するのではなく、CLUSTER BYでクエリにとって重要な列を指定すれば、OPTIMIZEが関連する行を近くに配置するようデータを段階的に再編成します。クラスタリングされたデータの編成には、Databricksはヒルベルト空間充填曲線を使用しています。
この仕組みは、Databricks Runtime(DBR)15.4 LTS以上のDelta Lakeテーブルで一般提供(GA)に達しています。Apache IcebergのサポートはまだPublic Previewの段階で、DBR 16.4 LTS以上が必要なため、Icebergテーブルの本番展開はより慎重に判断してください。
現在Databricksは、Unity Catalogのすべてのマネージドテーブルに対して自動liquid clusteringを推奨しており、CLUSTER BYはストリーミングテーブルやマテリアライズドビューでも利用できます。この推奨自体はシンプルですが、より重要なのはOPTIMIZEが時間の経過とともにレイアウトをどう維持するかです。定期的なテーブル全体の書き換えとは動作が異なるからです。
Databricks Liquid Clusteringの内部の仕組み
Liquid clusteringは、ファイルの編成方法と書き換え頻度を切り離しており、どちらも異なる理由でパフォーマンスに影響します。編成方法は、同じクエリに対してliquid clusteringがZORDERよりも多くのファイルをスキップできる理由を説明します。書き換え頻度は、維持コストが低く済む理由を説明します。
Z曲線とヒルベルト曲線
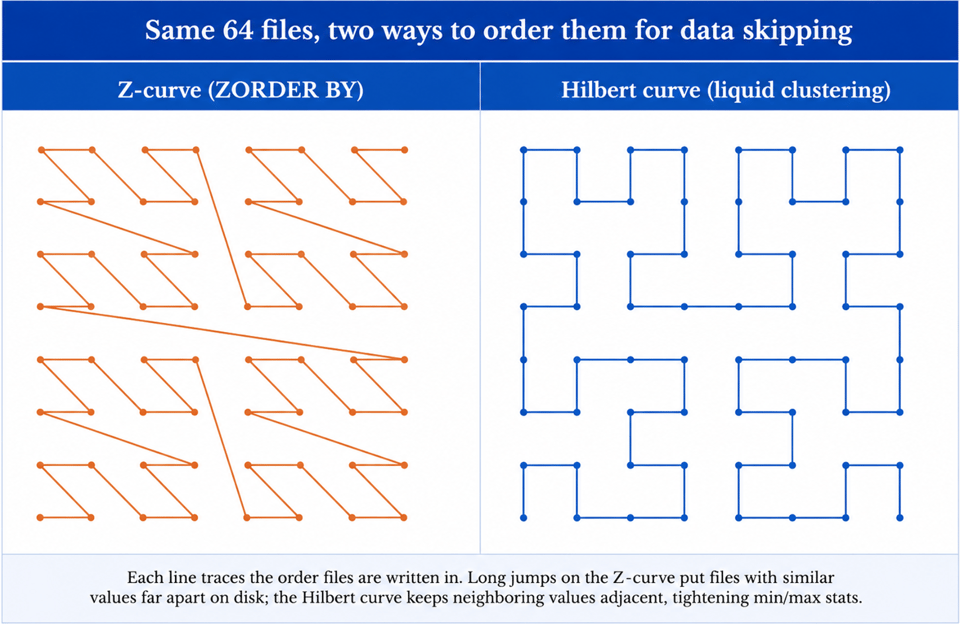
編成の出発点は、そもそもテーブルのファイルがどうソートされるかです。ZORDER BYはZ曲線という空間充填曲線を使い、複数の列の値を1次元にマッピングすることで、Deltaが複数の述語で同時にファイルをソートできるようにします。Liquid clusteringは同じ役割にヒルベルト曲線を使用しており、その違いはカーディナリティが上がるほど顕著になります。ヒルベルト曲線はZ曲線よりも局所性をよく保持するため、クラスタリング列全体で似た値を持つ行が曲線上で近くに配置され、結果として同じファイルに収まります。
この局所性の高さがクエリパフォーマンスを左右します。局所性が高いほどファイルごとのmin/max統計の範囲が狭くなり、スキャン時にOPTIMIZEがより多くのファイルをスキップできます。複数の列で同時にフィルタするクエリにおいて、同じ列セットでもliquid clusteringがZORDERを上回るのはこのためです。
増分OPTIMIZE
もしOPTIMIZEの実行のたびにレイアウトをゼロから再構築していたら、この局所性の優位性を維持するコストは高くついたでしょう。それを防いでいるのが書き換え頻度です。標準のOPTIMIZEは、前回の実行以降に書き込みまたは変更されたファイルのみを再クラスタリングします。すでに目標とするヒルベルト座標とサイズに収まっているファイルはスキップされ、これはDatabricksがファイル最適化コマンドについて文書化している冪等性の挙動と一致します。Z-Orderingにはそのような保証がありません。冪等ではないため、パーティションスコープを指定せずに実行すると、以前のZ-Orderingパスがすでに処理したファイルを再処理する可能性があります。
OPTIMIZE FULLは、この増分挙動を意図的に無効にします。変更の有無にかかわらずすべてのファイルを再クラスタリングし、Databricks Runtime(DBR)16.0 LTS以上が必要です。通常はクラスタリングキーの変更後、過去データに新しいレイアウトを時間をかけてではなく即座に適用したい場合に使用します。
liquid clusteringされたテーブルに対するOPTIMIZEのコストが、同じテーブルへのZORDERのごく一部で済むのは、ZORDERが変更内容にかかわらず、実行のたびに対象となるすべてのファイルを書き換えるためです。Databricksのコストが積み上がるその他の領域については、Databricksコスト最適化で解説しています。
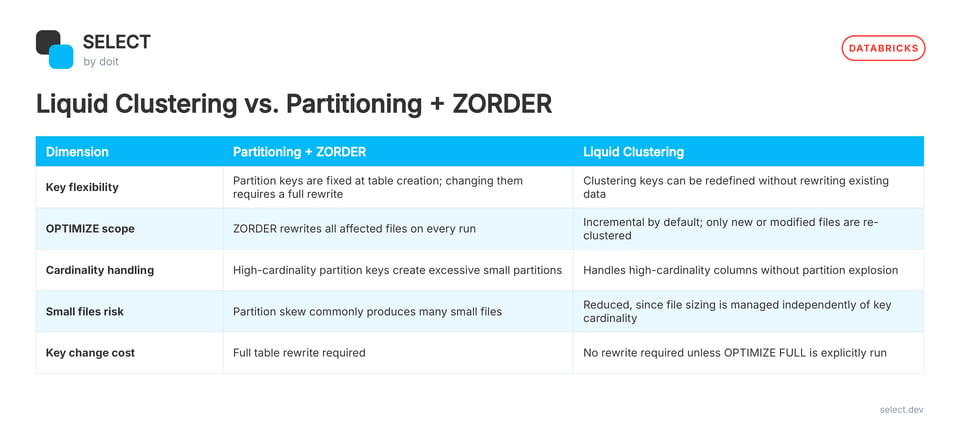
この比較は、liquid clusteringがZORDERよりも効率的にファイルをスキップできる理由を説明しますが、どの列をCLUSTER BY句に含めるべきかについては何も語っていません。価値の多くはその選択で決まります。
クラスタリングキーの正しい選び方
クラスタリングキーは、クエリで最も頻繁にフィルタされる条件に基づいて選びます。WHERE句やジョインに登場する列を優先し、カーディナリティの高い列も対象に含めてください。Liquid clusteringは物理的なフォルダ分割ではなく、保存されたmin/max統計を使ってファイルをスキップするため、数百万の一意な値があっても、従来のパーティショニングで起こるような小さなパーティションの爆発的増加は発生しません。
カーディナリティの低い列は通常、効果が薄くなります。列の一意な値がごくわずかだと、OPTIMIZEがファイルをスキップできる機会は限られます。4列までという上限は引き続き適用されますが、ほとんどの本番テーブルは2〜3列で十分カバーでき、4列目を追加しても効果はわずかな場合がほとんどです。
キーを後から修正する場合の影響は、誤ったパーティション列を修正する場合よりはるかに小さく済みます。ALTER TABLE ... CLUSTER BYはメタデータのみの操作です。新しい書き込みとその後のOPTIMIZE実行は更新後のキーを即座に採用し、既存データはOPTIMIZE FULLで新しいキーに基づいて再クラスタリングするまで現在のレイアウトを維持します。パーティション列の変更で強制される書き換えと異なり、そのコストをいつ負担するかを自分で決められるのです。
クラスタリングキーを手動で管理したくないチームは、Unity CatalogとPredictive Optimizationが有効になっていればCLUSTER BY AUTOを利用できます。Databricksがクエリ履歴を分析し、フィルタの変化に合わせてクラスタリングキーを調整します。適用後はDESCRIBE DETAILを確認してください。clusteringColumnsフィールドにAUTOが選択したキーが表示され、キーが変わるたびに更新されます。
既存テーブルはLiquid Clusteringに移行できる?
liquid clusteringがパーティショニングやZ-orderとどう違うかを理解しても、既存テーブルを移行する現実的な方法がなければ意味がありません。Liquid clusteringはPARTITIONED BYやZORDER BYと共存できません。テーブルが使えるのはどちらか一方のアプローチだけなので、移行は既存の手法の上にクラスタリングを追加するのではなく、両方を置き換える形になります。
移行手順はランタイムのバージョンによって異なります。Databricks Runtime(DBR)18.1以上では、1つのステートメントで変換が完了します:ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (...)。このコマンドは既存のパーティショニングスキームを削除し、クラスタリングキーを1ステップで定義します。それより前のランタイムではサポートされていません。一般的な代替手段は、CTASでCLUSTER BYを指定したパーティションなしの新しいテーブルを作成し、日付範囲ごとのバッチでバックフィルし、新しいテーブルの準備が整った時点でテーブル名を入れ替える方法です。
移行方法よりも重要なのがクラスタリング列の選択です。可能であれば、以前パーティショニングに使っていた列に近いものを選んでください。大きく異なる列セットを指定すると、最初のOPTIMIZE実行が軽量な増分処理ではなく大規模な再クラスタリングになる可能性があるため、Databricksもこのアプローチを推奨しています。
変換後は、ZORDER BY付きのOPTIMIZEの実行を停止してください。以降は標準のOPTIMIZEが引き継ぎます。初回の実行では最後のZ-order操作以降に書き込まれたデータが処理され、それ以降の実行は増分のままです。以下の例では、DBR 18.1以上向けのALTER TABLEアプローチと、それより前のランタイム向けのCTASによる代替手段という、両方の移行パスを示します。
-- DBR 18.1以上
ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (event_ts, user_id);

OPTIMIZE events;
-- ここでは通常のOPTIMIZEで十分です。テーブルはこれまでクラスタリングされていないため、
-- 整合を取るべき既存のクラスタリング状態はありません。
-- 旧ランタイム(DBR 18.1より前):CTASによる代替手段
CREATE OR REPLACE TABLE events_v2
CLUSTER BY (event_ts, user_id)
AS SELECT * FROM events
WHERE event_ts >= '2024-01-01' AND event_ts < '2025-01-01';

INSERT INTO events_v2
SELECT * FROM events
WHERE event_ts >= '2023-01-01' AND event_ts < '2024-01-01';

-- 日付範囲ごとに繰り返し、その後テーブル名を入れ替えます
OPTIMIZE events_v2;
-- 入れ替え前に新しく挿入したデータをクラスタリングします
どちらのアプローチも行き着く先は同じです。繰り返しのテーブル全体書き換えではなく、新しく書き込み・変更されたデータに焦点を当てたOPTIMIZEプロセスです。次の問いは、この変化がコストに何をもたらすか、そしてその削減効果が移行に見合うかどうかです。
OPTIMIZEのコストと、SELECTで見えること
Liquid ClusteringはOPTIMIZEの継続的なコストを削減しますが、実行のたびにDatabricksのコンピュートと、Databricksの課金指標であるDatabricks Unit(DBU)を消費することに変わりはありません。Photonはこのコストにさらに影響し得ます。PhotonのDBUレートは高めですが、liquid clusteringされたテーブルではOPTIMIZEがテーブルの大部分を書き換えるのではなく増分で動作するため、処理するデータ量が少なくなることが多く、結果として割増料金が適用されるワークロードの規模も小さくなります。
Predictive Optimizationを使えば、スケジュール管理の負担がなくなります。Unity Catalogのマネージドテーブルで有効化すると、OPTIMIZEの実行タイミングはDatabricksが判断し、その使用量はアカウントのその他の課金対象アクティビティとともに、system.billing.usageのpredictive_optimization SKUに記録されます。
OPTIMIZEがDBUを消費するという知識は有用です。しかし、特定のジョブが時間とともにどれだけ消費したかを可視化できて初めて、移行が期待どおりの削減をもたらしたかを検証できます。SELECTが2026年6月にリリースしたDatabricks対応は、まさにこのレベルの可視性のために構築されており、クラスターとワークロード別に個々のOPTIMIZEジョブを追跡できる、きめ細かなDBUアトリビューションを提供します。
移行前後のOPTIMIZEコストを比較したいチームは、SELECT for Databricksのデモを予約すれば、約20分で接続できます。
Frequently asked
questions
Liquid Clusteringはストリーミングテーブルやマテリアライズドビューでも使えますか?
はい。Liquid clusteringは、標準のDeltaテーブルに加えて、ストリーミングテーブルやマテリアライズドビューにも適用できます。CLUSTER BYの宣言方法は同じで、OPTIMIZEは3種類のテーブルタイプすべてで一貫してファイルを再編成します。
Liquid clusteringされたテーブルでもOPTIMIZEは使えますか?
はい。OPTIMIZEは、Databricksがliquid clusteringされたテーブルの維持に使用するコマンドで、他の場面でパーティションのコンパクションやZ-orderに使われるものと同じコマンドです。標準のOPTIMIZEは新規または変更されたファイルのみを再クラスタリングし、Databricks Runtime(DBR)16.0 LTS以上で利用できるOPTIMIZE FULLは完全な再クラスタリングを強制します。クラスタリングされたテーブルではZORDER BYはサポートされません。
CLUSTER BY AUTOとは何ですか?どんな場合に使うべきですか?
CLUSTER BY AUTOは、Unity CatalogとPredictive Optimizationが有効になっている場合に、Databricksがクエリ履歴を分析してクラスタリングキーを選択・更新できるようにする機能です。ワークロードが時間とともに変化するテーブルや、キーの選定を手動で管理したくないチームに適しています。
テーブルがどの列でクラスタリングされているかを確認するには?
テーブルに対してDESCRIBE DETAILを実行してください。clusteringColumnsフィールドに現在のクラスタリングキーが表示されます。CLUSTER BY AUTOが有効な場合、Databricksがキーの選択を調整するたびにこのフィールドが更新されます。
Liquid Clusteringに切り替えず、パーティショニングを維持すべきなのはどんな場合ですか?
1TBから100TBのデータセットでは、通常liquid clusteringの方が優れたデフォルトです。それより大きなワークロードでは、パーティショニングを選ぶ前にテストしてください。クエリが常に単一の日付など狭いデータ範囲を対象とする場合は、ディレクトリプルーニングが依然として非常に有効なため、パーティショニングにも引き続き意味があります。
Niall Woodward·SELECT 共同創業者 & CTO
Niallは、Snowflakeのコスト管理・最適化を行うSaaSプラットフォームであるSELECTの共同創業者兼CTOです。SELECTを立ち上げる前は、Brooklyn Data Companyや複数のスタートアップでデータエンジニアとして働いていました。オープンソースの熱心な支持者でもあり、SQLFluffのメンテナーを務めるほか、dbt_artifacts、dbt_snowflake_monitoring、dbt_query_tagsという3つのdbtパッケージの作者でもあります。
15分以内でセットアップ完了
Snowflake、Databricks、またはBigQueryのアカウントを接続すれば、削減余地をすぐに把握できます。