

Activar liquid clustering en Databricks requiere una sola línea de SQL. Declaras CLUSTER BY en una tabla y Databricks se encarga del resto. Justo ahí es donde se quedan la mayoría de las explicaciones de la funcionalidad. Lo que ocurre después es lo que realmente determina si liquid clustering le aporta algo a tu tabla.
Sacarle valor empieza por elegir claves de clustering acordes a cómo se consulta la tabla. También implica entender por qué OPTIMIZE omite archivos que ZORDER todavía reescribiría, decidir si CLUSTER BY AUTO encaja con la tabla y comprobar si el costo de cómputo justifica ir más allá de lo que el particionado ya ofrece.
Liquid clustering se ha convertido en la recomendación de Databricks para tablas nuevas durante 2025 y 2026, y la sintaxis es fácil de encontrar. Elegir la estrategia correcta es más difícil, y esa es la pregunta que responde este artículo.
TL;DR
- Las claves de clustering importan más que la sintaxis de CLUSTER BY. Elige columnas por las que las consultas filtran con frecuencia, ya que las columnas de baja cardinalidad le dan a OPTIMIZE menos oportunidades de omitir archivos.
- ZORDER reescribe todos los archivos afectados en cada ejecución. OPTIMIZE en una tabla con liquid clustering reclusteriza solo los archivos escritos o modificados desde la ejecución anterior.
- CLUSTER BY AUTO selecciona y actualiza las claves de clustering automáticamente, pero requiere Unity Catalog y Predictive Optimization.
- Las ejecuciones más ligeras de OPTIMIZE siguen consumiendo Databricks Units (DBUs), así que compara los costos de mantenimiento con las mejoras de rendimiento de las consultas al evaluar la migración.
¿Cuál es el costo real de un diseño de tabla equivocado?
Liquid clustering de Databricks existe porque un mal diseño de tabla genera costos difíciles de revertir. Dos fallas comunes lo explican: elegir mal la columna de partición y el costo de OPTIMIZE.
La mala elección de la partición suele llegar primero. Eliges una columna al crear la tabla, antes de saber cómo se va a consultar. Databricks descubrió que el particionado al estilo Hive provoca sobreparticionado y problemas de archivos pequeños en más del 75% de los casos. Delta Lake no ofrece ninguna forma de cambiar esa columna después, así que corregirla exige reescribir la tabla completa.
Después viene el costo de OPTIMIZE. Como se explica en cómo reducir los costos de Databricks más allá de lo obvio, muchos equipos ejecutan OPTIMIZE ZORDER BY de forma programada. Cada ejecución reescribe toda la tabla, consume recursos del warehouse y deja atrás versiones antiguas de los archivos, ya que VACUUM no puede eliminarlas hasta que expira la ventana de retención.
Los Engineers en los foros de la comunidad de Databricks describen con frecuencia el mismo problema: una tabla se particiona para un filtro y luego un nuevo dashboard o workload empieza a consultar otra columna, lo que reduce el valor del partition pruning.
Las consultas en lenguaje natural están sumando aún más variación a la forma en que se consultan las tablas. Databricks Genie Explained explica cómo Genie convierte preguntas en lenguaje natural en SQL contra tablas Delta, generando workloads de consulta que tu estrategia de particionado nunca estuvo diseñada para manejar.
Databricks se topó con el mismo problema en una tabla interna de 1.1 PB. Estaba particionada por fecha y hora, pero los Engineers filtraban con frecuencia también por source e ID. Cada solicitud debía escanear todos los archivos de las particiones de fecha y hora correspondientes para devolver unas pocas filas, mientras que agregar source e ID como columnas de partición habría creado miles de millones de archivos pequeños.
En 16 consultas de producción representativas, la tabla tardaba 406 segundos y escaneaba 3.5 TB de datos. Tras adoptar liquid clustering, esas mismas consultas se completaron en 70 segundos y escanearon 0.48 TB: una aceleración de 5.9× con un 86% menos de datos leídos. El tamaño de la tabla también bajó de 1.1 PB a 0.8 PB, una reducción del 27% sin cambiar los datos subyacentes.
¿Qué es Liquid Clustering de Databricks?
Liquid clustering de Databricks reemplaza dos técnicas conocidas: PARTITIONED BY y ZORDER BY. En lugar de fijar el diseño de la tabla al crearla, CLUSTER BY te permite indicar las columnas que importan para tus consultas, y OPTIMIZE reorganiza los datos de forma incremental para colocar juntas las filas relacionadas. Databricks usa una curva de Hilbert, una curva de llenado de espacio, para organizar los datos clusterizados.
Ese mecanismo alcanzó la disponibilidad general (GA) para tablas Delta Lake en Databricks Runtime (DBR) 15.4 LTS y versiones posteriores. El soporte para Apache Iceberg sigue en Public Preview y requiere DBR 16.4 LTS o superior, así que conviene tratar las tablas Iceberg con más cautela antes de llevarlas a producción.
Databricks ahora recomienda el liquid clustering automático para todas las tablas administradas de Unity Catalog, y CLUSTER BY también está disponible para tablas de streaming y vistas materializadas. Esa recomendación es fácil de enunciar, pero lo que más importa es cómo OPTIMIZE mantiene el diseño con el tiempo, porque funciona de manera distinta a una reescritura periódica de toda la tabla.
¿Cómo funciona liquid clustering por dentro?
Liquid clustering separa la organización de los archivos de la frecuencia con que se reescriben, y ambas afectan el rendimiento por razones distintas. La organización explica por qué liquid clustering omite más archivos que ZORDER en la misma consulta. La frecuencia de reescritura explica por qué cuesta menos mantenerlo.
Curva Z vs. curva de Hilbert
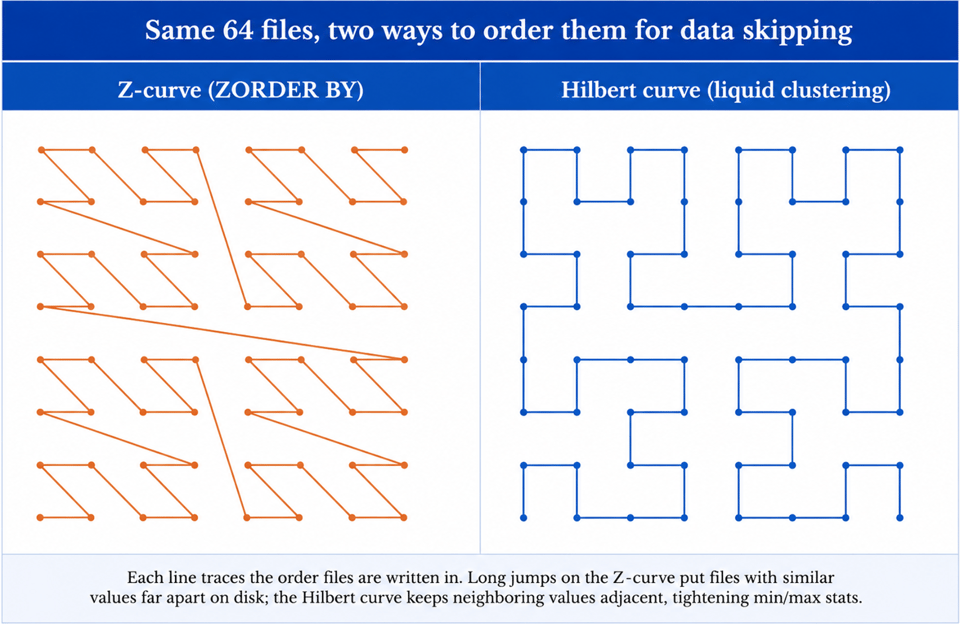
La organización empieza por cómo se ordenan inicialmente los archivos de una tabla. ZORDER BY usa una curva Z, una curva de llenado de espacio que proyecta varios valores de columna en una sola dimensión para que Delta pueda ordenar archivos por más de un predicado a la vez. Liquid clustering usa una curva de Hilbert para la misma tarea, y la diferencia se vuelve más notoria a medida que aumenta la cardinalidad. Una curva de Hilbert preserva mejor la localidad que una curva Z, de modo que las filas con valores similares en tus columnas de clustering quedan más cerca en la curva y, por lo tanto, en los mismos archivos.
Esa ventaja de localidad es la que marca el rendimiento de las consultas. Una localidad más ajustada produce estadísticas min/max por archivo más acotadas, lo que permite a OPTIMIZE omitir más archivos durante un escaneo. Por eso liquid clustering supera a ZORDER con el mismo conjunto de columnas cuando las consultas filtran por más de una columna a la vez.
OPTIMIZE incremental
Esa ventaja de localidad sería costosa de mantener si cada ejecución de OPTIMIZE reconstruyera el diseño desde cero. La frecuencia de reescritura es lo que lo evita. El OPTIMIZE estándar reclusteriza solo los archivos escritos o modificados desde la ejecución anterior. Los archivos que ya están en sus coordenadas de Hilbert y tamaños objetivo se omiten, en línea con el comportamiento idempotente que Databricks documenta para los comandos de optimización de archivos. Z-Ordering no ofrece esa garantía: no es idempotente, por lo que una ejecución sin acotar por partición puede reprocesar archivos que una pasada anterior de Z-Ordering ya había tocado.
OPTIMIZE FULL deja de lado ese comportamiento incremental a propósito. Reclusteriza todos los archivos sin importar si algo cambió, y requiere Databricks Runtime (DBR) 16.0 LTS o superior. Normalmente lo usarías después de cambiar las claves de clustering, cuando los datos históricos necesitan adoptar el nuevo diseño de inmediato en lugar de hacerlo con el tiempo.
OPTIMIZE en una tabla con liquid clustering cuesta una fracción de lo que cuesta ZORDER en la misma tabla, porque ZORDER reescribe todos los archivos afectados en cada ejecución, sin importar qué cambió. En optimización de costos de Databricks se exploran otras áreas donde se acumulan los costos de Databricks.
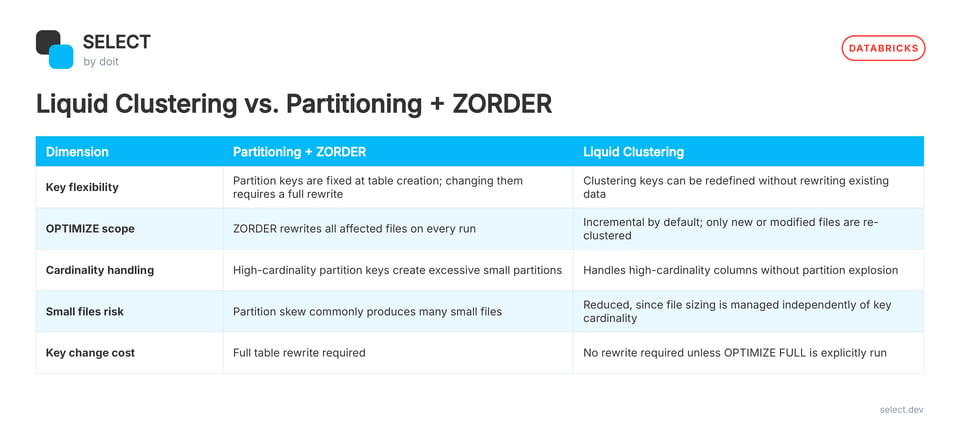
Esa tabla explica por qué liquid clustering omite archivos de forma más eficiente que ZORDER, pero no dice nada sobre qué columnas deberían ir en la cláusula CLUSTER BY. En esa elección es donde se gana o se pierde buena parte del valor.
¿Cómo elegir las claves de clustering correctas?
Elige las claves de clustering según los filtros más frecuentes de tus consultas, priorizando las columnas que aparecen en cláusulas WHERE y en joins, incluidas las de alta cardinalidad. Liquid clustering omite archivos usando estadísticas min/max almacenadas en lugar de separación física en carpetas, así que millones de valores distintos no crean la explosión de particiones pequeñas típica del particionado tradicional.
Las columnas de baja cardinalidad suelen ser menos efectivas. Cuando una columna tiene apenas un puñado de valores distintos, OPTIMIZE tiene pocas oportunidades de omitir archivos. El límite de cuatro columnas sigue vigente, pero dos o tres columnas cubren bien la mayoría de las tablas de producción, mientras que una cuarta suele aportar poco beneficio adicional.
Corregir claves equivocadas más adelante es mucho menos disruptivo que corregir una columna de partición equivocada. ALTER TABLE ... CLUSTER BY es una operación que solo afecta metadatos. Las escrituras nuevas y las ejecuciones posteriores de OPTIMIZE adoptan las claves actualizadas de inmediato, mientras que los datos existentes conservan su diseño actual hasta que ejecutes OPTIMIZE FULL para reclusterizarlos con las nuevas claves. Eso evita la reescritura forzada que exige cambiar una columna de partición: tú decides cuándo asumir ese costo en lugar de dispararlo durante el cambio.
Los equipos que prefieren no administrar las claves de clustering manualmente pueden usar CLUSTER BY AUTO, siempre que Unity Catalog y Predictive Optimization estén habilitados. Databricks analiza el historial de consultas y ajusta las claves de clustering a medida que cambian tus filtros. Revisa DESCRIBE DETAIL después: el campo clusteringColumns muestra las claves que AUTO seleccionó y se actualiza cada vez que vuelve a ajustarlas.
¿Se puede migrar una tabla existente a liquid clustering?
Entender en qué se diferencia liquid clustering del particionado y de Z-order solo resulta útil cuando tienes una forma práctica de migrar las tablas existentes. Liquid clustering no puede coexistir con PARTITIONED BY ni con ZORDER BY. Una tabla usa un enfoque o el otro, así que la migración reemplaza ambos en lugar de agregar clustering encima.
El proceso de migración depende de tu versión de runtime. En Databricks Runtime (DBR) 18.1 y superior, una sola sentencia realiza la conversión: ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (...). Ese comando elimina el esquema de particionado existente y define las claves de clustering en un solo paso. Los runtimes anteriores no lo soportan. El camino alternativo habitual es crear una tabla nueva sin particiones con CLUSTER BY usando CTAS, hacer el backfill por lotes según rangos de fechas y luego intercambiar los nombres de las tablas cuando la nueva esté lista.
Las columnas de clustering importan más que el método de migración. En lo posible, mantenlas cercanas a las columnas que antes se usaban para particionar. Databricks recomienda este enfoque porque un conjunto de columnas muy distinto puede desencadenar una reclusterización mayor durante la primera ejecución de OPTIMIZE en lugar de una pasada incremental más ligera.
Después de la conversión, deja de ejecutar OPTIMIZE con ZORDER BY. A partir de ahí, el OPTIMIZE estándar toma el relevo. La primera ejecución procesa los datos escritos desde la última operación de Z-order, mientras que las siguientes se mantienen incrementales. Los ejemplos a continuación muestran ambos caminos de migración: el enfoque con ALTER TABLE para DBR 18.1 y superior, y la alternativa con CTAS para runtimes anteriores.
-- DBR 18.1 y superior
ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (event_ts, user_id);

OPTIMIZE events;
-- El OPTIMIZE simple es suficiente aquí. La tabla no estaba clusterizada antes,
-- así que no hay un estado de clustering previo que reconciliar.
-- Runtimes anteriores (antes de DBR 18.1): alternativa con CTAS
CREATE OR REPLACE TABLE events_v2
CLUSTER BY (event_ts, user_id)
AS SELECT * FROM events
WHERE event_ts >= '2024-01-01' AND event_ts < '2025-01-01';

INSERT INTO events_v2
SELECT * FROM events
WHERE event_ts >= '2023-01-01' AND event_ts < '2024-01-01';

-- Repite para cada rango de fechas y luego intercambia los nombres de las tablas
OPTIMIZE events_v2;
-- Clusteriza los datos recién insertados antes del intercambio
Ambos enfoques llegan al mismo resultado: un proceso de OPTIMIZE enfocado en los datos recién escritos o modificados en lugar de reescrituras completas y repetidas de la tabla. La siguiente pregunta es qué significa ese cambio en términos de costo, y si el ahorro justifica la migración.
¿Cuánto cuesta OPTIMIZE y qué te muestra SELECT?
Liquid Clustering reduce el costo recurrente de OPTIMIZE, pero cada ejecución sigue consumiendo cómputo de Databricks y Databricks Units (DBUs), la métrica con la que factura Databricks. Photon puede influir aún más en ese costo. Aunque Photon tiene un costo por DBU más alto, suele procesar menos datos en una tabla con liquid clustering porque OPTIMIZE trabaja de forma incremental en lugar de reescribir grandes porciones de la tabla. Como resultado, el sobreprecio se aplica a un workload más pequeño.
Predictive Optimization elimina la carga de programar las ejecuciones. Cuando está habilitado en una tabla administrada de Unity Catalog, Databricks decide cuándo se ejecuta OPTIMIZE y registra el uso bajo el SKU predictive_optimization en system.billing.usage, junto con el resto de la actividad facturable de tu cuenta.
Saber que OPTIMIZE consume DBUs es útil. Ver cuántas consumió un job específico a lo largo del tiempo es lo que valida si una migración entregó el ahorro que esperabas. El lanzamiento de SELECT para Databricks de junio de 2026 se construyó para ese nivel de visibilidad, con una atribución de DBUs lo bastante granular como para rastrear jobs individuales de OPTIMIZE por clúster y workload.
Los equipos que quieran comparar los costos de OPTIMIZE antes y después de una migración pueden agendar una demo de SELECT para Databricks y conectarse en unos 20 minutos.
Frequently asked
questions
¿Liquid Clustering funciona en tablas de streaming y vistas materializadas?
Sí. Liquid clustering aplica tanto a tablas de streaming y vistas materializadas como a tablas Delta estándar. Declaras CLUSTER BY de la misma manera, y OPTIMIZE reorganiza los archivos de forma consistente en los tres tipos de tabla.
¿Puedo seguir usando OPTIMIZE en una tabla con Liquid Clustering?
Sí. OPTIMIZE es el comando que Databricks usa para mantener las tablas con liquid clustering, el mismo que usa para la compactación de particiones y Z-order en otros contextos. El OPTIMIZE estándar reclusteriza solo los archivos nuevos o modificados, mientras que OPTIMIZE FULL, disponible en Databricks Runtime (DBR) 16.0 LTS y superior, fuerza una reclusterización completa. ZORDER BY no está soportado en una tabla clusterizada.
¿Qué es CLUSTER BY AUTO y cuándo conviene usarlo?
CLUSTER BY AUTO permite que Databricks seleccione y actualice las claves de clustering analizando el historial de consultas, siempre que Unity Catalog y Predictive Optimization estén habilitados. Funciona bien para tablas cuyos workloads cambian con el tiempo o para equipos que prefieren no administrar la selección de claves manualmente.
¿Cómo verifico por qué columnas está clusterizada una tabla?
Ejecuta DESCRIBE DETAIL sobre la tabla. El campo clusteringColumns muestra las claves de clustering actuales. Cuando CLUSTER BY AUTO está habilitado, el campo se actualiza a medida que Databricks ajusta la selección de claves con el tiempo.
¿Cuándo conviene mantener el particionado en lugar de cambiar a Liquid Clustering?
Liquid clustering suele ser la mejor opción por defecto para datasets de entre 1 TB y 100 TB. Para workloads más grandes, pruébalo antes de decidirte por el particionado. El particionado sigue teniendo sentido cuando las consultas apuntan de forma consistente a una porción estrecha de los datos, como un solo día, ya que el directory pruning sigue siendo muy efectivo en esa situación.
Niall Woodward·Co-founder & CTO de SELECT
Niall es Co-Founder & CTO de SELECT, una plataforma SaaS de gestión y optimización de costos de Snowflake. Antes de fundar SELECT, Niall fue data engineer en Brooklyn Data Company y en varias startups. Como entusiasta del open source, también es mantenedor de SQLFluff y creador de tres paquetes de dbt: dbt_artifacts, dbt_snowflake_monitoring y dbt_query_tags.
Ponte en marcha en menos de 15 minutos
Conecta tu cuenta de Snowflake, Databricks o BigQuery y descubre al instante tu potencial de ahorro.