

Abilitare il liquid clustering di Databricks richiede una sola riga di SQL. Basta dichiarare CLUSTER BY su una tabella e Databricks si occupa del resto. Ma quella singola riga è anche il punto in cui la maggior parte delle spiegazioni si ferma. È ciò che accade dopo a determinare se il liquid clustering porterà davvero benefici alla tabella.
Per trarne valore bisogna innanzitutto scegliere clustering key coerenti con il modo in cui la tabella viene interrogata. Significa anche capire perché OPTIMIZE salta file che ZORDER riscriverebbe comunque, valutare se CLUSTER BY AUTO è adatto alla tabella e verificare se il costo di compute giustifica l'andare oltre ciò che il partizionamento già offre.
Il liquid clustering è diventato la scelta raccomandata da Databricks per le nuove tabelle nel 2025 e nel 2026, e la sintassi è facile da trovare. Scegliere la strategia giusta è più difficile, ed è proprio la domanda a cui risponde questo articolo.
In sintesi
- Le clustering key contano più della sintassi CLUSTER BY. Conviene scegliere colonne su cui le query filtrano di frequente, poiché le colonne a bassa cardinalità offrono a OPTIMIZE meno opportunità di saltare file.
- ZORDER riscrive tutti i file interessati a ogni esecuzione. OPTIMIZE su una tabella con liquid clustering riclusterizza solo i file scritti o modificati dopo l'esecuzione precedente.
- CLUSTER BY AUTO seleziona e aggiorna automaticamente le clustering key, ma richiede Unity Catalog e Predictive Optimization.
- Anche le esecuzioni più leggere di OPTIMIZE consumano Databricks Unit (DBU), quindi nel valutare la migrazione va confrontato il costo di manutenzione con i miglioramenti delle prestazioni delle query.
Qual è il costo reale di un layout di tabella sbagliato?
Il liquid clustering di Databricks esiste perché un layout di tabella mal progettato genera costi difficili da annullare. Due sono le cause più comuni: la scelta sbagliata delle partizioni e il costo di OPTIMIZE.
La scelta sbagliata delle partizioni di solito arriva per prima. Si sceglie una colonna al momento della creazione, prima di sapere come verrà interrogata la tabella. Databricks ha rilevato che il partizionamento in stile Hive porta a over-partitioning e a problemi di file di piccole dimensioni in oltre il 75% dei casi. Delta Lake non offre alcun modo per cambiare quella colonna in seguito, quindi correggere l'errore richiede una riscrittura completa.
Poi arriva il costo di OPTIMIZE. Come illustrato in come ridurre i costi di Databricks oltre i risparmi facili, i team spesso eseguono OPTIMIZE ZORDER BY a intervalli pianificati. Ogni esecuzione riscrive l'intera tabella, consumando risorse del warehouse e lasciando indietro versioni precedenti dei file, poiché VACUUM non può rimuoverle finché non scade la finestra di retention.
Gli ingegneri nei forum della community Databricks descrivono spesso lo stesso problema. Una tabella viene partizionata per un certo filtro, poi una nuova dashboard o un nuovo workload inizia a interrogare un'altra colonna, riducendo il valore del partition pruning.
Le query in linguaggio naturale stanno aggiungendo ancora più variabilità al modo in cui le tabelle vengono interrogate. Databricks Genie Explained spiega come Genie trasforma domande in linguaggio naturale in SQL sulle tabelle Delta, generando workloads di query che la strategia di partizionamento non era mai stata pensata per gestire.
Databricks ha incontrato lo stesso problema su una tabella interna da 1,1 PB. Era partizionata per data e ora, ma gli ingegneri filtravano spesso anche per source e ID. Ogni richiesta doveva scansionare tutti i file nelle partizioni data-ora corrispondenti per restituire un numero ridotto di righe, mentre aggiungere source e ID come colonne di partizione avrebbe creato miliardi di file di piccole dimensioni.
Su 16 query di produzione rappresentative, la tabella richiedeva 406 secondi e scansionava 3,5 TB di dati. Dopo l'adozione del liquid clustering, le stesse query si completavano in 70 secondi scansionando 0,48 TB: un'accelerazione di 5,9× con l'86% di dati letti in meno. Anche la dimensione della tabella è scesa da 1,1 PB a 0,8 PB, una riduzione del 27% senza alcuna modifica ai dati sottostanti.
Cos'è il Liquid Clustering di Databricks?
Il liquid clustering di Databricks sostituisce due tecniche ben note, PARTITIONED BY e ZORDER BY. Invece di fissare il layout della tabella al momento della creazione, CLUSTER BY permette di indicare le colonne rilevanti per le query, e OPTIMIZE riorganizza i dati in modo incrementale per collocare vicine le righe correlate. Per organizzare i dati clusterizzati Databricks utilizza una curva di Hilbert, una curva di riempimento dello spazio.
Questo meccanismo ha raggiunto la General Availability (GA) per le tabelle Delta Lake su Databricks Runtime (DBR) 15.4 LTS e versioni successive. Il supporto per Apache Iceberg è ancora in Public Preview e richiede DBR 16.4 LTS o superiore, quindi è consigliabile maggiore cautela con le tabelle Iceberg prima di un rollout in produzione.
Databricks ora raccomanda il liquid clustering automatico per tutte le tabelle gestite da Unity Catalog, mentre CLUSTER BY è disponibile anche per le streaming table e le materialized view. Questa indicazione è facile da enunciare, ma ciò che conta di più è come OPTIMIZE mantiene il layout nel tempo, dato che funziona in modo diverso da una riscrittura periodica dell'intera tabella.
Come funziona il liquid clustering di Databricks dietro le quinte?
Il liquid clustering separa l'organizzazione dei file dalla frequenza con cui questi vengono riscritti, ed entrambi gli aspetti incidono sulle prestazioni per motivi diversi. L'organizzazione spiega perché il liquid clustering salta più file di ZORDER sulla stessa query. La frequenza di riscrittura spiega perché è meno costoso da mantenere.
Curva Z vs. curva di Hilbert
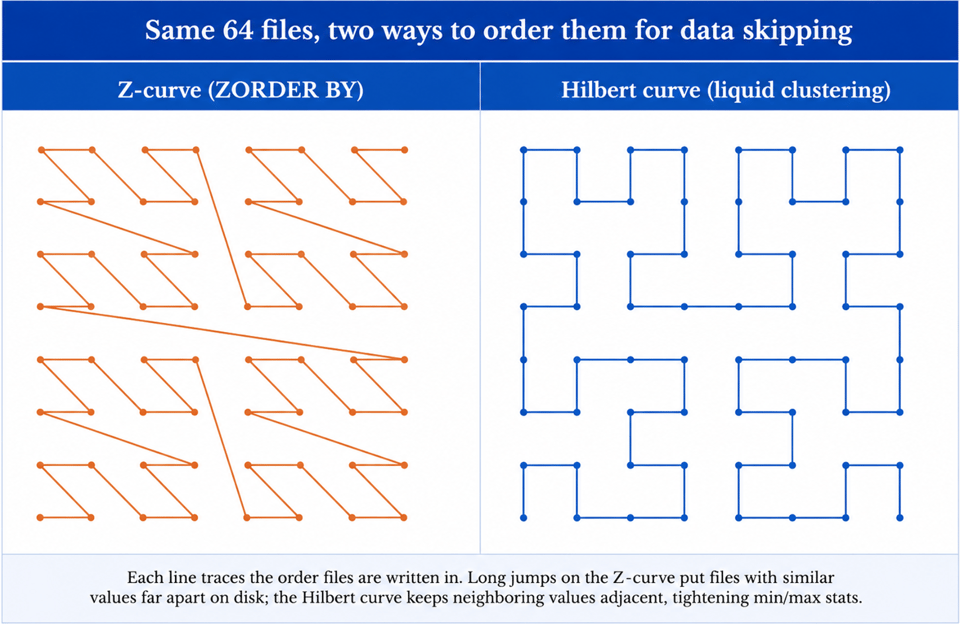
L'organizzazione parte da come vengono ordinati i file di una tabella. ZORDER BY utilizza una curva Z, una curva di riempimento dello spazio che mappa i valori di più colonne in un'unica dimensione, permettendo a Delta di ordinare i file in base a più di un predicato alla volta. Il liquid clustering usa una curva di Hilbert per lo stesso scopo, e la differenza diventa più evidente al crescere della cardinalità. Una curva di Hilbert preserva la località meglio di una curva Z, quindi le righe con valori simili nelle colonne di clustering finiscono più vicine sulla curva, e di conseguenza negli stessi file.
È questo vantaggio di località a determinare le prestazioni delle query. Una località più compatta produce statistiche min/max per file più precise, che consentono a OPTIMIZE di saltare più file durante una scansione. Ecco perché il liquid clustering supera ZORDER sullo stesso set di colonne quando le query filtrano su più colonne contemporaneamente.
OPTIMIZE incrementale
Questo vantaggio di località sarebbe costoso da mantenere se ogni esecuzione di OPTIMIZE ricostruisse il layout da zero. È la frequenza di riscrittura a evitarlo. OPTIMIZE standard riclusterizza solo i file scritti o modificati dopo l'esecuzione precedente. I file già posizionati alle coordinate di Hilbert e alle dimensioni target vengono saltati, in linea con il comportamento idempotente documentato da Databricks per i comandi di ottimizzazione dei file. Lo Z-Ordering non offre alcuna garanzia simile. Non è idempotente, quindi un'esecuzione senza scoping per partizione può rielaborare file già toccati da un precedente passaggio di Z-Ordering.
OPTIMIZE FULL rinuncia deliberatamente a questo comportamento incrementale. Riclusterizza tutti i file indipendentemente da eventuali modifiche e richiede Databricks Runtime (DBR) 16.0 LTS o superiore. Si usa tipicamente dopo aver cambiato le clustering key, quando i dati storici devono adottare subito il nuovo layout anziché gradualmente.
OPTIMIZE su una tabella con liquid clustering costa una frazione di ZORDER sulla stessa tabella, perché ZORDER riscrive tutti i file interessati a ogni esecuzione, indipendentemente da ciò che è cambiato. Databricks cost optimization approfondisce altri ambiti in cui i costi di Databricks si accumulano.
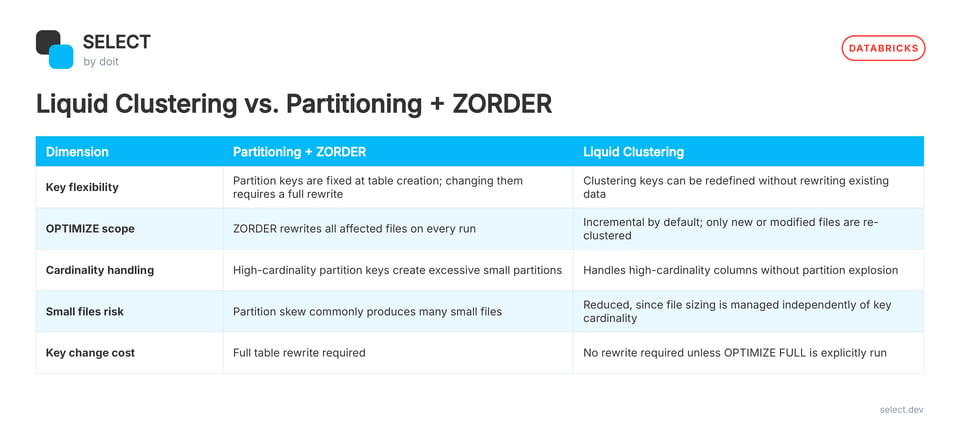
Questa tabella spiega perché il liquid clustering salta i file in modo più efficiente di ZORDER, ma non dice nulla su quali colonne includere nella clausola CLUSTER BY. È proprio in quella scelta che si vince o si perde gran parte del valore.
Come scegliere le clustering key giuste?
Le clustering key vanno scelte in base a ciò su cui le query filtrano più spesso, dando priorità alle colonne presenti nelle clausole WHERE e nei join, incluse quelle ad alta cardinalità. Il liquid clustering salta i file usando le statistiche min/max memorizzate anziché la separazione fisica in cartelle, quindi milioni di valori distinti non creano l'esplosione di piccole partizioni tipica del partizionamento tradizionale.
Le colonne a bassa cardinalità sono di solito meno efficaci. Quando una colonna ha solo una manciata di valori distinti, OPTIMIZE ha poche opportunità di saltare file. Il limite di quattro colonne resta valido, ma due o tre colonne coprono bene la maggior parte delle tabelle di produzione, mentre una quarta spesso offre pochi benefici aggiuntivi.
Correggere le key sbagliate in seguito è molto meno invasivo che correggere una colonna di partizione sbagliata. ALTER TABLE ... CLUSTER BY è un'operazione sui soli metadati. Le nuove scritture e le successive esecuzioni di OPTIMIZE adottano immediatamente le nuove key, mentre i dati esistenti mantengono il layout attuale finché non si esegue OPTIMIZE FULL per riclusterizzarli con le nuove key. Questo evita comunque la riscrittura forzata richiesta dal cambio di una colonna di partizione, perché si decide quando sostenere quel costo anziché innescarlo al momento della modifica.
I team che preferiscono non gestire manualmente le clustering key possono usare CLUSTER BY AUTO, a condizione che Unity Catalog e Predictive Optimization siano abilitati. Databricks analizza la cronologia delle query e adegua le clustering key man mano che i filtri cambiano. Conviene poi verificare con DESCRIBE DETAIL: il campo clusteringColumns mostra le key selezionate da AUTO e si aggiorna a ogni nuova selezione.
È possibile migrare una tabella esistente al liquid clustering?
Capire in cosa il liquid clustering differisce dal partizionamento e dallo Z-order diventa utile solo quando esiste un modo pratico per migrare le tabelle esistenti. Il liquid clustering non può coesistere con PARTITIONED BY o ZORDER BY. Una tabella usa un approccio o l'altro, quindi la migrazione sostituisce entrambi anziché sovrapporre il clustering al layout esistente.
Il processo di migrazione dipende dalla versione del runtime. Su Databricks Runtime (DBR) 18.1 e versioni successive, un'unica istruzione gestisce la conversione: ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (...). Questo comando rimuove lo schema di partizionamento esistente e definisce le clustering key in un solo passaggio. I runtime precedenti non lo supportano. L'alternativa abituale consiste nel creare una nuova tabella non partizionata con CLUSTER BY tramite CTAS, popolarla con un backfill a batch per intervalli di date e poi scambiare i nomi delle tabelle quando la nuova è pronta.
Le colonne di clustering contano più del metodo di migrazione. Dove possibile, conviene mantenerle vicine alle colonne usate in precedenza per il partizionamento. Databricks raccomanda questo approccio perché un set di colonne molto diverso può innescare un re-clustering più oneroso durante la prima esecuzione di OPTIMIZE anziché uno incrementale più leggero.
Dopo la conversione, va interrotta l'esecuzione di OPTIMIZE con ZORDER BY. Da quel momento in poi subentra OPTIMIZE standard. La prima esecuzione elabora i dati scritti dall'ultima operazione di Z-order, mentre le successive restano incrementali. Gli esempi qui sotto mostrano entrambi i percorsi di migrazione: l'approccio ALTER TABLE per DBR 18.1 e versioni successive e l'alternativa CTAS per i runtime precedenti.
-- DBR 18.1 and above
ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (event_ts, user_id);

OPTIMIZE events;
-- Plain OPTIMIZE is sufficient here. The table was not previously clustered,
-- so there is no existing clustering state to reconcile.
-- Older runtimes (before DBR 18.1): CTAS fallback
CREATE OR REPLACE TABLE events_v2
CLUSTER BY (event_ts, user_id)
AS SELECT * FROM events
WHERE event_ts >= '2024-01-01' AND event_ts < '2025-01-01';

INSERT INTO events_v2
SELECT * FROM events
WHERE event_ts >= '2023-01-01' AND event_ts < '2024-01-01';

-- Repeat for each date range, then swap table names
OPTIMIZE events_v2;
-- Cluster the newly inserted data before the swap
Entrambi gli approcci portano allo stesso risultato: un processo OPTIMIZE concentrato sui dati appena scritti o modificati anziché su ripetute riscritture dell'intera tabella. La domanda successiva è cosa significa questo cambiamento in termini di costo, e se il risparmio giustifica la migrazione.
Quanto costa OPTIMIZE e cosa mostra SELECT?
Il Liquid Clustering riduce il costo ricorrente di OPTIMIZE, ma ogni esecuzione consuma comunque compute di Databricks e Databricks Unit (DBU), la metrica su cui Databricks fattura. Photon può incidere ulteriormente su quel costo. Sebbene Photon abbia una tariffa DBU più elevata, su una tabella con liquid clustering spesso elabora meno dati, perché OPTIMIZE lavora in modo incrementale invece di riscrivere ampie porzioni della tabella. Di conseguenza, il sovrapprezzo si applica a un workload più piccolo.
Predictive Optimization elimina l'onere della pianificazione. Quando è abilitata su una tabella gestita da Unity Catalog, Databricks decide quando eseguire OPTIMIZE e registra l'utilizzo sotto la SKU predictive_optimization in system.billing.usage, insieme alle altre attività fatturabili dell'account.
Sapere che OPTIMIZE consuma DBU è utile. Vedere quante ne ha consumate un job specifico nel tempo è ciò che permette di verificare se una migrazione ha prodotto i risparmi attesi. Il lancio di SELECT per Databricks di giugno 2026 è stato progettato proprio per questo livello di visibilità, con un'attribuzione delle DBU abbastanza granulare da tracciare i singoli job OPTIMIZE per cluster e workload.
I team che vogliono confrontare i costi di OPTIMIZE prima e dopo una migrazione possono prenotare una demo di SELECT per Databricks e connettersi in circa 20 minuti.
Frequently asked
questions
Il Liquid Clustering funziona su streaming table e materialized view?
Sì. Il liquid clustering si applica alle streaming table e alle materialized view oltre che alle tabelle Delta standard. CLUSTER BY si dichiara allo stesso modo, e OPTIMIZE riorganizza i file in modo coerente su tutti e tre i tipi di tabella.
Posso ancora usare OPTIMIZE su una tabella con Liquid Clustering?
Sì. OPTIMIZE è il comando che Databricks utilizza per mantenere le tabelle con liquid clustering, lo stesso comando usato altrove per la compattazione delle partizioni e lo Z-order. OPTIMIZE standard riclusterizza solo i file nuovi o modificati, mentre OPTIMIZE FULL, disponibile su Databricks Runtime (DBR) 16.0 LTS e versioni successive, forza un re-clustering completo. ZORDER BY non è supportato su una tabella clusterizzata.
Cos'è CLUSTER BY AUTO e quando conviene usarlo?
CLUSTER BY AUTO consente a Databricks di selezionare e aggiornare le clustering key analizzando la cronologia delle query, a condizione che Unity Catalog e Predictive Optimization siano abilitati. Funziona bene per tabelle i cui workloads cambiano nel tempo o per i team che preferiscono non gestire manualmente la selezione delle key.
Come verifico su quali colonne è clusterizzata una tabella?
Eseguendo DESCRIBE DETAIL sulla tabella. Il campo clusteringColumns mostra le clustering key correnti. Quando CLUSTER BY AUTO è abilitato, il campo si aggiorna man mano che Databricks adegua la selezione delle key nel tempo.
Quando conviene mantenere il partizionamento invece di passare al Liquid Clustering?
Il liquid clustering è di solito la scelta predefinita migliore per dataset tra 1 TB e 100 TB. Per workloads più grandi, è consigliabile testarlo prima di decidere per il partizionamento. Il partizionamento ha ancora senso quando le query puntano costantemente a una porzione ristretta di dati, come un singolo giorno, poiché in quella situazione il directory pruning resta molto efficace.
Niall Woodward·Co-founder & CTO di SELECT
Niall è Co-Founder & CTO di SELECT, una piattaforma SaaS per la gestione e l'ottimizzazione dei costi di Snowflake. Prima di fondare SELECT, Niall è stato data engineer presso Brooklyn Data Company e diverse startup. Da appassionato di open source, è anche maintainer di SQLFluff e creatore di tre pacchetti dbt: dbt_artifacts, dbt_snowflake_monitoring e dbt_query_tags.
Operativi in meno di 15 minuti
Connetta il suo account Snowflake, Databricks o BigQuery e scopra subito il suo potenziale di risparmio.