

Databricks Liquid Clustering zu aktivieren erfordert genau eine Zeile SQL. Sie deklarieren CLUSTER BY auf einer Tabelle, und Databricks übernimmt den Rest. An genau dieser einen Zeile enden allerdings auch die meisten Erklärungen des Features. Was danach passiert, entscheidet jedoch darüber, ob Liquid Clustering Ihrer Tabelle tatsächlich hilft.
Echten Nutzen holen Sie heraus, wenn Sie Clustering-Keys wählen, die zum tatsächlichen Abfrageverhalten der Tabelle passen. Dazu gehört auch zu verstehen, warum OPTIMIZE Dateien überspringt, die ZORDER noch neu schreiben würde, zu entscheiden, ob CLUSTER BY AUTO zur Tabelle passt, und zu prüfen, ob die Compute-Kosten den Schritt über das hinaus rechtfertigen, was Partitionierung bereits leistet.
Liquid Clustering ist 2025 und 2026 die Empfehlung von Databricks für neue Tabellen, und die Syntax ist schnell gefunden. Die richtige Strategie zu wählen ist schwieriger – und genau diese Frage beantwortet dieser Beitrag.
TL;DR
- Clustering-Keys sind wichtiger als die CLUSTER-BY-Syntax. Wählen Sie Spalten, nach denen Abfragen häufig filtern – Spalten mit niedriger Kardinalität geben OPTIMIZE weniger Gelegenheiten, Dateien zu überspringen.
- ZORDER schreibt bei jedem Lauf alle betroffenen Dateien neu. OPTIMIZE auf einer Tabelle mit Liquid Clustering re-clustert nur Dateien, die seit dem letzten Lauf geschrieben oder geändert wurden.
- CLUSTER BY AUTO wählt und aktualisiert Clustering-Keys automatisch, setzt aber Unity Catalog und Predictive Optimization voraus.
- Auch schlankere OPTIMIZE-Läufe verbrauchen Databricks Units (DBUs). Stellen Sie bei der Bewertung der Migration die Wartungskosten den Verbesserungen bei der Abfrage-Performance gegenüber.
Was kostet ein falsches Tabellen-Layout wirklich?
Databricks Liquid Clustering existiert, weil ein schlechtes Tabellen-Layout Kosten verursacht, die sich nur schwer rückgängig machen lassen. Zwei typische Fehlermuster sind dafür verantwortlich: ein Fehlgriff bei der Partitionierung und die Kosten von OPTIMIZE.
Der Fehlgriff bei der Partitionierung kommt meist zuerst. Sie wählen eine Spalte bei der Erstellung der Tabelle – bevor Sie wissen, wie die Tabelle später abgefragt wird. Databricks hat festgestellt, dass Hive-artige Partitionierung in mehr als 75 % der Fälle zu Überpartitionierung und Small-File-Problemen führt. Delta Lake bietet keine Möglichkeit, diese Spalte später zu ändern – eine Korrektur erfordert ein vollständiges Neuschreiben der Tabelle.
Die OPTIMIZE-Kosten folgen. Wie in Databricks-Kosten jenseits der Quick Wins senken beschrieben, führen Teams OPTIMIZE ZORDER BY oft nach Zeitplan aus. Jeder Lauf schreibt die gesamte Tabelle neu, verbraucht Warehouse-Ressourcen und hinterlässt ältere Dateiversionen, da VACUUM sie erst nach Ablauf des Aufbewahrungsfensters entfernen kann.
Engineers in den Databricks-Community-Foren beschreiben immer wieder dasselbe Problem: Eine Tabelle wird für einen bestimmten Filter partitioniert, dann beginnt ein neues Dashboard oder ein neuer Workload, nach einer anderen Spalte zu filtern – und der Nutzen des Partition Prunings sinkt.
Abfragen in natürlicher Sprache bringen zusätzlich noch mehr Varianz in die Art, wie Tabellen abgefragt werden. Databricks Genie Explained zeigt, wie Genie Fragen in Alltagssprache in SQL gegen Delta-Tabellen übersetzt – und damit Query-Workloads erzeugt, für die Ihre Partitionierungsstrategie nie ausgelegt war.
Databricks selbst stand bei einer internen Tabelle mit 1,1 PB vor demselben Problem. Sie war nach Datum und Stunde partitioniert, doch die Engineers filterten häufig zusätzlich nach Quelle und ID. Jede Anfrage musste sämtliche Dateien in den passenden Datum-Stunde-Partitionen scannen, um wenige Zeilen zurückzugeben – während Quelle und ID als zusätzliche Partitionsspalten Milliarden kleiner Dateien erzeugt hätten.
Über 16 repräsentative Produktionsabfragen hinweg benötigte die Tabelle 406 Sekunden und scannte 3,5 TB Daten. Nach der Umstellung auf Liquid Clustering liefen dieselben Abfragen in 70 Sekunden und scannten 0,48 TB – eine 5,9-fache Beschleunigung bei 86 % weniger gelesenen Daten. Auch die Tabellengröße sank von 1,1 PB auf 0,8 PB, eine Reduktion um 27 % ohne Änderung der zugrunde liegenden Daten.
Was ist Databricks Liquid Clustering?
Databricks Liquid Clustering ersetzt zwei bekannte Techniken: PARTITIONED BY und ZORDER BY. Statt das Tabellen-Layout bei der Erstellung festzuschreiben, benennen Sie mit CLUSTER BY die Spalten, die für Ihre Abfragen relevant sind, und OPTIMIZE reorganisiert die Daten inkrementell, sodass zusammengehörige Zeilen nebeneinander liegen. Zur Organisation der geclusterten Daten verwendet Databricks eine raumfüllende Hilbert-Kurve.
Dieser Mechanismus ist für Delta-Lake-Tabellen ab Databricks Runtime (DBR) 15.4 LTS allgemein verfügbar (GA). Die Unterstützung für Apache Iceberg befindet sich weiterhin in der Public Preview und erfordert DBR 16.4 LTS oder höher – behandeln Sie Iceberg-Tabellen vor einem Produktiv-Rollout daher mit entsprechender Vorsicht.
Databricks empfiehlt inzwischen automatisches Liquid Clustering für alle von Unity Catalog verwalteten Tabellen; CLUSTER BY steht zudem für Streaming-Tabellen und materialisierte Views zur Verfügung. Diese Empfehlung ist schnell ausgesprochen – wichtiger ist jedoch, wie OPTIMIZE das Layout über die Zeit pflegt, denn das funktioniert anders als ein regelmäßiges vollständiges Neuschreiben der Tabelle.
Wie funktioniert Databricks Liquid Clustering unter der Haube?
Liquid Clustering trennt die Organisation der Dateien davon, wie oft Dateien neu geschrieben werden – und beides beeinflusst die Performance aus unterschiedlichen Gründen. Die Organisation erklärt, warum Liquid Clustering bei derselben Abfrage mehr Dateien überspringt als ZORDER. Die Häufigkeit des Neuschreibens erklärt, warum die Wartung weniger kostet.
Z-Kurve vs. Hilbert-Kurve
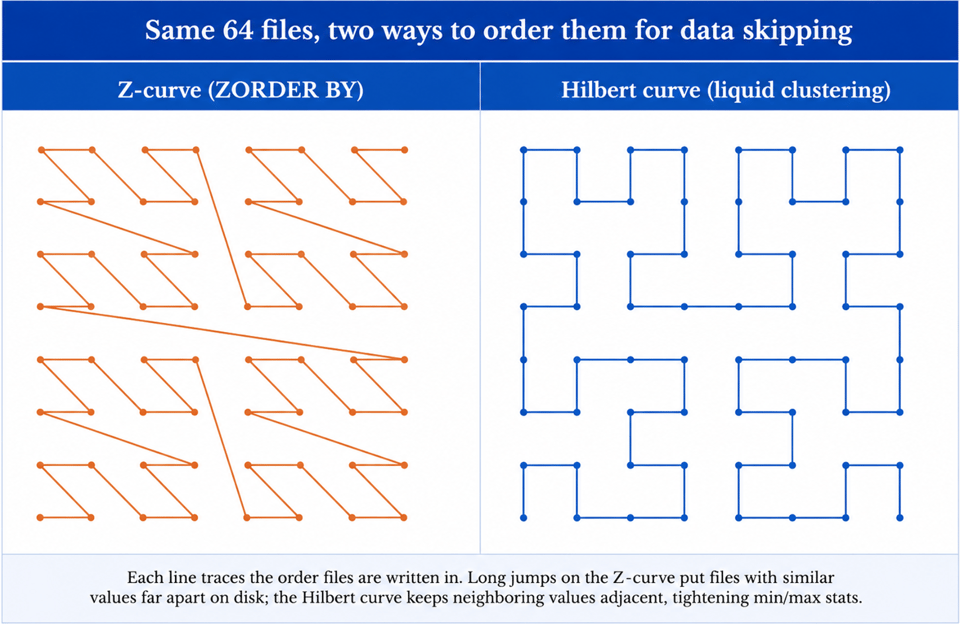
Die Organisation beginnt damit, wie die Dateien einer Tabelle überhaupt sortiert werden. ZORDER BY verwendet eine Z-Kurve – eine raumfüllende Kurve, die mehrere Spaltenwerte auf eine Dimension abbildet, damit Delta Dateien nach mehr als einem Prädikat gleichzeitig sortieren kann. Liquid Clustering nutzt für dieselbe Aufgabe eine Hilbert-Kurve, und der Unterschied wird mit steigender Kardinalität immer deutlicher. Eine Hilbert-Kurve erhält die Lokalität besser als eine Z-Kurve: Zeilen mit ähnlichen Werten in Ihren Clustering-Spalten landen näher beieinander auf der Kurve – und damit in denselben Dateien.
Dieser Lokalitätsvorteil ist der entscheidende Faktor für die Abfrage-Performance. Engere Lokalität erzeugt präzisere Min/Max-Statistiken pro Datei, wodurch OPTIMIZE beim Scan mehr Dateien überspringen kann. Genau deshalb schlägt Liquid Clustering ZORDER bei identischem Spaltensatz, wenn Abfragen nach mehr als einer Spalte gleichzeitig filtern.
Inkrementelles OPTIMIZE
Dieser Lokalitätsvorteil wäre teuer zu erhalten, wenn jeder OPTIMIZE-Lauf das Layout von Grund auf neu aufbauen würde. Genau das verhindert die inkrementelle Arbeitsweise. Ein Standard-OPTIMIZE re-clustert nur Dateien, die seit dem letzten Lauf geschrieben oder geändert wurden. Dateien, die bereits an ihren Ziel-Hilbert-Koordinaten liegen und die Zielgröße haben, werden übersprungen – konsistent mit dem idempotenten Verhalten, das Databricks für Dateioptimierungsbefehle dokumentiert. Z-Ordering bietet keine solche Garantie. Es ist nicht idempotent, ein Lauf ohne Partitionseingrenzung kann also Dateien erneut verarbeiten, die ein früherer Z-Ordering-Durchlauf bereits angefasst hat.
OPTIMIZE FULL setzt dieses inkrementelle Verhalten bewusst außer Kraft. Es re-clustert jede Datei, unabhängig davon, ob sich etwas geändert hat, und erfordert Databricks Runtime (DBR) 16.0 LTS oder höher. Typischerweise setzen Sie es nach einer Änderung der Clustering-Keys ein, wenn historische Daten das neue Layout sofort übernehmen sollen statt nach und nach.
OPTIMIZE auf einer Tabelle mit Liquid Clustering kostet nur einen Bruchteil von ZORDER auf derselben Tabelle, weil ZORDER bei jedem Lauf alle betroffenen Dateien neu schreibt – unabhängig davon, was sich geändert hat. Databricks-Kostenoptimierung beleuchtet weitere Bereiche, in denen sich Databricks-Kosten summieren.
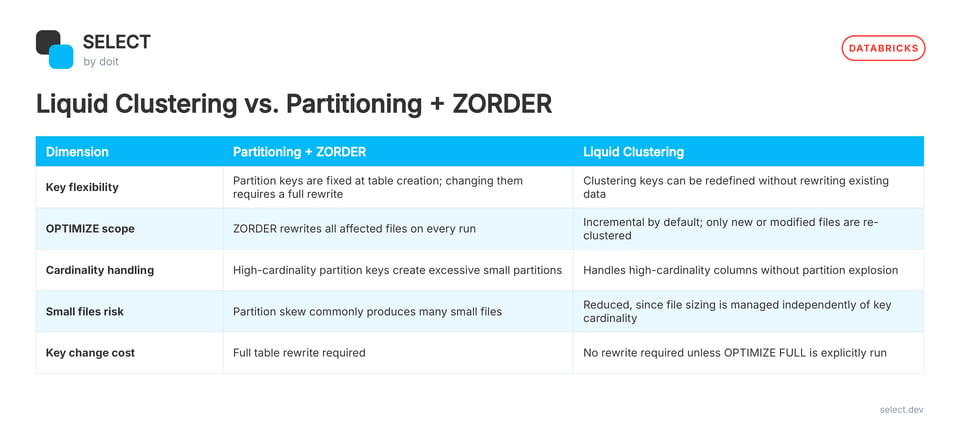
Diese Gegenüberstellung erklärt, warum Liquid Clustering Dateien effizienter überspringt als ZORDER – sie sagt aber nichts darüber, welche Spalten in die CLUSTER-BY-Klausel gehören. Genau bei dieser Entscheidung wird ein Großteil des Nutzens gewonnen oder verspielt.
Wie wählen Sie die richtigen Clustering-Keys?
Wählen Sie Clustering-Keys danach, wonach Ihre Abfragen am häufigsten filtern. Priorisieren Sie Spalten, die in WHERE-Klauseln und Joins auftauchen – auch solche mit hoher Kardinalität. Liquid Clustering überspringt Dateien anhand gespeicherter Min/Max-Statistiken statt physischer Ordnertrennung. Millionen unterschiedlicher Werte führen also nicht zu der Explosion kleiner Partitionen, die traditionelle Partitionierung mit sich bringt.
Spalten mit niedriger Kardinalität sind meist weniger effektiv. Wenn eine Spalte nur eine Handvoll unterschiedlicher Werte hat, bietet sich OPTIMIZE kaum Gelegenheit, Dateien zu überspringen. Das Limit von vier Spalten gilt weiterhin, doch zwei oder drei Spalten decken die meisten Produktionstabellen gut ab, während eine vierte oft kaum zusätzlichen Nutzen bringt.
Falsche Keys später zu korrigieren ist deutlich weniger disruptiv, als eine falsche Partitionsspalte zu korrigieren. ALTER TABLE ... CLUSTER BY ist eine reine Metadaten-Operation. Neue Schreibvorgänge und nachfolgende OPTIMIZE-Läufe übernehmen die aktualisierten Keys sofort, während Bestandsdaten ihr aktuelles Layout behalten, bis Sie sie mit OPTIMIZE FULL unter den neuen Keys re-clustern. Das erspart Ihnen dennoch das erzwungene Neuschreiben, das eine Änderung der Partitionsspalte erfordern würde – Sie entscheiden selbst, wann Sie diese Kosten in Kauf nehmen, statt sie bei der Änderung auszulösen.
Teams, die Clustering-Keys nicht manuell verwalten möchten, können CLUSTER BY AUTO einsetzen, sofern Unity Catalog und Predictive Optimization aktiviert sind. Databricks analysiert den Query-Verlauf und passt die Clustering-Keys an, wenn sich Ihre Filter verschieben. Prüfen Sie anschließend DESCRIBE DETAIL: Das Feld clusteringColumns zeigt die von AUTO gewählten Keys und aktualisiert sich bei jeder weiteren Anpassung.
Lässt sich eine bestehende Tabelle auf Liquid Clustering migrieren?
Zu verstehen, wie sich Liquid Clustering von Partitionierung und Z-Order unterscheidet, wird erst dann wirklich nützlich, wenn es einen praktikablen Weg gibt, bestehende Tabellen zu migrieren. Liquid Clustering kann nicht parallel zu PARTITIONED BY oder ZORDER BY existieren. Eine Tabelle nutzt den einen oder den anderen Ansatz – die Migration ersetzt also beides, statt Clustering obendrauf zu setzen.
Der Migrationsweg hängt von Ihrer Runtime-Version ab. Ab Databricks Runtime (DBR) 18.1 erledigt ein einziges Statement die Umstellung: ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (...). Dieser Befehl entfernt das bestehende Partitionierungsschema und definiert die Clustering-Keys in einem Schritt. Ältere Runtimes unterstützen ihn nicht. Der übliche Ausweg: Sie erstellen per CTAS eine neue, unpartitionierte Tabelle mit CLUSTER BY, befüllen sie in Datumsbereichs-Batches und tauschen die Tabellennamen, sobald die neue Tabelle fertig ist.
Die Clustering-Spalten sind wichtiger als die Migrationsmethode. Halten Sie sie, wo möglich, nah an den Spalten, die zuvor für die Partitionierung verwendet wurden. Databricks empfiehlt dieses Vorgehen, weil ein stark abweichender Spaltensatz beim ersten OPTIMIZE-Lauf ein deutlich größeres Re-Clustering auslösen kann statt eines schlanken inkrementellen Laufs.
Führen Sie nach der Umstellung kein OPTIMIZE mit ZORDER BY mehr aus. Ab diesem Punkt übernimmt das Standard-OPTIMIZE. Der erste Lauf verarbeitet die seit der letzten Z-Order-Operation geschriebenen Daten, alle späteren Läufe bleiben inkrementell. Die folgenden Beispiele zeigen beide Migrationspfade: den ALTER-TABLE-Ansatz für DBR 18.1 und höher sowie den CTAS-Fallback für ältere Runtimes.
-- DBR 18.1 und höher
ALTER TABLE events REPLACE PARTITIONED BY WITH CLUSTER BY (event_ts, user_id);

OPTIMIZE events;
-- Ein einfaches OPTIMIZE genügt hier. Die Tabelle war zuvor nicht geclustert,
-- es gibt also keinen bestehenden Clustering-Zustand abzugleichen.
-- Ältere Runtimes (vor DBR 18.1): CTAS-Fallback
CREATE OR REPLACE TABLE events_v2
CLUSTER BY (event_ts, user_id)
AS SELECT * FROM events
WHERE event_ts >= '2024-01-01' AND event_ts < '2025-01-01';

INSERT INTO events_v2
SELECT * FROM events
WHERE event_ts >= '2023-01-01' AND event_ts < '2024-01-01';

-- Für jeden Datumsbereich wiederholen, danach die Tabellennamen tauschen
OPTIMIZE events_v2;
-- Die neu eingefügten Daten vor dem Tausch clustern
Beide Wege führen zum selben Ergebnis: einem OPTIMIZE-Prozess, der sich auf neu geschriebene oder geänderte Daten konzentriert statt auf wiederholte vollständige Neuschreibvorgänge. Die nächste Frage ist, was diese Umstellung für die Kosten bedeutet – und ob die Einsparungen die Migration rechtfertigen.
Was kostet OPTIMIZE – und was zeigt Ihnen SELECT?
Liquid Clustering senkt die laufenden Kosten von OPTIMIZE, doch jeder Lauf verbraucht weiterhin Databricks-Compute und Databricks Units (DBUs) – die Metrik, nach der Databricks abrechnet. Photon kann diese Kosten zusätzlich beeinflussen. Zwar hat Photon einen höheren DBU-Satz, verarbeitet auf einer Tabelle mit Liquid Clustering aber oft weniger Daten, weil OPTIMIZE inkrementell arbeitet, statt große Teile der Tabelle neu zu schreiben. Der Aufpreis fällt dadurch auf einen kleineren Workload an.
Predictive Optimization nimmt Ihnen die Planung ab. Ist die Funktion auf einer von Unity Catalog verwalteten Tabelle aktiviert, entscheidet Databricks, wann OPTIMIZE läuft, und verbucht den Verbrauch unter der SKU predictive_optimization in system.billing.usage – neben allen anderen abrechenbaren Aktivitäten Ihres Accounts.
Zu wissen, dass OPTIMIZE DBUs verbraucht, ist hilfreich. Zu sehen, wie viele ein bestimmter Job über die Zeit verbraucht hat, zeigt dagegen, ob eine Migration die erwarteten Einsparungen tatsächlich gebracht hat. Der Databricks-Launch von SELECT im Juni 2026 wurde genau für diese Transparenz entwickelt: mit einer DBU-Attribution, die granular genug ist, um einzelne OPTIMIZE-Jobs nach Cluster und Workload zu verfolgen.
Teams, die OPTIMIZE-Kosten vor und nach einer Migration vergleichen möchten, können eine Demo von SELECT für Databricks buchen – die Anbindung dauert rund 20 Minuten.
Frequently asked
questions
Funktioniert Liquid Clustering mit Streaming-Tabellen und materialisierten Views?
Ja. Liquid Clustering lässt sich sowohl auf Streaming-Tabellen und materialisierte Views als auch auf Standard-Delta-Tabellen anwenden. Sie deklarieren CLUSTER BY auf dieselbe Weise, und OPTIMIZE reorganisiert die Dateien über alle drei Tabellentypen hinweg konsistent.
Kann ich OPTIMIZE weiterhin auf einer Tabelle mit Liquid Clustering verwenden?
Ja. OPTIMIZE ist der Befehl, mit dem Databricks Tabellen mit Liquid Clustering pflegt – derselbe Befehl, der anderswo für Partition Compaction und Z-Order zum Einsatz kommt. Das Standard-OPTIMIZE re-clustert nur neue oder geänderte Dateien, während OPTIMIZE FULL, verfügbar ab Databricks Runtime (DBR) 16.0 LTS, ein vollständiges Re-Clustering erzwingt. ZORDER BY wird auf einer geclusterten Tabelle nicht unterstützt.
Was ist CLUSTER BY AUTO und wann sollte ich es einsetzen?
Mit CLUSTER BY AUTO wählt und aktualisiert Databricks die Clustering-Keys selbstständig auf Basis des Query-Verlaufs, sofern Unity Catalog und Predictive Optimization aktiviert sind. Es eignet sich gut für Tabellen, deren Workloads sich über die Zeit ändern, oder für Teams, die die Key-Auswahl nicht manuell verwalten möchten.
Wie finde ich heraus, nach welchen Spalten eine Tabelle geclustert ist?
Führen Sie DESCRIBE DETAIL auf der Tabelle aus. Das Feld clusteringColumns zeigt die aktuellen Clustering-Keys. Bei aktiviertem CLUSTER BY AUTO aktualisiert sich das Feld, wenn Databricks die Key-Auswahl im Lauf der Zeit anpasst.
Wann sollte ich bei der Partitionierung bleiben, statt auf Liquid Clustering zu wechseln?
Für Datasets zwischen 1 TB und 100 TB ist Liquid Clustering in der Regel der bessere Standard. Bei größeren Workloads sollten Sie es testen, bevor Sie sich für Partitionierung entscheiden. Partitionierung ist weiterhin sinnvoll, wenn Abfragen konsequent auf einen schmalen Datenausschnitt zielen, etwa einen einzelnen Tag, da Directory Pruning in dieser Situation nach wie vor sehr effektiv ist.
Niall Woodward·Co-Founder & CTO von SELECT
Niall ist Co-Founder & CTO von SELECT, einer SaaS-Plattform für Snowflake-Kostenmanagement und -Optimierung. Vor der Gründung von SELECT war Niall Data Engineer bei Brooklyn Data Company und mehreren Startups. Als Open-Source-Enthusiast ist er außerdem Maintainer von SQLFluff und Schöpfer von drei dbt-Paketen: dbt_artifacts, dbt_snowflake_monitoring und dbt_query_tags.
In weniger als 15 Minuten startklar
Verbinden Sie Ihren Snowflake-, Databricks- oder BigQuery-Account und erkennen Sie sofort Ihr Einsparpotenzial.