
Lecture
TLDR
L'Adaptive Warehouse de Snowflake vous permet de définir un plafond de performance et un multiplicateur de concurrence plutôt que de vous engager sur une taille fixe. Nous l'avons confronté à Gen1 sur quatre tailles de warehouse et cinq types de workloads avec TPC-H SF1000. Adaptive l'emporte sur les requêtes isolées et les refreshs DML, où il lit la forme du travail et évite le surprovisionnement. Gen1 tient bon sur les workloads séquentiels et la concurrence intermédiaire. Les réglages restent entre vos mains : Adaptive change ce que le bouton contrôle, pas la nécessité d'y réfléchir.
Qu'est-ce que la nouvelle fonctionnalité Adaptive Warehouse de Snowflake ?
Le nouvel Adaptive Warehouse de Snowflake promet de vous décharger du dimensionnement. Au lieu de choisir une taille fixe, un scale factor, QAS, et de jongler avec Suspend et Resume — en payant pour une capacité que vos plus petites requêtes n'utiliseront jamais pleinement — Snowflake mutualise et dimensionne automatiquement le compute en coulisses et ne vous facture que ce que chaque requête consomme réellement. La question évidente : cela fait-il vraiment économiser de l'argent, et dans quels cas ? Pour le savoir, nous l'avons confronté au warehouse Gen1 classique sur TPC-H SF100 (table lineitem d'environ 600 M de lignes), sur quatre tailles (Small → XLarge) et cinq profils de workloads.
Les réglages d'Adaptive
Adaptive dispose de deux réglages : MAX_QUERY_PERFORMANCE_LEVEL (son plafond de taille) et QTM, le multiplicateur de débit de requêtes, un réglage de concurrence et de burst. Examinons-les en détail : c'est précisément ce que mesure chaque graphique de ce benchmark.
MAX_QUERY_PERFORMANCE_LEVEL
Le plafond de performance de toute requête individuelle, exprimé en taille de t-shirt de XSMALL à X4LARGE (par défaut : XLARGE). Snowflake l'utilise comme borne supérieure, pas comme allocation fixe : le moteur choisit les ressources qu'il estime nécessaires à la requête et plafonne ce choix à ce niveau. Pour les petites requêtes, il peut en utiliser bien moins ; pour les grosses, il n'ira pas plus haut. Un réglage bas économise de l'argent mais peut ralentir vos requêtes les plus lourdes ; un réglage haut libère toute la performance, mais une seule requête gourmande peut dépenser en conséquence. Point important : cela ne correspond pas à une configuration de compute sous-jacente précise ; Snowflake détermine les ressources réellement nécessaires pour chaque requête. Concrètement, impossible d'affirmer \"cette requête a réellement tourné sur un Small et a été facturée au tarif de crédits Small\". Ce n'est PAS un plafond de facturation, c'est un plafond de performance.
QUERY_THROUGHPUT_MULTIPLIER (QTM)
Un facteur d'échelle entier (par défaut : 2) qui détermine la capacité de burst que le warehouse peut utiliser à un instant donné. Snowflake calcule une capacité de base interne à partir de votre MAX_QUERY_PERFORMANCE_LEVEL, puis la multiplie par QTM pour obtenir le plafond de concurrence. QTM=N signifie que le warehouse peut exécuter environ N requêtes simultanément au niveau de performance maximal — et comme la plupart des requêtes utilisent moins que le maximum, vous obtenez souvent plus de débit en pratique. QTM=0 signifie un burst illimité. Le compromis : un QTM élevé réduit les files d'attente mais relève le plafond de dépense instantanée ; un QTM bas plafonne les coûts mais risque de faire s'accumuler les requêtes.
Comment sont facturés les Adaptive Warehouses
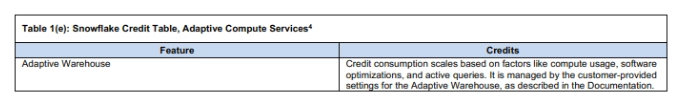
Adaptive repose sur un modèle de facturation à la requête : au lieu de facturer à la seconde une réservation de warehouse fixe, Snowflake facture en fonction des ressources de compute et logicielles que chaque requête consomme réellement. La création du warehouse ne coûte rien ; le compteur démarre à la première requête. L'usage est agrégé au niveau du warehouse et reporté en crédits de virtual warehouse standards sous COMPUTE, de sorte que vos structures de chargeback et de showback existantes continuent de fonctionner.
La facturation est, pour être franc, assez opaque. Snowflake décrit le coût comme dépendant de \"facteurs tels que la quantité de ressources de compute et logicielles\" utilisées par une requête, sans fournir de formule pour additionner les composantes. La ventilation du coût par requête est prévue pour la GA, mais n'est pas disponible en Public Preview. Il n'existe aucun moyen de vérifier quelles ressources Snowflake a réellement allouées à une requête donnée, ni d'auditer pourquoi elle a coûté ce qu'elle a coûté. Il faut donc accorder une confiance significative à Snowflake pour allouer équitablement et facturer en conséquence. Vous définissez vos deux réglages, vous lancez votre workload, et vous lisez la facture agrégée. Pour beaucoup d'équipes, ce compromis est probablement raisonnable, mais mieux vaut y aller en connaissance de cause.
Voici une capture d'écran de la formulation exacte de Snowflake concernant la tarification :
Suivre les dépenses d'un Adaptive Warehouse
Trois vues ACCOUNT_USAGE sont pertinentes pour les adaptive warehouses. WAREHOUSE_METERING_HISTORY est la principale pour la consommation de crédits au niveau du warehouse. QUERY_HISTORY permet de voir la performance et le timing de chaque requête, même si les coûts en crédits par requête ne sont pas détaillés durant la Public Preview. WAREHOUSE_LOAD_HISTORY vous renseigne sur les files d'attente — votre signal pour ajuster QTM. À noter : pour les adaptive warehouses, l'usage de QAS est intégré aux crédits de compute et n'apparaît pas dans une colonne séparée, contrairement aux warehouses standards.
Consommation de crédits par adaptive warehouse sur les 30 derniers jours :
WITH adaptive_whs AS (
  SELECT DISTINCT warehouse_name
  FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
  WHERE warehouse_size = 'ADAPTIVE'
    AND start_time >= DATEADD(day, -30, CURRENT_DATE())
)
SELECT
  m.warehouse_name,
  SUM(m.credits_used)         AS total_credits,
  SUM(m.credits_used_compute) AS compute_credits,
  MIN(m.start_time)           AS first_activity,
  MAX(m.end_time)             AS last_activity
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m
JOIN adaptive_whs a ON a.warehouse_name = m.warehouse_name
WHERE m.start_time >= DATEADD(day, -30, CURRENT_DATE())
Afficher le code
Performance et timing des requêtes depuis QUERY_HISTORY. C'est ce qui se rapproche le plus, à ce jour, d'une visibilité du coût par requête ; l'attribution réelle des crédits par requête n'est pas exposée en Public Preview :
SELECT
  query_id,
  warehouse_name,
  query_type,
  total_elapsed_time / 1000  AS elapsed_sec,
  execution_time / 1000      AS exec_sec,
  queued_overload_time / 1000 AS queued_sec,
  partitions_scanned,
  bytes_scanned,
  start_time
FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
WHERE warehouse_size = 'ADAPTIVE'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY total_elapsed_time DESC
LIMIT 200;
Comportement des files d'attente depuis WAREHOUSE_LOAD_HISTORY. Si avg_queued_load est systématiquement au-dessus de zéro, votre QTM est trop bas pour le workload :
SELECT
  start_time,
  warehouse_name,
  avg_running,
  avg_queued_load,
  avg_queued_provisioning,
  avg_blocked
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_LOAD_HISTORY
WHERE warehouse_name = '<your_adaptive_warehouse>'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY start_time;
Le dispositif de benchmark
Le benchmark s'exécute sur TPC-H au Scale Factor 1000 (SF1000), ce qui porte la table lineitem à environ 600 millions de lignes. SF1000 est assez volumineux pour que la taille du warehouse compte réellement sur les requêtes intensives en scans, mais assez modeste pour garder des coûts par exécution raisonnables sur de nombreuses configurations.
Toutes les requêtes sont des versions adaptées du jeu TPC-H standard, écrites pour la syntaxe Snowflake. Vous pouvez parcourir le jeu de requêtes complet ici : adapted_queries. Chaque warehouse a tourné sur une instance fraîchement créée, afin que la facturation de Snowflake ne mélange jamais les crédits entre configurations. Nous avons testé de XSmall à XLarge, pour Gen1 comme pour Adaptive. Oui, nous avons testé un XS sur 600 M de lignes — et vous seriez surpris de voir à quel point ce warehouse s'en sort bien, même sur les étapes ETL.
Nous avons testé ces cinq types de workloads :
- Une requête unique, pour déterminer le minimum que vous pouvez dépenser sur chaque type de warehouse.
- Une exécution séquentielle de 66 requêtes (les 22 requêtes exécutées 3 fois) pour mesurer un workload constant de plus d'une minute.
- Les 22 requêtes lancées simultanément pour tester le débit.
- Un refresh DML.
- CTAS, avec plusieurs formes de données.
Dernière remarque avant de plonger : vous pouvez facilement reproduire ce benchmark vous-même en clonant le repo et en suivant le readme. Le tout est 100 % reproductible de votre côté.
Répondre à une seule requête au moindre coût
L'objectif : exécuter une requête qui se termine en moins d'une minute, pour la dépense la plus faible possible.
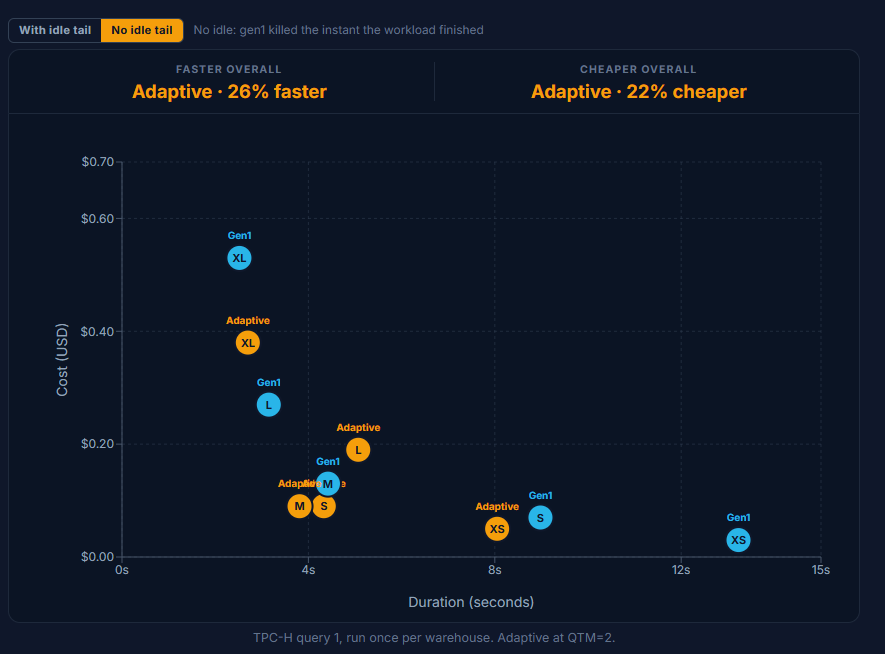
Toutes les tailles répondent à la requête 1 bien en dessous d'une minute ; le plus lent ici est Gen1 Small à 8 secondes, le plus rapide à ~2,5 s. La latence n'est pas la contrainte ; c'est la dépense. La question devient donc : jusqu'où pouvez-vous réduire la dépense pour une réponse que vous obtiendrez de toute façon ?
Sur Gen1, le réglage de taille se comporte exactement comme attendu. Montez d'une taille et le temps de requête est à peu près divisé par deux tandis que le prix double environ : Small en 9,5 s pour 0,07 $, Medium en 4,3 s pour 0,14 $, Large en 3,1 s pour 0,28 $. À XLarge, ce ne sont plus que des rendements décroissants : 0,55 $ pour 3,4 s, pas plus rapide que Large pour le double du prix.
Sur Adaptive, le tableau est plus intéressant. Small, Medium et Large restent relativement proches, puis XLarge fait bande à part : il coûte environ 4 fois plus que Small et Medium (0,38 $ contre 0,09 $) tout en terminant à peine une seconde plus vite que Medium (2,7 s contre 3,8 s). Vous payez un lourd surcoût pour une accélération à peine mesurable.
Graphique : requête TPC-H 1, exécutée une fois par warehouse. Adaptive à QTM=2.
💡 À retenir
Si vous laissez Snowflake aller chercher des ressources plus importantes, il le fera volontiers, même quand des ressources plus modestes auraient produit la réponse pour moins cher. Le plafond de taille ne semble pas, à lui seul, pousser votre travail vers un compute plus petit : réglez-le haut et vous paierez cher. Cette réserve mise à part, Adaptive remporte tout de même ce scénario de requête unique, plus rapide en moyenne et moins cher en moyenne que Gen1.
Un warehouse occupé en continu
L'objectif : simuler un workload régulier et enchaîné qui maintient un warehouse à pleine saturation.
Soixante-six requêtes s'exécutent en séquence, sans interruption : le warehouse ne tourne jamais à vide. Que cette charge soit une chaîne de jobs planifiés, un flux constant de requêtes ou un analyste qui travaille toute la journée, la forme est la même : du travail continu. C'est le test le plus propre de la valeur brute du compute, car sans temps d'inactivité à récupérer, l'élasticité n'a rien à optimiser.
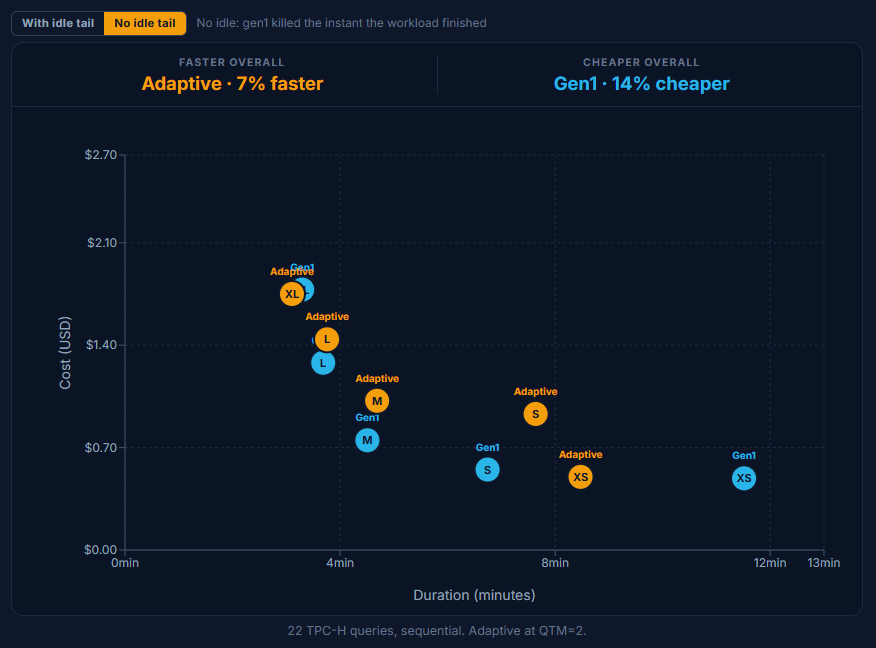
Sur la vitesse brute, les deux sont plus proches qu'on pourrait le croire, et Gen1 tient bon. Adaptive n'est nettement plus rapide qu'en taille XS (environ 8,5 minutes contre 11,4) ; en Small, Medium et Large, Gen1 termine en réalité un peu plus tôt, et en XLarge ils font jeu égal à ~3,2 minutes. Côté coût, Gen1 mène sur la majeure partie de la gamme et au global.
Graphique : 22 requêtes TPC-H, en séquence. Adaptive à QTM=2.
💡 À retenir
Sur un warehouse occupé en continu, Gen1 est la bête de somme : une vitesse comparable à Adaptive sur la plupart des tailles, et moins cher de XSmall à Large. Adaptive se justifie aux extrêmes : un gros gain de vitesse sur la plus petite taille et une vraie économie uniquement en XLarge. Pour des workloads réguliers et saturés au milieu de la gamme de tailles, un warehouse Gen1 fixe remporte ce scénario.
Concurrence : Adaptive est plus rapide, le coût dépend de la taille
L'objectif : lancer 22 requêtes simultanément — un outil BI, un refresh de dashboard, toute une équipe qui sollicite le warehouse en même temps.
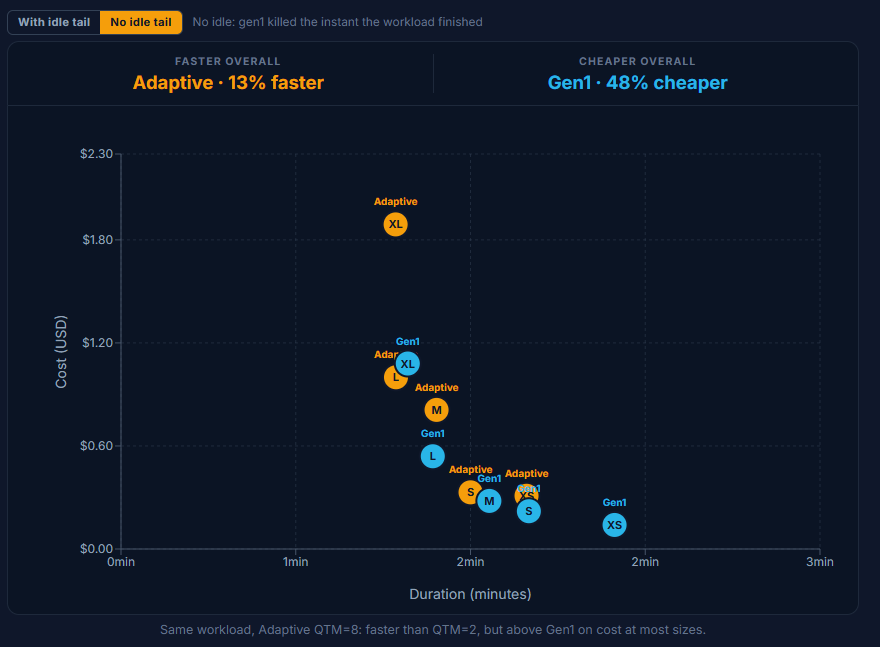
Gen1 absorbe un pic de concurrence par le scale-out multi-cluster, ici plafonné à quatre clusters et facturé par cluster actif. Adaptive, au contraire, mutualise les requêtes dans un compute partagé et monte en burst via le réglage QTM : un QTM plus élevé achète plus de compute parallèle — et plus de crédits. Le réglage de fin d'inactivité ne joue que sur Gen1 : couper le warehouse dès la fin du burst (sans période d'inactivité résiduelle) rogne sa facture d'environ 0,10 à 0,20 $ par taille ; Adaptive n'a aucune notion d'inactivité et n'est pas concerné.
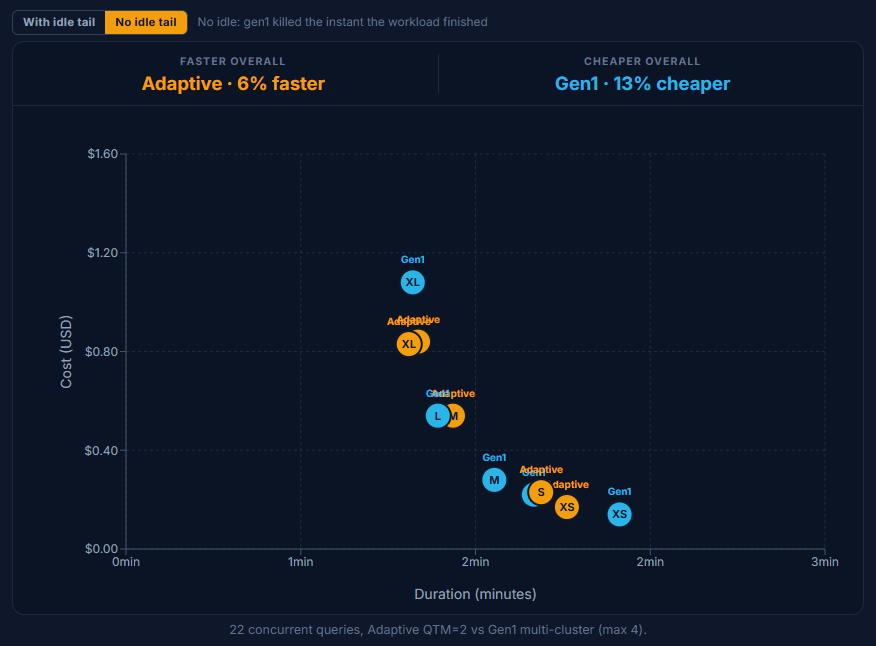
À QTM=2, Adaptive absorbe le burst plus vite que Gen1 à chaque taille. Côté coût, c'est mitigé : Adaptive est moins cher en bas de gamme (XSmall 0,17 $ contre 0,23 $, Small 0,23 $ contre 0,34 $) et de nouveau en XLarge (0,83 $ contre 1,26 $), tandis que le modèle multi-cluster de Gen1 reste plus économique au milieu (Medium 0,39 $ contre 0,54 $, Large 0,69 $ contre 0,84 $).
Pousser à QTM=8 est encore plus rapide, mais vous le payez : il dépasse Gen1 sur la plupart des tailles (Medium 0,81 $ contre 0,39 $, XLarge 1,89 $ contre 1,26 $) et ne fait jeu égal qu'en Small. QTM=8 ne se justifie que lorsque la latence prime clairement sur la facture. (Le plus probable : la file s'est vidée plus vite et il ne restait qu'à attendre la fin de la requête la plus lente.)
Graphique : 22 requêtes concurrentes, Adaptive QTM=2 contre Gen1 multi-cluster (max 4).
Graphique : même workload, Adaptive QTM=8 — plus rapide que QTM=2 mais au-dessus de Gen1 en coût sur la plupart des tailles.
💡 À retenir
Pour la concurrence, Adaptive est le moteur le plus rapide à chaque taille. Le piège, c'est le réglage QTM. Passer de QTM=2 à QTM=8 ne fait gagner que quelques secondes (Medium de 84 s à 81 s, XLarge de 73 s à 71 s) alors que la facture double à peu près (Medium de 0,54 $ à 0,81 $, XLarge de 0,83 $ à 1,89 $). Nous avons réglé QTM trop haut pour ce workload : Snowflake n'avait pas besoin de cette marge pour absorber le burst, mais il nous l'a tout de même facturée pour l'avoir réservée. Ne définissez un QTM élevé que lorsque vous en avez réellement besoin.
Un refresh DML : le job d'écriture ETL
L'objectif : un refresh delete + insert pour imiter un job incrémental typique.
Le job est ici un refresh incrémental réaliste : supprimer un mois de lineitem et le réinsérer depuis la source, soit environ 1 % des lignes d'une table de ~600 M de lignes. La table de base est volumineuse, mais le changement, lui, ne l'est pas. Le pruning de micro-partitions de Snowflake cible exactement les partitions touchées par ce mois et ignore le reste : le moteur voit donc d'emblée qu'il s'agit d'une écriture petite et chirurgicale, pas d'une réécriture complète de la table. C'est la clé de tout ce qui suit.
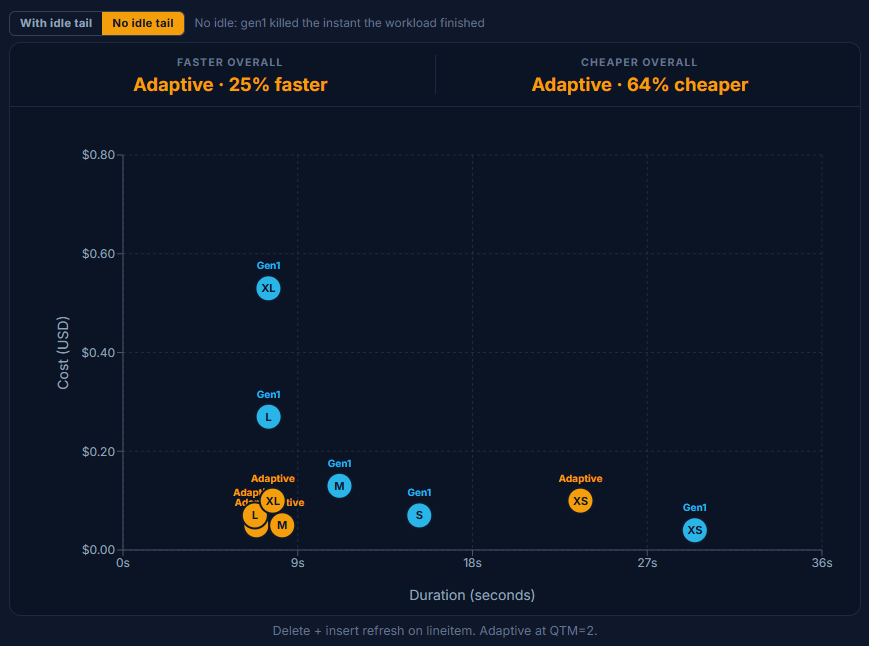
Gen1 vous oblige à vous engager sur une taille à l'avance et la facture au minimum, que le pic ait eu besoin de cette taille ou non. Le delete plus insert se termine en quelques secondes dès Small, et pourtant le prix de Gen1 grimpe tout droit avec le réglage : 0,05 $ en XSmall, 0,08 $ en Small, 0,15 $ en Medium, 0,29 $ en Large, 0,60 $ en XLarge. Vous payez le warehouse, pas le travail.
Adaptive raconte l'histoire inverse, et c'est le chapitre où il paraît le plus intelligent. Remarquez à quel point Small, Medium, Large et XLarge sont regroupés : 0,05 $, 0,05 $, 0,07 $, 0,09 $. Ils arrivent même dans un ordre de prix impeccable, et pourtant en XLarge le compteur a à peine bougé par rapport à Small. Un delete plus insert se réduit par pruning à une tranche étroite de partitions, et Snowflake reconnaît manifestement qu'il peut terminer le job sans y jeter du compute coûteux ; il refuse de surprovisionner, même quand le plafond de taille le lui permettrait. La facture suit le travail, pas le réglage.
La seule exception est XSmall, où Adaptive (0,10 $) reste derrière Gen1 (0,05 $). Sans warehouse surdimensionné et inactif à récupérer, le surcoût par requête d'Adaptive n'a rien pour se rembourser — exactement le schéma du chapitre 2.
Graphique : refresh delete + insert sur lineitem. Adaptive à QTM=2.
💡 À retenir
C'est Adaptive dans ce qu'il a de plus intelligent. Il lit la forme du travail — une écriture de 1 % fortement élaguée sur une immense table — et reste délibérément petit au lieu d'encaisser le plafond de taille que vous lui avez accordé. Même pointé sur XLarge, il dépense comme un Small parce que c'est tout ce dont le job a besoin : la facture suit les ressources utilisées, pas le réglage choisi. Pour les pipelines incrémentaux, c'est exactement le comportement souhaité, et cela supprime entièrement la taxe du dimensionnement à l'aveugle.
La facturation de Snowflake gagne en complexité, pas l'inverse. Si vous y gérez en plus des workloads d'IA et de ML, la surface de coûts devient vite difficile à lire. Nous avons rédigé un guide pratique sur la façon de réellement maîtriser les dépenses à travers Cortex, le serving de modèles et le reste de la stack.
Téléchargez le manuel officieux d'optimisation des coûts IA pour Snowflake
CTAS : une écriture lourde, dominée par les scans
L'objectif : CREATE TABLE AS SELECT sur cinq formes de données — une lecture massive alimentant la matérialisation d'une table complète.
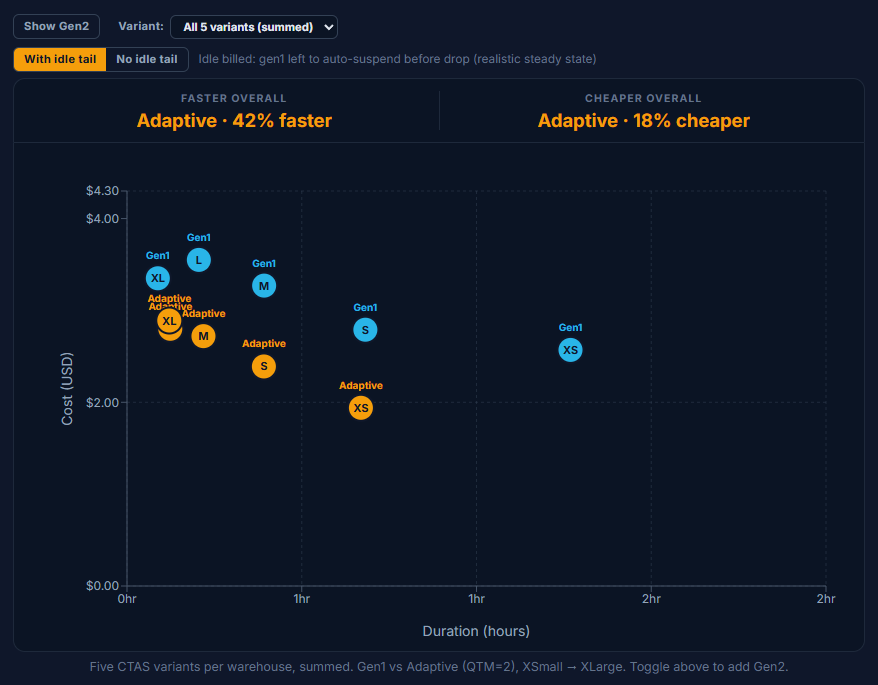
Là où le refresh DML était une écriture chirurgicale de 1 %, CTAS est l'opposé : cinq variantes de CREATE TABLE AS SELECT (narrow/tall, standard/tall, medium/wide, very wide et une forme filtrée) qui scannent et matérialisent en masse. Pas de warehouse inactif à récupérer ni de raccourci de pruning : le travail est du vrai compute — l'endroit le plus propre pour lire le prix brut par unité de débit des trois générations de warehouse, côte à côte.
Sur le coût, Adaptive est le moins cher à chaque taille : 1,94 $ / 2,39 $ / 2,72 $ / 2,80 $ / 2,89 $ de XSmall à XLarge, bien en dessous des 2,57 $ / 2,79 $ / 3,27 $ / 3,55 $ / 3,35 $ de Gen1. Sur la vitesse, Adaptive devance aussi Gen1 de XSmall à Large — mais l'ordre s'inverse en XLarge.
Cette inversion en XLarge est la faute d'une seule variante. Adaptive en XLarge termine en 7,3 minutes, plus lentement que les 5,3 minutes de Gen1, parce que la variante very_wide cesse de scaler sur Adaptive : environ 6 minutes à elle seule en XLarge, alors que les quatre autres variantes se terminent en quelques secondes. Utilisez le filtre de variantes ci-dessus pour l'exclure (ou explorer une seule variante) et l'anomalie disparaît.
💡 À retenir
Adaptive est le moins cher de XSmall à XLarge, et aussi le plus rapide de XSmall à Large. Le piège, c'est XLarge, où une variante (very_wide) casse le scaling d'Adaptive et fait basculer le graphique derrière Gen1. Utilisez le filtre de variantes ci-dessus pour l'exclure ou explorer une seule forme de requête, et activez Gen2 pour voir comment le nouveau warehouse standard se positionne.
Frequently asked
questions
Soyez opérationnel en moins de 15 minutes
Connectez votre compte Snowflake, Databricks ou BigQuery et visualisez instantanément votre potentiel d'économies.
Adaptive n'est pas une réduction de coûts clé en main. C'est le principal enseignement de ce benchmark, et il va à l'encontre de ce que beaucoup de clients avec qui nous avons échangé attendaient de cette fonctionnalité. Sur nos cinq profils de workloads, Adaptive s'est révélé moins cher dans certains scénarios, plus cher dans d'autres, et à peu près équivalent pour le reste. Nous ne recommandons à aucun client de basculer soudainement tous ses warehouses sur Adaptive en espérant voir sa facture baisser — en réalité, elle augmenterait probablement. Adaptive est optimisé pour la performance, pas pour le coût. C'est le fil conducteur de la plupart de nos expériences. Face à un plafond de taille ou un réglage QTM, Snowflake ira généralement chercher le plafond que vous lui accordez pour renvoyer la réponse la plus rapide possible. Le chapitre 1 l'a montré avec MAX_QUERY_PERFORMANCE_LEVEL : XLarge coûtant ~4 fois plus que le réglage Small pour une accélération à peine mesurable. Le chapitre 3 l'a montré avec QTM : passer de QTM=2 à QTM=8 a fait gagner quelques secondes et a à peu près doublé la facture. L'exception nette est le refresh DML du chapitre 4, où Adaptive a lu la forme d'une écriture de 1 % fortement élaguée et est délibérément resté petit, même pointé sur XLarge. Le moteur peut donc se retenir ; il ne le fait simplement pas de manière cohérente selon les profils de workloads. La conclusion n'est pas qu'Adaptive est imprudent, c'est que les réglages doivent encore être ajustés et configurés avec soin.
Vous devez toujours réfléchir à la configuration de vos warehouses. La promesse d'Adaptive était de faire disparaître les décisions de dimensionnement. En pratique, ce benchmark montre qu'elles ont simplement changé de forme : au lieu de choisir une taille fixe, vous choisissez désormais un MAX_QUERY_PERFORMANCE_LEVEL (un plafond de dépense) et un QTM (un plafond de concurrence et de burst). Les deux changent sensiblement la facture. Réglez-les trop haut par précaution et vous paierez pour une marge dont vous n'aviez pas besoin.
Vous devez benchmarker vos propres workloads. Nos résultats sont spécifiques à TPC-H SF1000 et aux cinq profils de workloads que nous avons exécutés. Vos requêtes, votre organisation des données, votre comportement de pruning, votre profil de concurrence et vos périodes d'inactivité produiront des chiffres différents. Les tendances dégagées sont utiles comme hypothèse de départ ; elles ne remplacent pas un test d'Adaptive sur votre workload réel avec vos données réelles. Le repo du benchmark est reproductible : forkez-le, remplacez les requêtes par les vôtres et mesurez avant de migrer quoi que ce soit d'important.
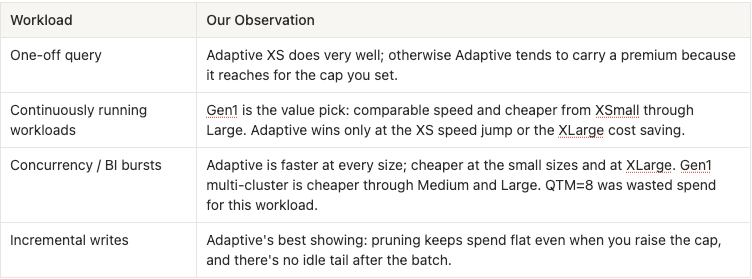
Cela dit, voici les observations que nous avons faites en benchmarkant nos propres workloads :
Avez-vous benchmarké Adaptive sur vos propres workloads ? Nous serions ravis de connaître vos résultats ! Écrivez-nous : nous cherchons toujours à affiner notre compréhension de son comportement en conditions réelles.