
Reproduzir
TLDR
O Adaptive Warehouse do Snowflake permite definir um teto de performance e um multiplicador de concorrência em vez de se comprometer com um tamanho fixo. Nós o colocamos frente a frente com o Gen1 em quatro tamanhos de warehouse e cinco tipos de workloads no TPC-H SF1000. O Adaptive vence em queries isoladas e refreshes via DML, cenários em que ele lê o formato do trabalho e não provisiona além do necessário. O Gen1 se sai bem em workloads sequenciais e concorrência de médio porte. Os ajustes continuam nas suas mãos. O Adaptive muda o que o botão controla, não a necessidade de pensar no assunto.
O que é o novo Adaptive Warehouse do Snowflake?
O novo Adaptive Warehouse do Snowflake promete tirar o dimensionamento das suas mãos. Em vez de escolher um tamanho fixo, scale factor, QAS e ficar mexendo em Suspend e Resume, pagando por capacidade que suas queries menores nunca vão usar por completo, o Snowflake agrupa e escala a computação automaticamente nos bastidores e cobra apenas pelo que cada query realmente consome. A pergunta óbvia é se isso economiza dinheiro de verdade — e onde. Para descobrir, colocamos o recurso frente a frente com o warehouse clássico Gen1 no TPC-H SF100 (lineitem com ~600 milhões de linhas), em quatro tamanhos (Small → XLarge) e cinco formatos de workloads.
Configurações do Adaptive
O Adaptive tem dois ajustes: MAX_QUERY_PERFORMANCE_LEVEL (seu teto de tamanho) e o QTM, o multiplicador de throughput de queries, um controle de concorrência/burst. Vamos olhar cada um em detalhe; é exatamente isso que cada gráfico deste benchmark está medindo.
MAX_QUERY_PERFORMANCE_LEVEL
O teto de performance para qualquer query individual, expresso como tamanho de camiseta, de XSMALL a X4LARGE (padrão: XLARGE). O Snowflake o usa como limite superior, não como alocação fixa: o mecanismo escolhe os recursos que considera necessários para a query e limita essa escolha a esse nível. Para queries pequenas, pode usar bem menos; para as grandes, não vai além. Definir um valor baixo economiza dinheiro, mas pode deixar suas maiores queries mais lentas; definir um valor alto libera a performance total, mas significa que uma única query pesada pode gastar na mesma proporção. Importante: isso não corresponde a uma configuração de computação subjacente específica; o Snowflake determina os recursos reais necessários para cada query. Em outras palavras, não dá para afirmar que "essa aqui de fato rodou em um Small e foi cobrada na taxa de créditos de um Small". Isso NÃO é um teto de cobrança, é um teto de performance.
QUERY_THROUGHPUT_MULTIPLIER (QTM)
Um fator de escala inteiro (padrão: 2) que define quanta capacidade de burst o warehouse pode usar a qualquer instante. O Snowflake calcula uma capacidade-base interna a partir do seu MAX_QUERY_PERFORMANCE_LEVEL e a multiplica pelo QTM para obter o teto de concorrência. Definir QTM=N significa que o warehouse pode rodar aproximadamente N queries simultâneas no nível máximo de performance — embora, como a maioria das queries usa menos que o máximo, na prática você costuma obter mais throughput. QTM=0 significa burst ilimitado. O trade-off: um QTM mais alto reduz filas, mas eleva o teto de gasto instantâneo; um QTM mais baixo limita custos, mas corre o risco de queries se acumularem.
Como os Adaptive Warehouses são cobrados
O Adaptive usa um modelo de cobrança por query: em vez de cobrar por segundo por uma reserva fixa de warehouse, o Snowflake cobra com base nos recursos de computação e software que cada query realmente consome. Você não paga nada para criar o warehouse; o medidor começa a rodar na primeira query. O uso é agregado no nível do warehouse e reportado em créditos padrão de virtual warehouse sob COMPUTE, então as estruturas existentes de chargeback e showback continuam funcionando.
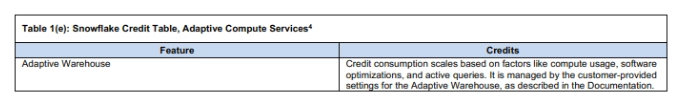
A cobrança é, francamente, bastante opaca. O Snowflake descreve o custo como dependente de "fatores como a quantidade de recursos de computação e software" que uma query usa, mas não fornece uma fórmula de como somar os componentes. O detalhamento de custo por query está planejado para o GA, mas não está disponível no Public Preview. Não há como verificar quais recursos o Snowflake de fato alocou para uma query específica, nem auditar por que ela custou o que custou. Isso exige depositar uma dose significativa de confiança no Snowflake para alocar de forma justa e cobrar de acordo. Você define seus dois ajustes, roda seu workload e lê a fatura agregada. Para muitas equipes, essa troca provavelmente é razoável, mas vale entrar de olhos abertos.
Aqui está um screenshot de exatamente como o Snowflake descreveu o preço:
Monitorando os gastos do Adaptive Warehouse
Três views de ACCOUNT_USAGE são relevantes para adaptive warehouses. A WAREHOUSE_METERING_HISTORY é a principal para o consumo de créditos no nível do warehouse. A QUERY_HISTORY permite ver a performance e os tempos de cada query individual, embora os custos de créditos por query não sejam detalhados durante o Public Preview. A WAREHOUSE_LOAD_HISTORY informa sobre filas — o seu sinal para decidir se o QTM precisa de ajuste. Vale notar: o uso de QAS é incorporado aos créditos de computação nos adaptive warehouses e não aparece como coluna separada, ao contrário dos warehouses padrão.
Consumo de créditos por adaptive warehouse nos últimos 30 dias:
WITH adaptive_whs AS (
  SELECT DISTINCT warehouse_name
  FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
  WHERE warehouse_size = 'ADAPTIVE'
    AND start_time >= DATEADD(day, -30, CURRENT_DATE())
)
SELECT
  m.warehouse_name,
  SUM(m.credits_used)         AS total_credits,
  SUM(m.credits_used_compute) AS compute_credits,
  MIN(m.start_time)           AS first_activity,
  MAX(m.end_time)             AS last_activity
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m
JOIN adaptive_whs a ON a.warehouse_name = m.warehouse_name
WHERE m.start_time >= DATEADD(day, -30, CURRENT_DATE())
Expandir código
Performance e tempos das queries na QUERY_HISTORY. É o mais próximo de visibilidade de custo por query disponível hoje; a atribuição real de créditos por query não é exposta no Public Preview:
SELECT
  query_id,
  warehouse_name,
  query_type,
  total_elapsed_time / 1000  AS elapsed_sec,
  execution_time / 1000      AS exec_sec,
  queued_overload_time / 1000 AS queued_sec,
  partitions_scanned,
  bytes_scanned,
  start_time
FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
WHERE warehouse_size = 'ADAPTIVE'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY total_elapsed_time DESC
LIMIT 200;
Comportamento de filas na WAREHOUSE_LOAD_HISTORY. Se avg_queued_load estiver consistentemente acima de zero, seu QTM está baixo demais para o workload:
SELECT
  start_time,
  warehouse_name,
  avg_running,
  avg_queued_load,
  avg_queued_provisioning,
  avg_blocked
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_LOAD_HISTORY
WHERE warehouse_name = '<your_adaptive_warehouse>'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY start_time;
A configuração do benchmark
O benchmark roda contra o TPC-H em Scale Factor 1000 (SF1000), o que coloca a tabela lineitem em aproximadamente 600 milhões de linhas. O SF1000 é grande o suficiente para que o tamanho do warehouse realmente importe em queries pesadas de scan, mas pequeno o bastante para manter os custos por execução razoáveis em muitas configurações.
Todas as queries são versões adaptadas do conjunto padrão do TPC-H, escritas na sintaxe do Snowflake. Você pode navegar pelo conjunto completo aqui: adapted_queries. Cada warehouse rodou em uma instância recém-criada, para que a cobrança do Snowflake nunca misturasse créditos entre configurações. Testamos de XSmall a XLarge tanto no Gen1 quanto no Adaptive. Isso mesmo: testamos um XS com 600 milhões de linhas, e você ficaria surpreso com o quanto esse warehouse se sai bem, até nas etapas de ETL.
Testamos estes cinco tipos de workloads:
- Uma única query, para descobrir o mínimo que você pode gastar em cada tipo de warehouse.
- Uma execução sequencial de 66 queries, rodando as 22 queries 3 vezes para medir um workload constante que dura mais de um minuto.
- As 22 queries disparadas simultaneamente para testar o throughput.
- Refresh via DML.
- CTAS, com vários formatos de dados.
Última observação antes de mergulharmos. Você pode facilmente rodar este benchmark por conta própria clonando o repositório e seguindo o readme. Ele é 100% reproduzível por você.
A forma mais barata de responder uma única query
O objetivo: rodar uma query que termine em menos de um minuto, com o menor gasto possível.
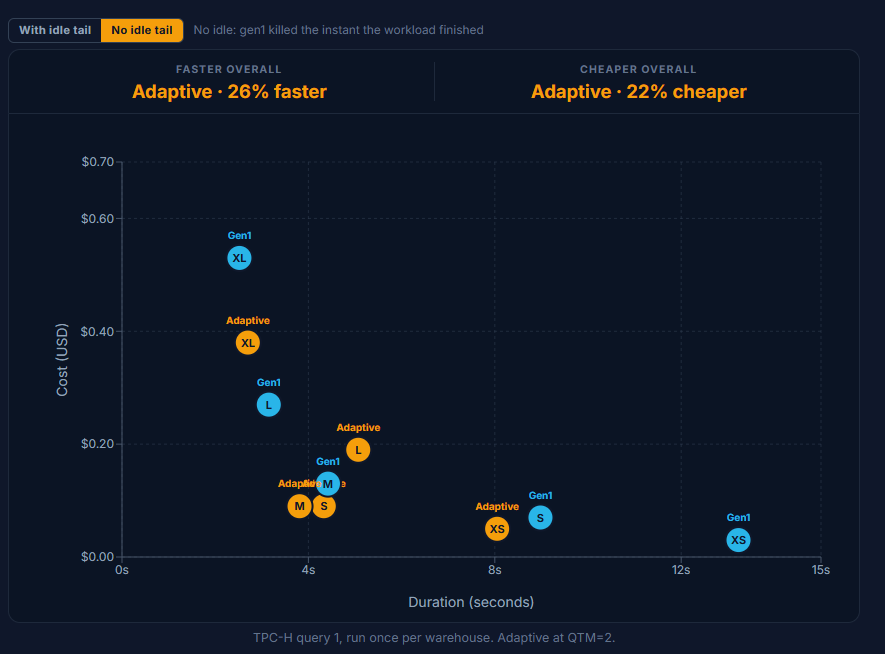
Todos os tamanhos respondem a query 1 bem abaixo de um minuto; o mais lento aqui é o Gen1 Small, com 8 segundos, e o mais rápido fica em ~2,5s. A latência não é a restrição; o gasto é. Então a pergunta vira: quão pouco dá para pagar por uma resposta que você vai obter de qualquer forma?
No Gen1, o controle de tamanho se comporta exatamente como você esperaria. Suba um tamanho e o tempo da query cai aproximadamente pela metade, enquanto o preço mais ou menos dobra: Small em 9,5s por US$ 0,07, Medium em 4,3s por US$ 0,14, Large em 3,1s por US$ 0,28. No XLarge é puro retorno decrescente: US$ 0,55 por 3,4s, sem ser mais rápido que o Large, pelo dobro do preço.
No Adaptive, o quadro é mais interessante. Small, Medium e Large ficam relativamente próximos, e então o XLarge se destaca como o ponto fora da curva: custa cerca de 4x o Small e o Medium (US$ 0,38 vs US$ 0,09) e termina apenas cerca de um segundo mais rápido que o Medium (2,7s vs 3,8s). Você paga caro por um ganho de velocidade que mal dá para medir.
Gráfico: query 1 do TPC-H, executada uma vez por warehouse. Adaptive com QTM=2.
💡Conclusão
Se você deixar o Snowflake alcançar recursos maiores, ele fará isso de bom grado, mesmo quando recursos menores teriam produzido a resposta mais barata. O teto de tamanho não parece, por si só, empurrar seu trabalho para computação menor; defina-o alto e você paga alto. Com essa ressalva, o Adaptive ainda vence essa query individual no geral: mais rápido na média e mais barato na média que o Gen1.
Um warehouse mantido continuamente ocupado
O objetivo: simular um workload constante, em sequência, que mantém o warehouse totalmente saturado.
Sessenta e seis queries rodam em sequência, sem intervalos, de modo que o warehouse nunca fica ocioso. Seja essa carga uma cadeia de jobs agendados, um fluxo constante de requisições ou um analista trabalhando o dia inteiro, o formato é o mesmo: trabalho contínuo. Este é o teste mais limpo de valor bruto de computação, porque, sem tempo ocioso para recuperar, a elasticidade não tem nada para otimizar.
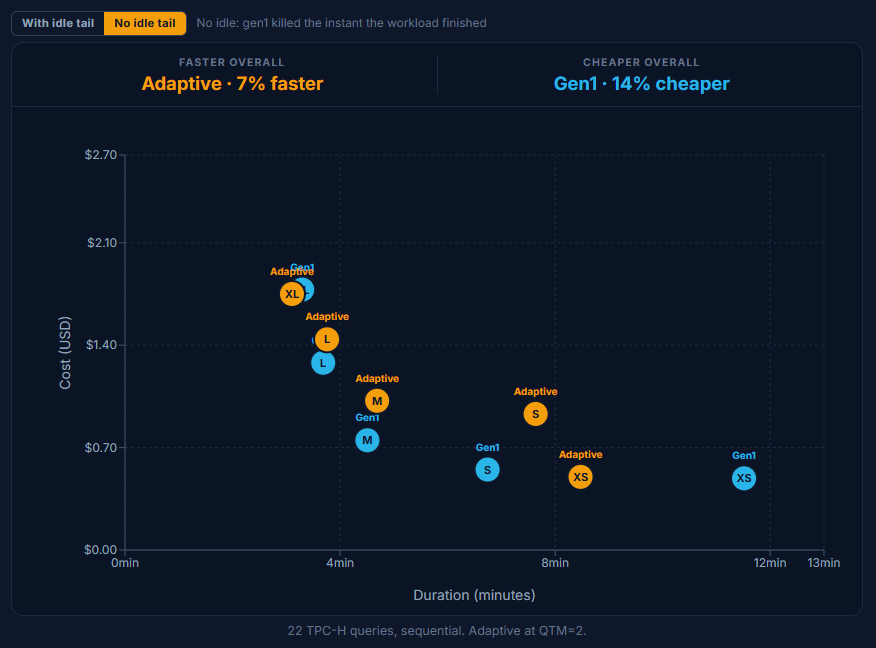
Em velocidade pura, os dois estão mais próximos do que você imagina, e o Gen1 se defende bem. O Adaptive é dramaticamente mais rápido apenas no tamanho XS (cerca de 8,5 minutos vs 11,4); em Small, Medium e Large, o Gen1 na verdade termina um pouco antes, e no XLarge eles empatam em aproximadamente ~3,2 minutos. Em custo, o Gen1 lidera na maior parte da faixa e no agregado.
Gráfico: 22 queries do TPC-H, em sequência. Adaptive com QTM=2.
💡Conclusão
Em um warehouse continuamente ocupado, o Gen1 é o burro de carga: velocidade comparável à do Adaptive na maioria dos tamanhos e mais barato de XSmall a Large. O Adaptive se paga nos extremos — um grande salto de velocidade no menor tamanho e uma economia real de custo apenas no XLarge. Para workloads constantes e saturados no meio da faixa de tamanhos, um warehouse Gen1 fixo vence este cenário.
Concorrência: o Adaptive é mais rápido, o custo depende do tamanho
O objetivo: disparar 22 queries ao mesmo tempo — uma ferramenta de BI, um refresh de dashboard, um time inteiro acessando junto.
O Gen1 absorve um pico de concorrência com scale-out multi-cluster, aqui limitado a quatro clusters e cobrado por cluster ativo. O Adaptive, em vez disso, agrupa as queries em computação compartilhada e faz burst pelo ajuste de QTM: um QTM mais alto compra mais computação paralela — e mais créditos. O ajuste de idle tail só afeta o Gen1: derrubar o warehouse no instante em que o burst termina ("sem idle tail") reduz a fatura em cerca de US$ 0,10 a US$ 0,20 por tamanho; o Adaptive não tem conceito de ociosidade e não é afetado.
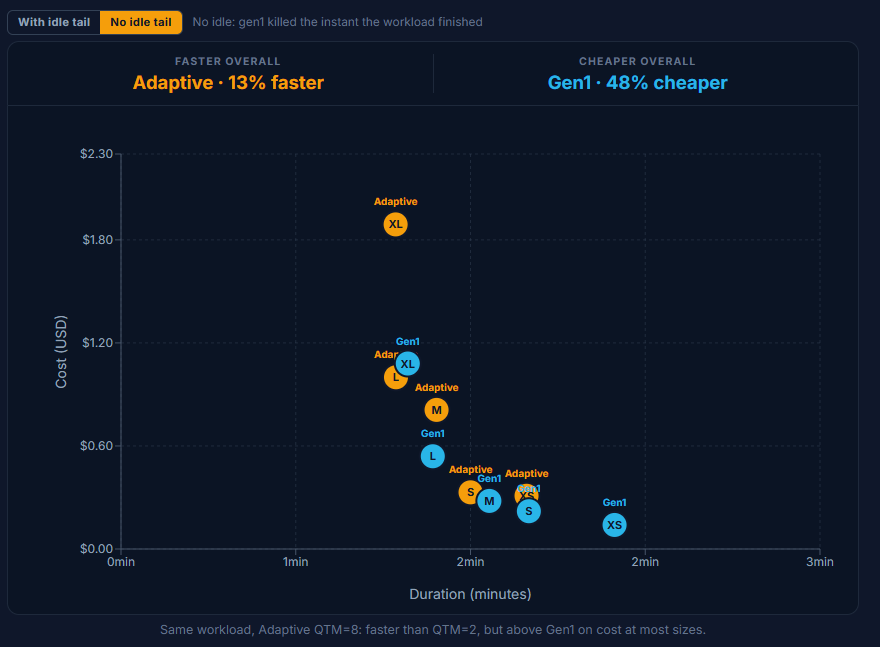
Com QTM=2, o Adaptive resolve o burst mais rápido que o Gen1 em todos os tamanhos. No custo, o resultado é misto: o Adaptive é mais barato na ponta pequena (XSmall US$ 0,17 vs US$ 0,23, Small US$ 0,23 vs US$ 0,34) e de novo no XLarge (US$ 0,83 vs US$ 1,26), enquanto o modelo multi-cluster do Gen1 é o caminho mais barato no meio da faixa (Medium US$ 0,39 vs US$ 0,54, Large US$ 0,69 vs US$ 0,84).
Subir para QTM=8 é ainda mais rápido, mas você paga por isso: fica acima do Gen1 na maioria dos tamanhos (Medium US$ 0,81 vs US$ 0,39, XLarge US$ 1,89 vs US$ 1,26) e só empata no Small. QTM=8 só se justifica quando a latência claramente importa mais que a fatura. (Muito provavelmente a fila foi esvaziada mais rápido e só tivemos que esperar a query mais lenta terminar.)
Gráfico: 22 queries concorrentes, Adaptive QTM=2 vs Gen1 multi-cluster (máx. 4).
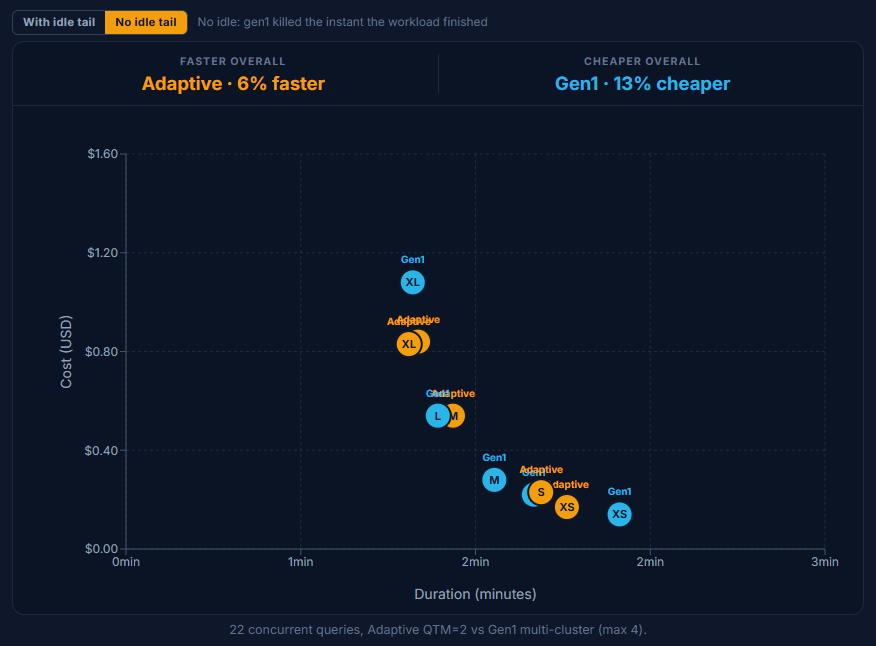
Gráfico: mesmo workload, Adaptive QTM=8, mais rápido que QTM=2, mas acima do Gen1 em custo na maioria dos tamanhos.
💡Conclusão
Em concorrência, o Adaptive é o motor mais rápido em todos os tamanhos. O porém é o ajuste de QTM. Subir de QTM=2 para QTM=8 compra apenas alguns segundos (Medium de 84s para 81s, XLarge de 73s para 71s), enquanto a fatura praticamente dobra (Medium de US$ 0,54 para US$ 0,81, XLarge de US$ 0,83 para US$ 1,89). Definimos um QTM alto demais para este workload: o Snowflake não precisava dessa folga para resolver o burst, mas ainda assim nos cobrou por reservá-la. Só defina um QTM alto quando você realmente precisar.
Refresh via DML: o job de escrita do ETL
O objetivo: um refresh de delete + insert para imitar um job incremental típico.
O job aqui é um refresh incremental realista: deletar um mês de lineitem e reinseri-lo a partir da origem — cerca de 1% das linhas em uma tabela de ~600 milhões de linhas. A tabela-base é grande, mas a mudança não é. O pruning de micropartições do Snowflake mira exatamente nas partições que aquele mês toca e pula o resto, então o mecanismo consegue ver de antemão que se trata de uma escrita pequena e cirúrgica, não de uma reescrita da tabela inteira. Essa é a chave para tudo o que vem a seguir.
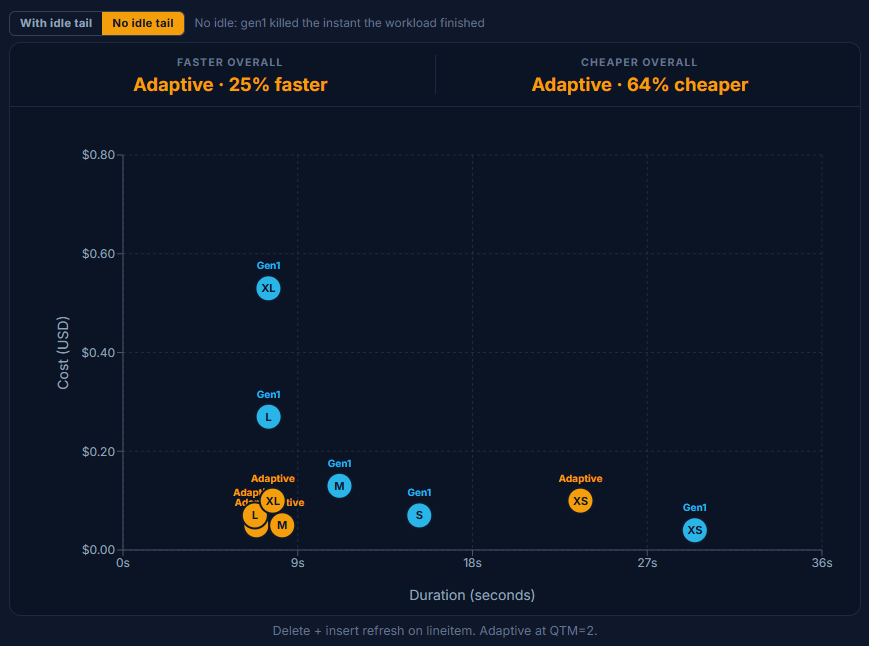
O Gen1 obriga você a se comprometer com um tamanho de antemão e cobra pelo mínimo, quer o pico precisasse daquele tamanho ou não. O delete mais insert termina em segundos do Small para cima, e ainda assim o preço do Gen1 sobe direto na escala: US$ 0,05 no XSmall, US$ 0,08 no Small, US$ 0,15 no Medium, US$ 0,29 no Large, US$ 0,60 no XLarge. Você está pagando pelo warehouse, não pelo trabalho.
O Adaptive conta a história oposta — e este é o capítulo em que ele parece mais inteligente. Repare como Small, Medium, Large e XLarge ficam agrupados: US$ 0,05, US$ 0,05, US$ 0,07, US$ 0,09. Eles até aparecem em ordem certinha de preço, mas no XLarge o medidor mal saiu do nível do Small. Um delete mais insert sofre pruning para uma fatia estreita de partições, e o Snowflake claramente reconhece que pode terminar o trabalho sem jogar computação cara nele; ele se recusa a provisionar demais mesmo quando o teto de tamanho permitiria. A fatura acompanha o trabalho, não o ajuste.
A única exceção é o XSmall, onde o Adaptive (US$ 0,10) fica atrás do Gen1 (US$ 0,05). Sem um warehouse ocioso e superdimensionado para recuperar, o custo adicional por query do Adaptive não tem como se pagar — exatamente o padrão do Capítulo 2.
Gráfico: refresh de delete + insert na lineitem. Adaptive com QTM=2.
💡Conclusão
Este é o Adaptive em sua forma mais inteligente. Ele lê o formato do trabalho — uma escrita de 1% com pruning preciso contra uma tabela enorme — e deliberadamente se mantém pequeno em vez de usar todo o teto de tamanho que você entregou. Mesmo apontado para XLarge, ele gasta como um Small, porque é tudo de que o job precisa; a fatura acompanha os recursos usados, não o ajuste que você definiu. Para pipelines incrementais, esse é exatamente o comportamento desejado, e ele elimina por completo o imposto de "adivinhar o tamanho".
A cobrança do Snowflake está ficando mais complexa, não menos. Se você gerencia workloads de IA e ML em cima dele, a superfície de custos fica difícil de interpretar bem rápido. Montamos um guia prático sobre como controlar de fato os gastos com Cortex, serving de modelos e o restante da stack.
Baixe o Manual Não Oficial de Otimização de Custos de IA para Snowflake
CTAS: uma escrita pesada, limitada por scan
O objetivo: CREATE TABLE AS SELECT em cinco formatos de dados — uma leitura grande alimentando a materialização de uma tabela completa.
Enquanto o refresh via DML era uma escrita cirúrgica de 1%, o CTAS é o oposto: cinco variantes de CREATE TABLE AS SELECT (estreita/alta, padrão/alta, média/larga, muito larga e um formato com filtro) que escaneiam e materializam em massa. Não há warehouse ocioso para recuperar nem atalho de pruning, então o trabalho é computação genuína — o lugar mais limpo para ler o preço bruto por throughput nas três gerações de warehouse lado a lado.
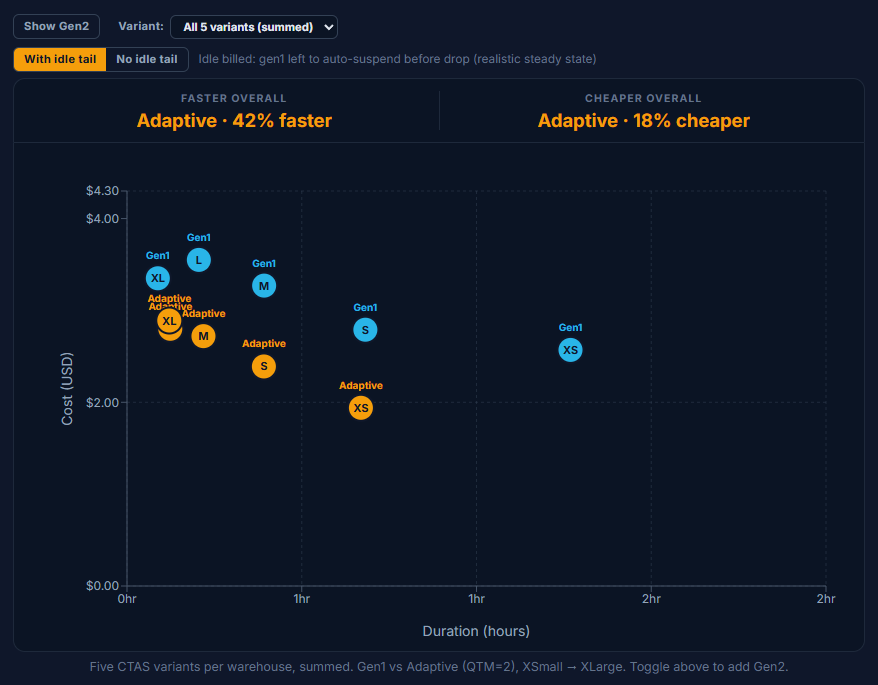
Em custo, o Adaptive é a opção mais barata em todos os tamanhos: US$ 1,94 / US$ 2,39 / US$ 2,72 / US$ 2,80 / US$ 2,89 de XSmall a XLarge, bem abaixo dos US$ 2,57 / US$ 2,79 / US$ 3,27 / US$ 3,55 / US$ 3,35 do Gen1. Em velocidade, o Adaptive também lidera sobre o Gen1 de XSmall a Large — mas a ordem se inverte no XLarge.
Essa inversão no XLarge é culpa de uma única variante. O Adaptive no XLarge fecha em 7,3 minutos, mais lento que os 5,3 minutos do Gen1, porque a variante very_wide para de escalar no Adaptive — cerca de 6 minutos sozinha no XLarge, enquanto as outras quatro variantes terminam em segundos. Use o filtro de variantes acima para removê-la (ou explore uma única variante) e a anomalia desaparece.
💡 Conclusão
O Adaptive é a opção mais barata de XSmall a XLarge e também a mais rápida de XSmall a Large. O porém é o XLarge, onde uma variante (very_wide) quebra o escalonamento do Adaptive e o gráfico fica mais lento que o Gen1. Use o filtro de variantes acima para excluí-la ou explorar um único formato de query, e ative o Gen2 para ver como o novo warehouse padrão se compara.
Frequently asked
questions
Comece a usar em menos de 15 minutos
Conecte sua conta do Snowflake, Databricks ou BigQuery e entenda na hora seu potencial de economia.
O Adaptive não é uma redução de custos automática. Essa é a nossa principal conclusão deste benchmark, e ela vai contra o que muitos clientes com quem conversamos esperavam do recurso antes de começar. Nos nossos cinco formatos de workloads, o Adaptive foi mais barato em alguns cenários, mais caro em outros e praticamente empatado no restante. Não recomendamos que nenhum cliente troque de repente todos os seus warehouses para o Adaptive esperando que a fatura caia — na realidade, ela provavelmente subiria. O Adaptive é otimizado para performance, não para custo. Esse é o fio condutor da maioria dos experimentos que rodamos. Dado um teto de tamanho ou uma configuração de QTM, o Snowflake geralmente vai buscar qualquer teto que você conceder para devolver a resposta mais rápida possível. O Capítulo 1 mostrou isso com o MAX_QUERY_PERFORMANCE_LEVEL: o XLarge custando ~4x em relação ao Small por um ganho de velocidade que mal dava para medir. O Capítulo 3 mostrou com o QTM: ir de QTM=2 para QTM=8 comprou alguns segundos e praticamente dobrou a fatura. A exceção clara é o refresh via DML do Capítulo 4, em que o Adaptive leu o formato de uma escrita de 1% com pruning preciso e deliberadamente se manteve pequeno mesmo apontado para XLarge. Ou seja, o mecanismo consegue se conter — só não faz isso de forma consistente em todos os formatos de workloads. A conclusão não é que o Adaptive é imprudente; é que os ajustes ainda precisam ser calibrados e configurados com cuidado.
Você ainda precisa pensar na configuração do seu warehouse. A promessa do Adaptive era que as decisões de dimensionamento desapareceriam. Na prática, este benchmark mostra que as decisões apenas mudaram de forma: em vez de escolher um tamanho fixo, agora você escolhe um MAX_QUERY_PERFORMANCE_LEVEL (um teto de gasto) e um QTM (um teto de concorrência/burst). Ambos mudam a fatura de forma relevante. Defina-os altos demais "por via das dúvidas" e você pagará por uma folga de que nunca precisou.
Você precisa fazer o benchmark dos seus próprios workloads. Nossos resultados são específicos do TPC-H SF1000 e dos cinco formatos de workloads que rodamos. Suas queries, o layout dos seus dados, o comportamento de pruning, o perfil de concorrência e os padrões de ociosidade produzirão números diferentes. As descobertas direcionais são úteis como hipótese inicial; não substituem testar o Adaptive contra o seu workload real, com os seus dados reais. O repositório do benchmark é reproduzível — faça um fork, troque pelas suas queries e meça antes de migrar qualquer coisa que importe.
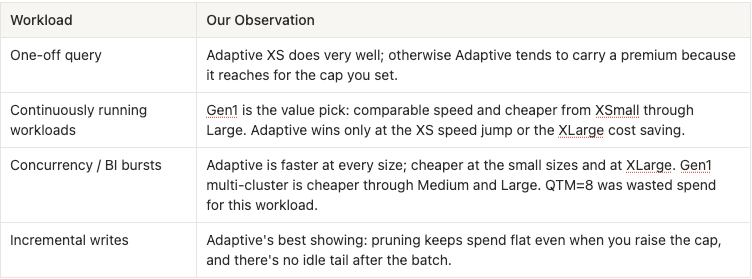
Dito isso, aqui estão as observações que vimos ao fazer o benchmark dos nossos próprios workloads:
Você já fez o benchmark do Adaptive nos seus próprios workloads? Adoraríamos saber o que você viu! Mande uma mensagem — estamos sempre buscando aprimorar nosso entendimento de como ele se comporta no mundo real.