
Play
TLDR
L'Adaptive Warehouse di Snowflake permette di impostare un tetto di performance e un moltiplicatore di concorrenza invece di vincolarsi a una dimensione fissa. Lo abbiamo messo a confronto diretto con Gen1 su quattro dimensioni di warehouse e cinque tipi di workloads su TPC-H SF1000. Adaptive vince sulle query singole e sui refresh DML, dove capisce la natura del lavoro e non fa over-provisioning. Gen1 si difende bene sui workloads sequenziali e sulla concorrenza di fascia media. I parametri restano comunque da impostare: Adaptive cambia ciò che il parametro controlla, non la necessità di pensarci.
Cos'è la nuova funzionalità Adaptive Warehouse di Snowflake?
Il nuovo Adaptive Warehouse di Snowflake promette di eliminare il problema del dimensionamento. Invece di scegliere una dimensione fissa, uno scale factor, QAS e di armeggiare con Suspend e Resume, pagando capacità che le query più piccole non sfrutteranno mai appieno, Snowflake raggruppa e scala automaticamente il compute dietro le quinte e addebita solo ciò che ogni query consuma effettivamente. La domanda ovvia è se questo faccia davvero risparmiare, e dove. Per scoprirlo lo abbiamo messo a confronto diretto con il classico warehouse Gen1 su TPC-H SF100 (tabella lineitem da ~600 milioni di righe), su quattro dimensioni (Small → XLarge) e cinque tipologie di workloads.
Le impostazioni di Adaptive
Adaptive ha due parametri: MAX_QUERY_PERFORMANCE_LEVEL (il suo tetto di dimensione) e QTM, il query-throughput multiplier, un parametro di concorrenza/burst. Vediamoli in dettaglio: sono ciò che ogni grafico di questo benchmark misura in concreto.
MAX_QUERY_PERFORMANCE_LEVEL
Il tetto di performance per qualsiasi singola query, espresso come taglia da XSMALL a X4LARGE (default: XLARGE). Snowflake lo usa come limite superiore, non come allocazione fissa: il motore sceglie le risorse che ritiene necessarie per la query e limita questa scelta a tale livello. Per le query piccole può usarne molte di meno; per quelle grandi non andrà oltre. Impostarlo basso fa risparmiare ma può rallentare le query più pesanti; impostarlo alto sblocca le performance complete ma significa che una singola query pesante può spendere di conseguenza. Importante: questo valore non corrisponde a una specifica configurazione di compute sottostante; è Snowflake a determinare le risorse effettivamente necessarie per ogni query. In concreto, non possiamo dire "questa query ha girato davvero su uno Small ed è stata fatturata alle tariffe di credito di uno Small". NON è un tetto di fatturazione, è un tetto di performance.
QUERY_THROUGHPUT_MULTIPLIER (QTM)
Un fattore di scala intero (default: 2) che stabilisce quanta capacità di burst il warehouse può usare in ogni istante. Snowflake calcola una capacità base interna a partire dal MAX_QUERY_PERFORMANCE_LEVEL impostato, poi la moltiplica per il QTM per ottenere il tetto di concorrenza. Impostare QTM=N significa che il warehouse può eseguire circa N query simultaneamente al livello di performance massimo; dato che la maggior parte delle query usa meno del massimo, in pratica si ottiene spesso un throughput maggiore. Impostare QTM=0 significa burst illimitato. Il compromesso: un QTM più alto riduce le code ma alza il tetto della spesa istantanea; un QTM più basso limita i costi ma rischia di far accumulare le query.
Come viene fatturato l'Adaptive Warehouse
Adaptive usa un modello di fatturazione basato sulle query: invece di addebitare al secondo una prenotazione fissa di warehouse, Snowflake addebita in base alle risorse di compute e software che ogni query consuma effettivamente. Creare il warehouse non costa nulla; il contatore parte alla prima query. L'utilizzo viene aggregato a livello di warehouse e riportato in crediti standard di virtual warehouse sotto COMPUTE, quindi le strutture esistenti di chargeback e showback continuano a funzionare.
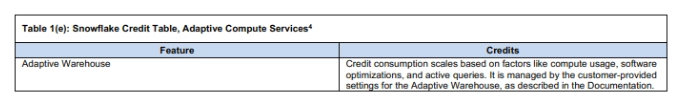
La fatturazione è, francamente, piuttosto opaca. Snowflake descrive il costo come dipendente da "fattori come la quantità di risorse di compute e software" usate da una query, ma non fornisce una formula per sommare le varie componenti. Il dettaglio dei costi per singola query è previsto per la GA, ma non è disponibile in Public Preview. Non c'è modo di verificare quali risorse Snowflake abbia effettivamente allocato a una query specifica, né di controllare perché sia costata quanto è costata. Questo richiede di riporre una buona dose di fiducia in Snowflake, confidando che allochi in modo equo e addebiti di conseguenza. Si impostano i due parametri, si esegue il workload e si legge la fattura aggregata. Per molti team questo compromesso è probabilmente ragionevole, ma vale la pena esserne consapevoli.
Ecco uno screenshot di come Snowflake ha formulato esattamente il pricing:
Monitorare la spesa dell'Adaptive Warehouse
Tre viste ACCOUNT_USAGE sono rilevanti per gli adaptive warehouse. WAREHOUSE_METERING_HISTORY è quella principale per il consumo di crediti a livello di warehouse. QUERY_HISTORY permette di vedere performance e tempi delle singole query, anche se i costi in crediti per query non sono esposti durante la Public Preview. WAREHOUSE_LOAD_HISTORY informa sulle code, il segnale per capire se regolare il QTM. Una cosa da notare: per gli adaptive warehouse l'utilizzo di QAS è incluso nei crediti di compute e non compare come colonna separata, a differenza dei warehouse standard.
Consumo di crediti per adaptive warehouse negli ultimi 30 giorni:
WITH adaptive_whs AS (
  SELECT DISTINCT warehouse_name
  FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
  WHERE warehouse_size = 'ADAPTIVE'
    AND start_time >= DATEADD(day, -30, CURRENT_DATE())
)
SELECT
  m.warehouse_name,
  SUM(m.credits_used)         AS total_credits,
  SUM(m.credits_used_compute) AS compute_credits,
  MIN(m.start_time)           AS first_activity,
  MAX(m.end_time)             AS last_activity
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m
JOIN adaptive_whs a ON a.warehouse_name = m.warehouse_name
WHERE m.start_time >= DATEADD(day, -30, CURRENT_DATE())
Espandi il codice
Performance e tempi delle query da QUERY_HISTORY. È quanto di più vicino alla visibilità dei costi per query sia disponibile oggi; l'attribuzione effettiva dei crediti per singola query non è esposta in Public Preview:
SELECT
  query_id,
  warehouse_name,
  query_type,
  total_elapsed_time / 1000  AS elapsed_sec,
  execution_time / 1000      AS exec_sec,
  queued_overload_time / 1000 AS queued_sec,
  partitions_scanned,
  bytes_scanned,
  start_time
FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
WHERE warehouse_size = 'ADAPTIVE'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY total_elapsed_time DESC
LIMIT 200;
Comportamento delle code da WAREHOUSE_LOAD_HISTORY. Se avg_queued_load è costantemente sopra lo zero, il QTM è troppo basso per il workload:
SELECT
  start_time,
  warehouse_name,
  avg_running,
  avg_queued_load,
  avg_queued_provisioning,
  avg_blocked
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_LOAD_HISTORY
WHERE warehouse_name = '<your_adaptive_warehouse>'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY start_time;
Il setup del benchmark
Il benchmark gira su TPC-H a Scale Factor 1000 (SF1000), che porta la tabella lineitem a circa 600 milioni di righe. SF1000 è abbastanza grande da far contare davvero la dimensione del warehouse per le query ad alta intensità di scansione, ma abbastanza piccolo da mantenere ragionevoli i costi per esecuzione su molte configurazioni.
Tutte le query sono versioni adattate del set standard TPC-H, scritte per la sintassi Snowflake. Il set completo di query è consultabile qui: adapted_queries. Ogni warehouse è stato eseguito su un'istanza creata da zero, così la fatturazione di Snowflake non ha mai spalmato crediti tra le varie configurazioni. Abbiamo testato da XSmall a XLarge sia per Gen1 sia per Adaptive. Proprio così: abbiamo testato XS su 600 milioni di righe, e sorprende quanto quel warehouse se la cavi bene, persino negli step ETL.
Abbiamo testato queste cinque tipologie di workload:
- Una singola query, per capire qual è la spesa minima su ciascun tipo di warehouse.
- Un'esecuzione sequenziale di 66 query, con le 22 query ripetute 3 volte, per misurare un workload costante che dura più di un minuto.
- Tutte le 22 query lanciate in contemporanea per testare il throughput.
- Refresh DML.
- CTAS, con diverse forme di dati.
Ultima nota prima di entrare nel vivo: è possibile riprodurre facilmente questo benchmark clonando il repo e seguendo il readme. È riproducibile al 100%.
Il modo più economico per rispondere a una singola query
L'obiettivo: eseguire una query che termini in meno di un minuto, con la spesa minima possibile.
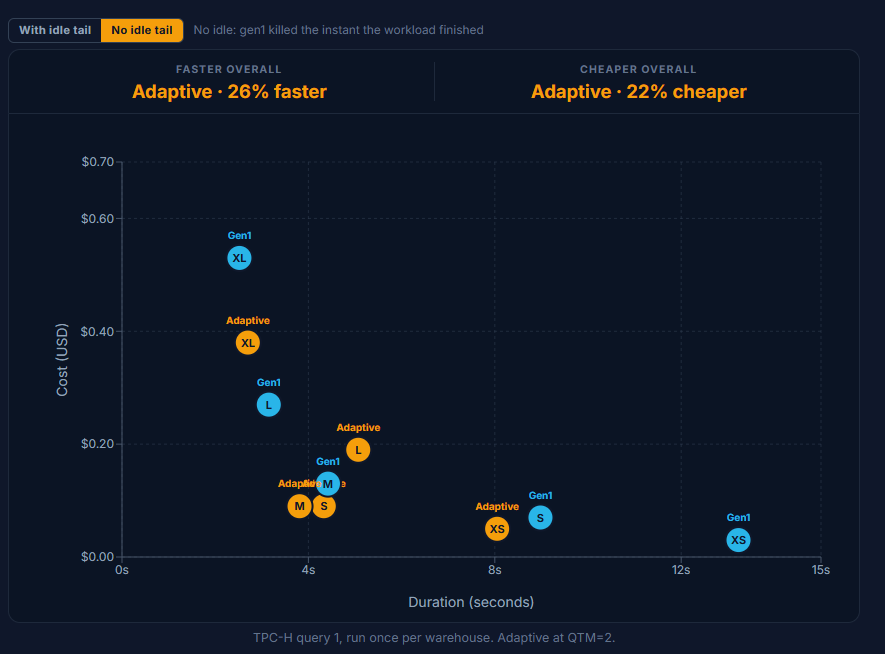
Ogni taglia risponde alla query 1 ben sotto il minuto; la più lenta qui è Gen1 Small con 8 secondi, la più veloce ~2,5 s. Il vincolo non è la latenza, ma la spesa. La domanda diventa quindi: quanto poco si può pagare per una risposta che si otterrebbe comunque?
Su Gen1 il parametro della taglia si comporta esattamente come ci si aspetterebbe. Salendo di una taglia il tempo di query si dimezza circa, mentre il prezzo raddoppia circa: Small in 9,5 s per $0,07, Medium in 4,3 s per $0,14, Large in 3,1 s per $0,28. Con XLarge siamo ai puri rendimenti decrescenti: $0,55 per 3,4 s, non più veloce di Large al doppio del prezzo.
Su Adaptive il quadro è più interessante. Small, Medium e Large restano relativamente vicini, poi XLarge si stacca come outlier: costa circa 4 volte Small e Medium ($0,38 contro $0,09) finendo solo circa un secondo prima di Medium (2,7 s contro 3,8 s). Si paga un premio notevole per un'accelerazione a malapena misurabile.
Grafico: query 1 di TPC-H, eseguita una volta per warehouse. Adaptive con QTM=2.
💡Takeaway
Se si lascia che Snowflake attinga alle risorse più grandi, lo farà volentieri, anche quando risorse più piccole avrebbero prodotto la risposta a un costo inferiore. Il tetto di dimensione non sembra, da solo, spingere il lavoro su compute più piccolo: se lo si imposta alto, si paga tanto. Fatta questa precisazione, nel complesso Adaptive vince comunque su questa singola query: in media più veloce e più economico di Gen1.
Un warehouse tenuto costantemente occupato
L'obiettivo: simulare un workload costante e senza pause che tiene un warehouse completamente saturo.
Sessantasei query eseguite in sequenza senza interruzioni, così il warehouse non resta mai inattivo. Che il carico sia una catena di job schedulati, un flusso costante di richieste o un analista al lavoro tutto il giorno, la forma è la stessa: lavoro continuo. È il test più pulito del valore puro del compute, perché senza tempo di inattività da recuperare l'elasticità non ha nulla da ottimizzare.
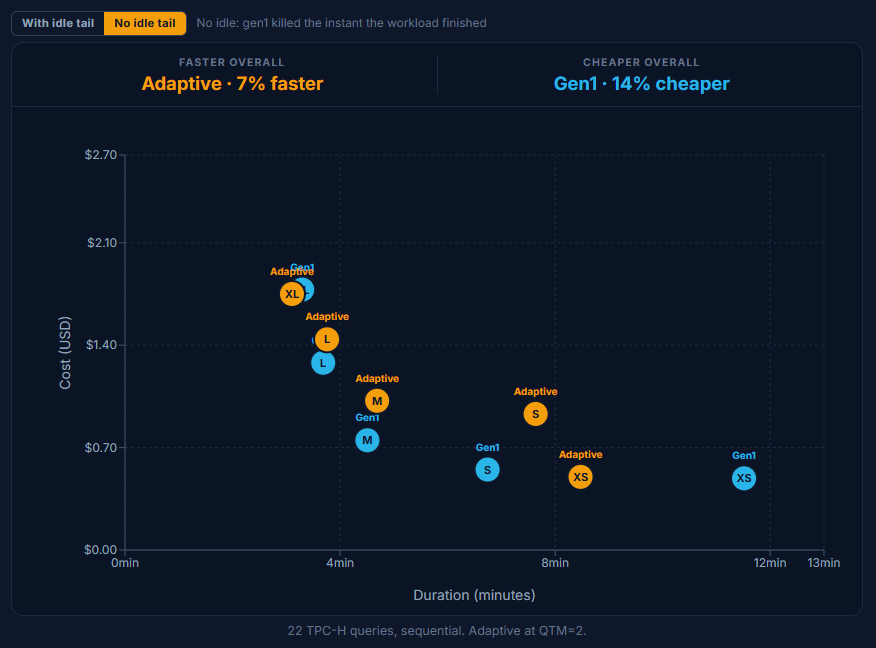
Sulla velocità pura i due sono più vicini di quanto ci si aspetterebbe, e Gen1 si difende bene. Adaptive è nettamente più veloce solo nella taglia XS (circa 8,5 minuti contro 11,4); su Small, Medium e Large Gen1 finisce in realtà un filo prima, e su XLarge pareggiano a circa ~3,2 minuti. Sul costo Gen1 è in testa su quasi tutta la gamma e nell'aggregato.
Grafico: 22 query TPC-H, in sequenza. Adaptive con QTM=2.
💡Takeaway
Su un warehouse costantemente occupato, Gen1 è una macchina instancabile: velocità paragonabile ad Adaptive sulla maggior parte delle taglie, e più economico da XSmall a Large. Adaptive dà il meglio agli estremi: un grande salto di velocità sulla taglia più piccola e un risparmio reale solo su XLarge. Per workloads costanti e saturi nella fascia media delle dimensioni, un warehouse Gen1 fisso vince questo scenario.
Concorrenza: Adaptive è più veloce, il costo dipende dalla taglia
L'obiettivo: lanciare 22 query simultaneamente: uno strumento di BI, il refresh di una dashboard, un intero team che interroga il warehouse tutto insieme.
Gen1 assorbe un picco di concorrenza con lo scale-out multi-cluster, qui limitato a quattro cluster e fatturato per cluster attivo. Adaptive invece raggruppa le query in compute condiviso ed effettua burst tramite il parametro QTM: un QTM più alto significa più compute in parallelo, e più crediti. Il toggle dell'idle tail incide solo su Gen1: spegnere il warehouse nell'istante in cui il burst termina ("no idle tail") riduce la sua fattura di circa $0,10–$0,20 per taglia; Adaptive non ha un concetto di inattività e non ne è influenzato.
Con QTM=2 Adaptive smaltisce il burst più velocemente di Gen1 su ogni taglia. Sul costo il quadro è misto: Adaptive è più economico nella fascia bassa (XSmall $0,17 contro $0,23, Small $0,23 contro $0,34) e di nuovo su XLarge ($0,83 contro $1,26), mentre il modello multi-cluster di Gen1 è la via più economica nella fascia media (Medium $0,39 contro $0,54, Large $0,69 contro $0,84).
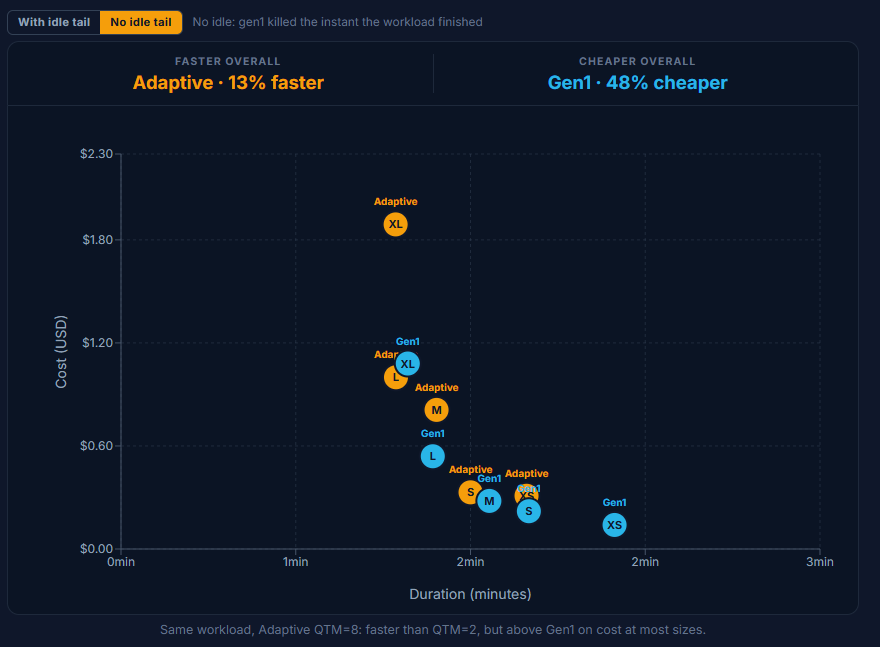
Spingersi a QTM=8 è ancora più veloce, ma si paga: supera Gen1 sulla maggior parte delle taglie (Medium $0,81 contro $0,39, XLarge $1,89 contro $1,26) e pareggia solo su Small. QTM=8 ha senso solo quando la latenza conta chiaramente più della fattura. (Molto probabilmente la coda è stata smaltita più in fretta e abbiamo solo dovuto aspettare che la query più lenta finisse.)
Grafico: 22 query concorrenti, Adaptive QTM=2 vs Gen1 multi-cluster (max 4).
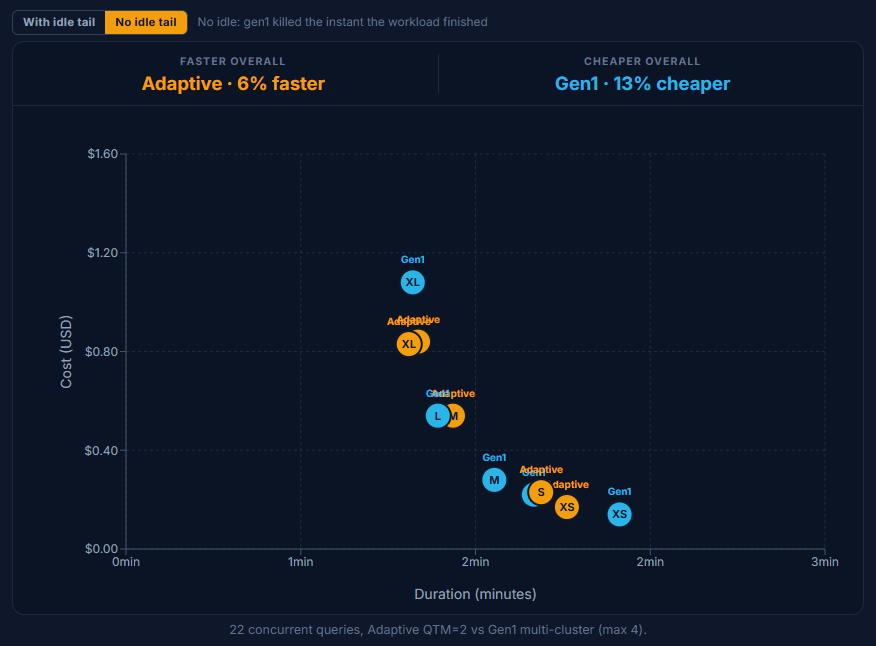
Grafico: stesso workload, Adaptive QTM=8, più veloce di QTM=2 ma sopra Gen1 come costo sulla maggior parte delle taglie.
💡Takeaway
Per la concorrenza, Adaptive è il motore più veloce su ogni taglia. Il problema è il parametro QTM. Passare da QTM=2 a QTM=8 fa guadagnare solo pochi secondi (Medium da 84 s a 81 s, XLarge da 73 s a 71 s) mentre la fattura raddoppia circa (Medium da $0,54 a $0,81, XLarge da $0,83 a $1,89). Abbiamo impostato un QTM troppo alto per questo workload: a Snowflake quel margine non serviva per smaltire il burst, ma ce lo ha comunque addebitato per averlo riservato. Un QTM alto va impostato solo quando serve davvero.
Un refresh DML: il job di scrittura ETL
L'obiettivo: un refresh delete + insert per simulare un tipico job incrementale.
Il job qui è un refresh incrementale realistico: eliminare un mese di lineitem e reinserirlo dalla sorgente, circa l'1% delle righe di una tabella da ~600 milioni di righe. La tabella di base è grande, ma la modifica no. Il pruning delle micro-partizioni di Snowflake colpisce esattamente le partizioni toccate da quel mese e salta il resto, quindi il motore può vedere fin da subito che si tratta di una scrittura piccola e chirurgica, non di una riscrittura dell'intera tabella. Questa è la chiave di tutto ciò che segue.
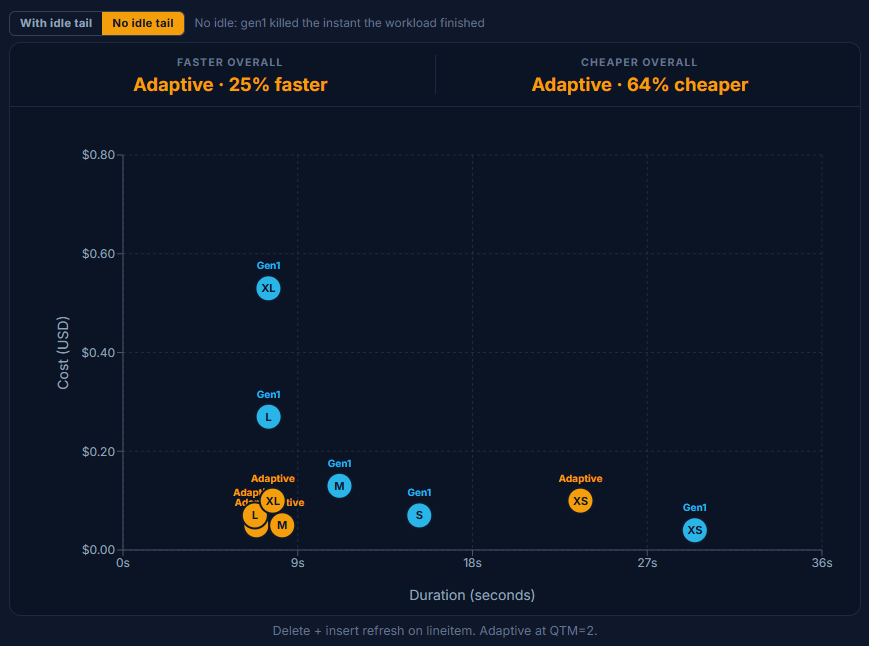
Gen1 obbliga a scegliere una taglia in anticipo e la fattura comunque come minimo, che il burst ne avesse bisogno o meno. Il delete più insert termina in pochi secondi da Small in su, eppure il prezzo di Gen1 sale dritto lungo la scala: $0,05 su XSmall, $0,08 su Small, $0,15 su Medium, $0,29 su Large, $0,60 su XLarge. Si paga il warehouse, non il lavoro.
Con Adaptive la storia è opposta, ed è il capitolo in cui appare più intelligente. Si noti quanto Small, Medium, Large e XLarge siano ravvicinati: $0,05, $0,05, $0,07, $0,09. I prezzi seguono persino un ordine regolare, eppure su XLarge il contatore si è appena mosso rispetto a Small. Un delete più insert si riduce via pruning a una fetta ristretta di partizioni, e Snowflake riconosce chiaramente di poter completare il job senza ricorrere a compute costoso; rifiuta l'over-provisioning anche quando il tetto di dimensione glielo consentirebbe. La fattura segue il lavoro, non il parametro.
L'unica eccezione è XSmall, dove Adaptive ($0,10) resta dietro a Gen1 ($0,05). Senza un warehouse sovradimensionato e inattivo da recuperare, il sovrapprezzo per query di Adaptive non ha nulla da compensare: esattamente lo schema del Capitolo 2.
Grafico: refresh delete + insert su lineitem. Adaptive con QTM=2.
💡Takeaway
Questo è Adaptive al massimo della sua intelligenza. Legge la natura del lavoro — una scrittura dell'1% strettamente delimitata dal pruning su una tabella enorme — e resta deliberatamente piccolo invece di sfruttare fino in fondo il tetto di dimensione che gli è stato concesso. Anche puntandolo su XLarge, spende come uno Small perché è tutto ciò che il job richiede: la fattura segue le risorse usate, non il parametro impostato. Per le pipeline incrementali è esattamente il comportamento desiderato, ed elimina del tutto la "tassa" del dover indovinare la taglia.
La fatturazione di Snowflake sta diventando più complessa, non meno. Per chi ci gestisce sopra workloads di AI e ML, il quadro dei costi diventa rapidamente più difficile da leggere. Abbiamo preparato una guida pratica su come controllare davvero la spesa tra Cortex, model serving e il resto dello stack.
Scarica l'Unofficial AI Cost Optimization Manual per Snowflake
CTAS: una scrittura pesante e scan-bound
L'obiettivo: CREATE TABLE AS SELECT su cinque forme di dati: una lettura massiccia che alimenta la materializzazione completa di una tabella.
Dove il refresh DML era una scrittura chirurgica dell'1%, il CTAS è l'opposto: cinque varianti di CREATE TABLE AS SELECT (narrow/tall, standard/tall, medium/wide, very wide e una forma filtrata) che scansionano e materializzano in blocco. Non c'è warehouse inattivo da recuperare né scorciatoie di pruning, quindi il lavoro è compute genuino — lo scenario più pulito per misurare il puro rapporto prezzo/throughput delle tre generazioni di warehouse affiancate.
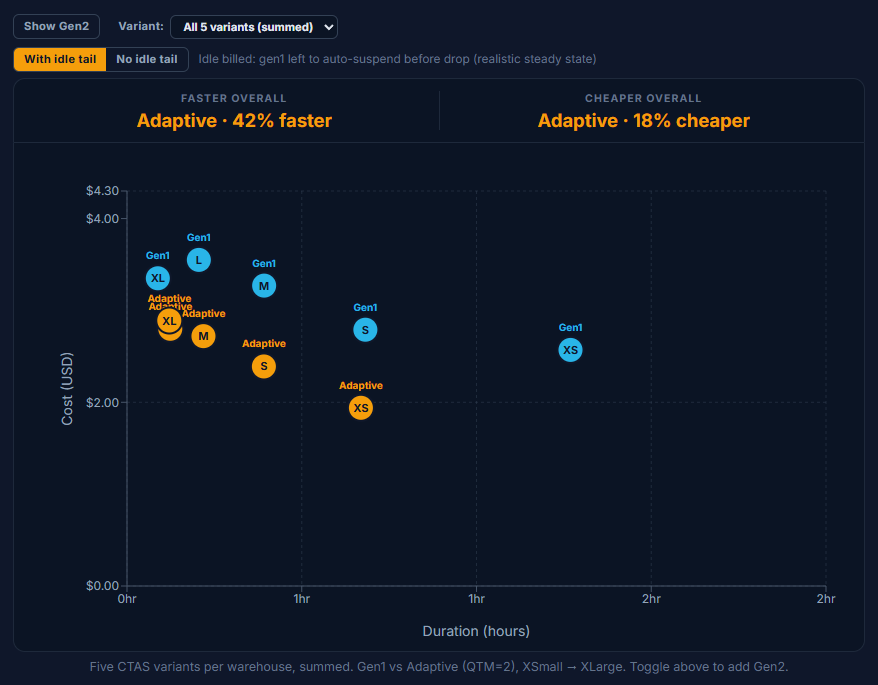
Sul costo, Adaptive è il più economico su ogni taglia: $1,94 / $2,39 / $2,72 / $2,80 / $2,89 da XSmall a XLarge, ben al di sotto dei $2,57 / $2,79 / $3,27 / $3,55 / $3,35 di Gen1. Sulla velocità Adaptive è in vantaggio su Gen1 da XSmall a Large — ma l'ordine si inverte su XLarge.
L'inversione su XLarge è colpa di una sola variante. Adaptive su XLarge si ferma a 7,3 minuti, più lento dei 5,3 minuti di Gen1, perché la variante very_wide smette di scalare su Adaptive — circa 6 minuti da sola su XLarge, mentre le altre quattro varianti finiscono in pochi secondi. Usando il filtro delle varianti qui sopra per escluderla (o analizzando una singola variante), l'anomalia scompare.
💡 Takeaway
Adaptive è il più economico da XSmall a XLarge, e anche il più veloce da XSmall a Large. Il punto debole è XLarge, dove una variante (very_wide) rompe lo scaling di Adaptive e il grafico lo mostra più lento di Gen1. Usando il filtro delle varianti qui sopra è possibile escluderla o analizzare una singola forma di query, e attivando Gen2 si può vedere come si posiziona il warehouse standard più recente.
Frequently asked
questions
Operativi in meno di 15 minuti
Colleghi il Suo account Snowflake, Databricks o BigQuery e scopra subito il Suo potenziale di risparmio.
Adaptive non è una riduzione dei costi pronta all'uso. È la conclusione più importante di questo benchmark, e va contro ciò che molti clienti con cui abbiamo parlato si aspettavano da questa funzionalità prima di iniziare. Nelle nostre cinque forme di workload, Adaptive è risultato più economico in alcuni scenari, più costoso in altri e circa alla pari nei restanti. Non consigliamo ad alcun cliente di passare improvvisamente tutti i propri warehouse ad Adaptive aspettandosi una fattura più bassa — in realtà, probabilmente salirebbe. Adaptive è ottimizzato per le performance, non per i costi. È il filo conduttore della maggior parte degli esperimenti che abbiamo eseguito. Dato un tetto di dimensione o un'impostazione di QTM, Snowflake tende a sfruttare tutto il margine concesso per restituire la risposta più veloce possibile. Il Capitolo 1 lo ha mostrato con MAX_QUERY_PERFORMANCE_LEVEL: XLarge costa ~4 volte l'impostazione Small per un'accelerazione a malapena misurabile. Il Capitolo 3 lo ha mostrato con il QTM: passare da QTM=2 a QTM=8 ha fatto guadagnare pochi secondi e raddoppiato circa la fattura. La chiara eccezione è il refresh DML del Capitolo 4, dove Adaptive ha letto la natura di una scrittura dell'1% strettamente delimitata dal pruning ed è rimasto deliberatamente piccolo anche quando puntato su XLarge. Quindi il motore sa trattenersi, solo non lo fa in modo coerente tra le diverse forme di workload. La conclusione non è che Adaptive sia sconsiderato; è che i parametri vanno comunque regolati e configurati con attenzione.
Bisogna comunque pensare alla configurazione del proprio warehouse. La promessa di Adaptive era che le decisioni di dimensionamento sarebbero sparite. In pratica questo benchmark mostra che le decisioni hanno solo cambiato forma: invece di scegliere una dimensione fissa, ora si scelgono un MAX_QUERY_PERFORMANCE_LEVEL (un tetto di spesa) e un QTM (un tetto di concorrenza/burst). Entrambi incidono materialmente sulla fattura. Impostandoli troppo alti "per sicurezza", si finisce per pagare un margine di cui non c'era bisogno.
È indispensabile fare benchmark dei propri workloads. I nostri risultati sono specifici di TPC-H SF1000 e delle cinque forme di workload che abbiamo eseguito. Query, layout dei dati, comportamento di pruning, profilo di concorrenza e pattern di inattività diversi produrranno numeri diversi. Le tendenze emerse sono utili come ipotesi di partenza, ma non sostituiscono un test di Adaptive sul workload reale con i dati reali. Il repo del benchmark è riproducibile — basta farne un fork, sostituire le query con le proprie e misurare prima di migrare qualsiasi cosa di importante.
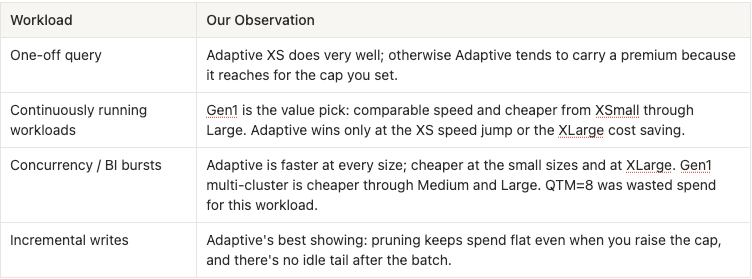
Detto questo, ecco le osservazioni emerse facendo benchmark dei nostri workloads:
Ha già fatto benchmark di Adaptive sui Suoi workloads? Ci piacerebbe sapere cosa ha osservato! Ci scriva due righe: cerchiamo sempre di affinare la nostra comprensione di come si comporta sul campo.