
再生
TLDR
SnowflakeのAdaptive Warehouseでは、固定サイズを選ぶ代わりに、パフォーマンスの上限と同時実行の倍率を設定します。TPC-H SF1000を使い、4つのウェアハウスサイズと5種類のワークロードでGen1と直接比較しました。単一クエリとDMLリフレッシュではAdaptiveが優勢で、処理の性質を読み取って過剰なプロビジョニングを避けます。一方、逐次実行のワークロードや中規模の同時実行ではGen1が健闘します。設定を決めるのは、依然として利用者自身です。Adaptiveが変えたのはダイヤルが制御する対象であって、考える手間がなくなるわけではありません。
Snowflakeの新機能「Adaptive Warehouse」とは?
Snowflakeの新しいAdaptive Warehouseは、サイジングの手間をなくすことを謳っています。固定サイズ、スケールファクター、QASを選び、SuspendとResumeを細かく調整し、小さなクエリでは使い切れない容量に料金を払う——そんな運用の代わりに、Snowflakeが裏側でコンピュートを自動的にプールしてスケールし、各クエリが実際に消費した分だけを課金します。当然の疑問は、それで本当にコストが下がるのか、どこで下がるのかということです。それを確かめるため、TPC-H SF100(lineitem約6億行)で、4サイズ(Small → XLarge)と5種類のワークロードにわたり、従来型のGen1ウェアハウスと直接比較しました。
Adaptiveの設定項目
Adaptiveには2つのダイヤルがあります。MAX_QUERY_PERFORMANCE_LEVEL(サイズの上限)と、同時実行/バーストを制御するクエリスループット倍率のQTMです。本ベンチマークのすべてのチャートが実際に測定しているのはこの2つですので、詳しく見ていきましょう。
MAX_QUERY_PERFORMANCE_LEVEL
単一クエリに適用されるパフォーマンスの上限で、XSMALLからX4LARGEまでのTシャツサイズで指定します(デフォルト: XLARGE)。Snowflakeはこれを固定割り当てではなく上限として扱います。エンジンはクエリに必要と判断したリソースを選択し、その選択をこのレベルで頭打ちにします。小さなクエリでははるかに少ないリソースしか使わないこともあり、大きなクエリでもこれを超えることはありません。低く設定すればコストは下がりますが、最も重いクエリが遅くなる可能性があります。高く設定すればフルパフォーマンスが得られますが、重いクエリ1本が相応のコストを消費し得ます。重要なのは、これは特定の基盤コンピュート構成に対応していないという点です。各クエリに実際に必要なリソースはSnowflakeが決定します。つまり「このクエリは実質Smallで実行され、Smallのクレジット単価で課金された」とは言えません。これは課金の上限ではなく、パフォーマンスの上限なのです。
QUERY_THROUGHPUT_MULTIPLIER(QTM)
ウェアハウスが任意の瞬間に使用できるバースト容量を決める整数のスケールファクター(デフォルト: 2)です。SnowflakeはMAX_QUERY_PERFORMANCE_LEVELから内部的な基準容量を算出し、それにQTMを掛けて同時実行の上限を決めます。QTM=Nに設定すると、ウェアハウスはフルパフォーマンスレベルでおおよそN本のクエリを同時に実行できますが、ほとんどのクエリは上限より少ないリソースしか使わないため、実際にはそれ以上のスループットが得られることも多くあります。QTM=0は無制限バーストを意味します。トレードオフとして、QTMを高くするとキューイングは減りますが瞬間的な支出の上限が上がり、低くするとコストは抑えられますがクエリが滞留するリスクがあります。
Adaptive Warehouseの課金体系
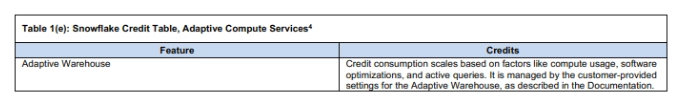
Adaptiveはクエリベースの課金モデルを採用しています。固定のウェアハウス予約に対して秒単位で課金するのではなく、各クエリが実際に消費したコンピュートとソフトウェアリソースに基づいて課金されます。ウェアハウスの作成自体は無料で、最初のクエリからメーターが回り始めます。使用量はウェアハウス単位で集計され、COMPUTE配下の標準的な仮想ウェアハウスクレジットとして報告されるため、既存のチャージバック/ショーバックの仕組みはそのまま機能します。
率直に言って、この課金はかなり不透明です。Snowflakeはコストについて、クエリが使用する「コンピュートとソフトウェアリソースの量などの要因」に依存すると説明していますが、各要素をどう合算するのかの計算式は提供していません。クエリごとのコスト内訳はGAで提供予定ですが、Public Previewでは利用できません。特定のクエリにSnowflakeが実際にどのリソースを割り当てたのかを検証する手段も、なぜその金額になったのかを監査する手段もありません。つまり、Snowflakeが公平に割り当てて適切に課金してくれると、相当程度信頼する必要があります。2つのダイヤルを設定し、ワークロードを実行し、集計された請求額を確認する——それだけです。多くのチームにとってこのトレードオフは妥当なものかもしれませんが、その点を理解したうえで臨む価値はあります。
Snowflakeが料金について実際にどのように記載しているかのスクリーンショットがこちらです:
Adaptive Warehouseのコスト監視
Adaptive Warehouseに関連するACCOUNT_USAGEビューは3つあります。ウェアハウスレベルのクレジット消費を見る主要なビューがWAREHOUSE_METERING_HISTORYです。QUERY_HISTORYでは個々のクエリのパフォーマンスと実行時間を確認できますが、Public Previewではクエリ単位のクレジットコストは分離されていません。WAREHOUSE_LOAD_HISTORYはキューイングの状況を示し、QTMを調整すべきかどうかのシグナルになります。1点注意として、Adaptive WarehouseではQAS使用量がコンピュートクレジットに含まれ、標準ウェアハウスと異なり別カラムとしては表示されません。
過去30日間のAdaptive Warehouseごとのクレジット消費:
WITH adaptive_whs AS (
  SELECT DISTINCT warehouse_name
  FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
  WHERE warehouse_size = 'ADAPTIVE'
    AND start_time >= DATEADD(day, -30, CURRENT_DATE())
)
SELECT
  m.warehouse_name,
  SUM(m.credits_used)         AS total_credits,
  SUM(m.credits_used_compute) AS compute_credits,
  MIN(m.start_time)           AS first_activity,
  MAX(m.end_time)             AS last_activity
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m
JOIN adaptive_whs a ON a.warehouse_name = m.warehouse_name
WHERE m.start_time >= DATEADD(day, -30, CURRENT_DATE())
コードを展開
QUERY_HISTORYによるクエリのパフォーマンスと実行時間。現時点でクエリ単位のコスト可視化に最も近いものですが、クエリごとの実際のクレジット配分はPublic Previewでは公開されていません:
SELECT
  query_id,
  warehouse_name,
  query_type,
  total_elapsed_time / 1000  AS elapsed_sec,
  execution_time / 1000      AS exec_sec,
  queued_overload_time / 1000 AS queued_sec,
  partitions_scanned,
  bytes_scanned,
  start_time
FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
WHERE warehouse_size = 'ADAPTIVE'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY total_elapsed_time DESC
LIMIT 200;
WAREHOUSE_LOAD_HISTORYによるキューイングの挙動。avg_queued_loadが継続的にゼロを上回っている場合、そのワークロードに対してQTMが低すぎます:
SELECT
  start_time,
  warehouse_name,
  avg_running,
  avg_queued_load,
  avg_queued_provisioning,
  avg_blocked
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_LOAD_HISTORY
WHERE warehouse_name = '<your_adaptive_warehouse>'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY start_time;
ベンチマークの構成
ベンチマークはTPC-HのScale Factor 1000(SF1000)で実行しており、lineitemテーブルは約6億行になります。SF1000は、スキャン中心のクエリでウェアハウスサイズが本当に意味を持つ程度に大きく、かつ多数の構成にわたって実行コストを現実的な範囲に収められる程度に小さい規模です。
すべてのクエリは、標準のTPC-HセットをSnowflakeの構文に合わせて書き直したものです。クエリセット全体はこちらで確認できます: adapted_queries。各ウェアハウスは新規作成したインスタンスで実行し、Snowflakeの課金が構成間でクレジットを混在させないようにしました。Gen1とAdaptiveの両方でXSmallからXLargeまでをテストしています。そうです、6億行に対してXSをテストしました。このウェアハウスがETLステップでさえどれほど健闘するか、きっと驚くはずです。
テストした5種類のワークロードは次のとおりです:
- 各ウェアハウスタイプで最小限いくらで済むのかを確認するための単一クエリ。
- 22クエリを3回、計66クエリの逐次実行。1分以上続く定常的なワークロードを測定。
- 22クエリすべてを同時に発行し、スループットをテスト。
- DMLリフレッシュ。
- 複数のデータ形状によるCTAS。
本題に入る前に最後に一言。リポジトリをクローンしてreadmeに従えば、このベンチマークは誰でも簡単に実行できます。100%再現可能です。
単一クエリを最も安く実行する方法
目的: 1分以内に完了するクエリを1本、できるだけ安く実行する。
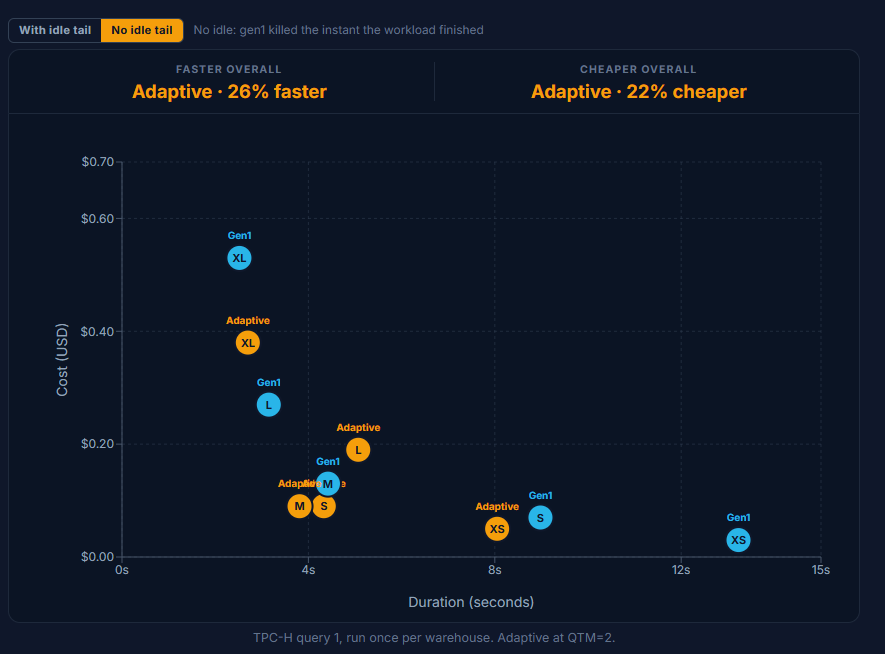
どのサイズでもクエリ1は1分を大きく下回る時間で完了します。最も遅いのはGen1 Smallの8秒、最速は約2.5秒です。制約となるのはレイテンシではなくコストです。そこで問いはこうなります。どうせ得られる答えに対して、どれだけ安く済ませられるか?
Gen1ではサイズのダイヤルは期待どおりに動きます。サイズを1段上げるとクエリ時間はおよそ半分になり、料金はおよそ2倍になります。Smallは9.5秒で$0.07、Mediumは4.3秒で$0.14、Largeは3.1秒で$0.28。XLargeになると完全に収穫逓減で、3.4秒に$0.55——Largeより速くならないのに価格は2倍です。
Adaptiveの方は、より興味深い結果になりました。Small、Medium、Largeは比較的近い値に収まる一方、XLargeだけが外れ値として突出します。SmallとMediumのおよそ4倍のコスト($0.38対$0.09)でありながら、Mediumより約1秒速いだけ(2.7秒対3.8秒)です。ほとんど測定できない高速化に対して、大きなプレミアムを払うことになります。
チャート: TPC-Hクエリ1をウェアハウスごとに1回実行。AdaptiveはQTM=2。
💡ポイント
Snowflakeに大きなリソースへ手を伸ばすことを許せば、より小さなリソースの方が安く答えを出せた場合でも、喜んでそうします。サイズ上限を設定しても、処理が自動的に小さなコンピュートへ押し下げられるわけではないようです。高く設定すれば、高く支払うことになります。その注意点を除けば、この単一クエリでは総合的にAdaptiveの勝ちです。平均してGen1より速く、平均して安い結果でした。
常時稼働するウェアハウス
目的: ウェアハウスを常にフル稼働させ続ける、途切れのない定常的なワークロードをシミュレートする。
66本のクエリを間隔なく逐次実行するため、ウェアハウスがアイドルになることはありません。その負荷がスケジュールされたジョブチェーンであれ、絶え間ないリクエストの流れであれ、一日中作業するアナリストであれ、形は同じ——連続した処理です。アイドル時間がなく弾力性による最適化の余地がないため、これは純粋なコンピュート価値を測る最もクリーンなテストです。
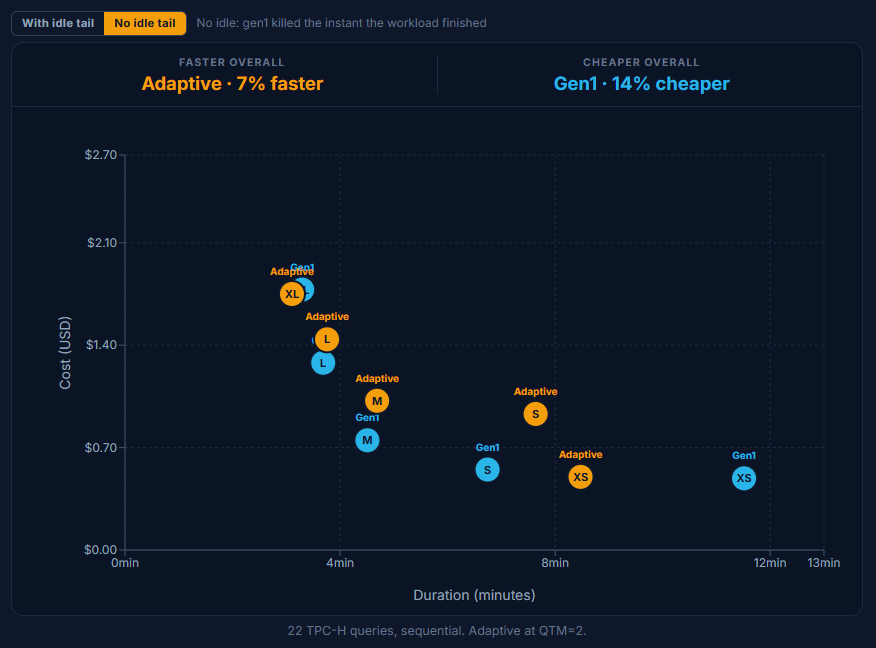
速度そのものでは、両者は想像以上に接近しており、Gen1が健闘します。Adaptiveが劇的に速いのはXSサイズのみ(約8.5分対11.4分)。Small、Medium、LargeではむしろGen1の方がわずかに速く終わり、XLargeでは約3.2分で並びます。コストでは、ほとんどのサイズ帯でも合計でもGen1がリードします。
チャート: TPC-Hの22クエリを逐次実行。AdaptiveはQTM=2。
💡ポイント
常時稼働するウェアハウスでは、Gen1が堅実な主力です。速度はほとんどのサイズでAdaptiveと同等で、XSmallからLargeまではより安価です。Adaptiveが真価を発揮するのは両端で、最小サイズでの大幅な速度向上と、XLargeでのみ実質的なコスト削減が見られます。サイズレンジ中間帯の定常的に飽和したワークロードでは、固定のGen1ウェアハウスに軍配が上がります。
同時実行:Adaptiveは高速、コストはサイズ次第
目的: 22本のクエリを同時に発行する。BIツール、ダッシュボードの更新、チーム全員が一斉にアクセスする状況を想定。
Gen1は同時実行のスパイクをマルチクラスターのスケールアウトで吸収します。今回は最大4クラスターに制限し、アクティブなクラスターごとに課金されます。一方Adaptiveはクエリを共有コンピュートにプールし、QTMダイヤルでバーストします。QTMを高くするほど並列コンピュートが増え、クレジットも増えます。アイドルテールの切り替えが影響するのはGen1のみです。バースト終了と同時にウェアハウスを落とす(「アイドルテールなし」)と、サイズあたり約$0.10〜$0.20請求が減ります。Adaptiveにはアイドルという概念がないため影響を受けません。
QTM=2では、AdaptiveはすべてのサイズでGen1より速くバーストを処理します。コストはまちまちです。小さいサイズ帯ではAdaptiveが安く(XSmall $0.17対$0.23、Small $0.23対$0.34)、XLargeでも安い($0.83対$1.26)一方、中間帯ではGen1のマルチクラスターモデルの方が安価です(Medium $0.39対$0.54、Large $0.69対$0.84)。
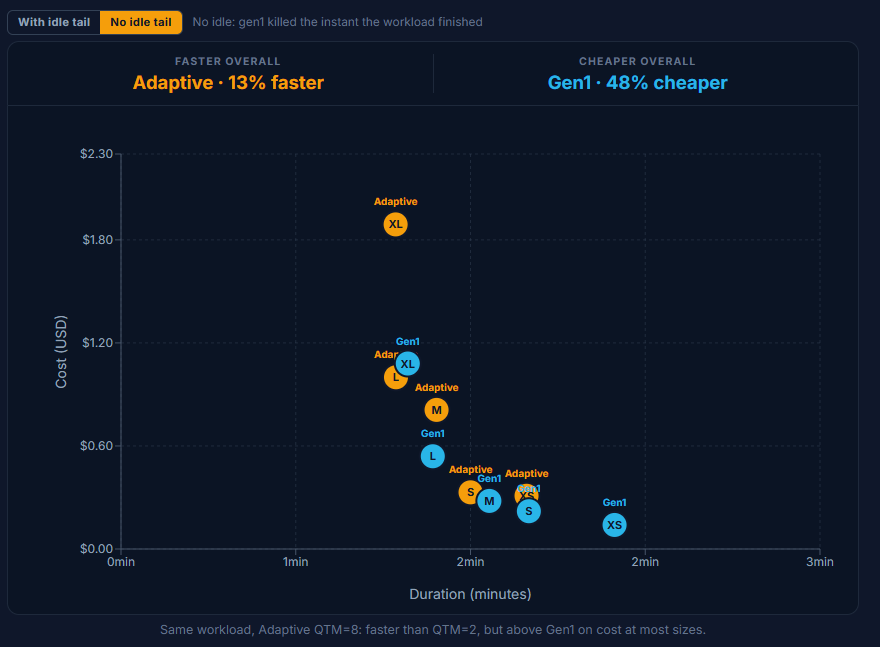
QTM=8まで上げるとさらに速くなりますが、その分の対価を払うことになります。ほとんどのサイズでGen1を上回り(Medium $0.81対$0.39、XLarge $1.89対$1.26)、Smallでようやく並ぶ程度です。QTM=8が見合うのは、レイテンシが請求額より明らかに優先される場合だけです。(おそらくキューの消化は速くなったものの、最も遅いクエリの完了を待つだけになったのでしょう。)
チャート: 22クエリの同時実行。Adaptive QTM=2対Gen1マルチクラスター(最大4)。
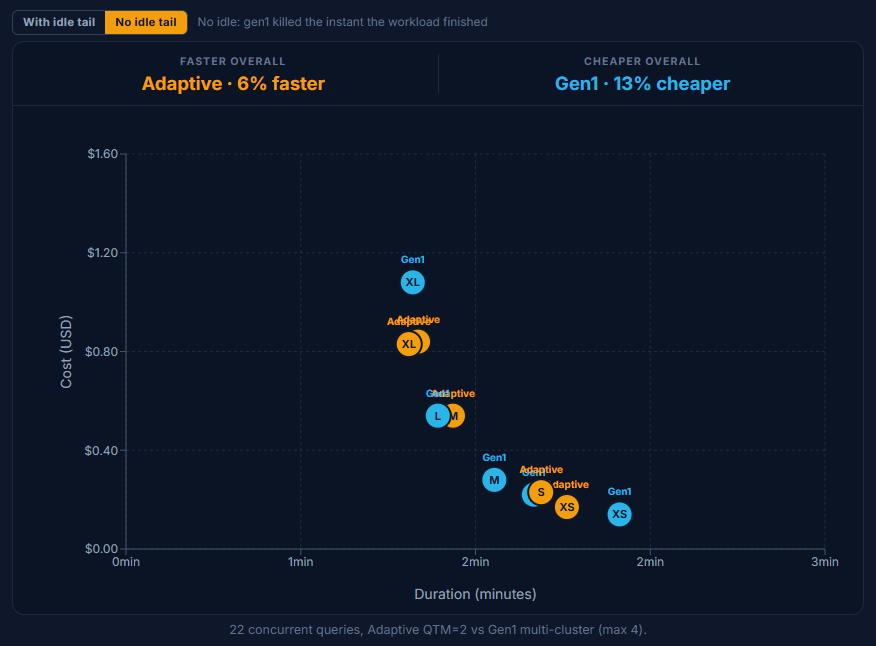
チャート: 同じワークロードでAdaptive QTM=8。QTM=2より速いが、ほとんどのサイズでコストはGen1を上回る。
💡ポイント
同時実行では、AdaptiveはすべてのサイズでGen1より高速なエンジンです。落とし穴はQTMダイヤルです。QTM=2からQTM=8に上げても得られるのは数秒だけ(Medium 84秒→81秒、XLarge 73秒→71秒)なのに、請求額はおよそ2倍になります(Medium $0.54→$0.81、XLarge $0.83→$1.89)。このワークロードに対して、私たちはQTMを高く設定しすぎました。Snowflakeはバーストを処理するのにその余裕を必要としませんでしたが、確保した分の料金は請求されました。高いQTMは、本当に必要なときだけ設定しましょう。
DMLリフレッシュ:ETLの書き込みジョブ
目的: 典型的なインクリメンタルジョブを模した、削除+挿入によるリフレッシュ。
ここでのジョブは現実的なインクリメンタルリフレッシュです。lineitemから1か月分を削除してソースから再挿入します。約6億行のテーブルの約1%にあたります。ベーステーブルは大きいものの、変更は小さい。Snowflakeのマイクロパーティションプルーニングは、その月が触れるパーティションだけを正確に対象にして残りをスキップするため、エンジンはこれがフルテーブルの書き換えではなく、小さなピンポイントの書き込みであることを事前に把握できます。これが以下のすべての鍵です。
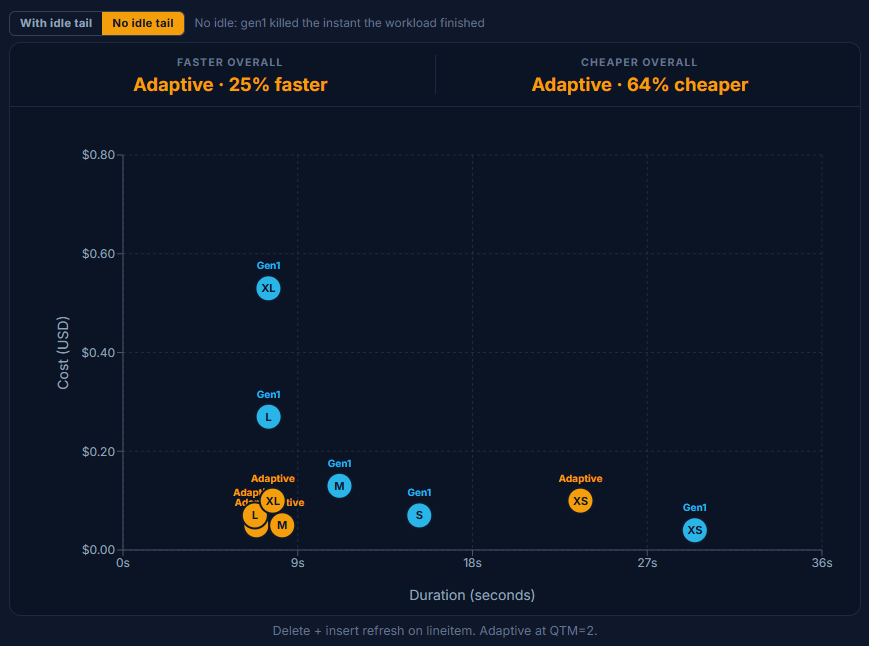
Gen1では事前にサイズをコミットする必要があり、バーストにそのサイズが必要だったかどうかにかかわらず最低料金として課金されます。削除+挿入はSmall以上では数秒で完了しますが、Gen1の価格はダイヤルに沿って一直線に上昇します。XSmallで$0.05、Smallで$0.08、Mediumで$0.15、Largeで$0.29、XLargeで$0.60。支払っているのは処理に対してではなく、ウェアハウスに対してです。
Adaptiveはその正反対で、この章こそAdaptiveの賢さが最も際立つ場面です。Small、Medium、Large、XLargeがどれほど密集しているかに注目してください。$0.05、$0.05、$0.07、$0.09。きれいに価格順には並んでいるものの、XLargeでもメーターはSmallからほとんど動いていません。削除+挿入はごく一部のパーティションにプルーニングされ、Snowflakeは高価なコンピュートを投入しなくてもジョブを完了できると明確に認識しています。サイズ上限が許していても、過剰なプロビジョニングを自ら控えるのです。請求額はダイヤルではなく、処理内容に追従します。
唯一の例外はXSmallで、Adaptive($0.10)はGen1($0.05)に劣ります。回収すべき過大なアイドルウェアハウスがないため、Adaptiveのクエリ単位のプレミアムを取り返す余地がありません。第2章とまったく同じパターンです。
チャート: lineitemに対する削除+挿入リフレッシュ。AdaptiveはQTM=2。
💡ポイント
これこそAdaptiveの最も賢い姿です。巨大なテーブルに対する、厳密にプルーニングされた1%の書き込みという処理の性質を読み取り、与えられたサイズ上限を使い切る代わりに意図的に小さくとどまります。XLargeを指定しても、ジョブに必要なのはそれだけだからとSmall並みの支出に収まり、請求額は設定したダイヤルではなく実際に使用したリソースに追従します。インクリメンタルなパイプラインにとって、これはまさに望ましい挙動であり、「サイズ当て」に伴う無駄なコストを完全に取り除いてくれます。
Snowflakeの課金は、シンプルになるどころか複雑化しています。その上でAIやMLのワークロードを運用しているなら、コストの全体像はますます読みにくくなります。Cortex、モデルサービング、その他スタック全体の支出を実際にコントロールする方法をまとめた実践ガイドを用意しました。
CTAS:スキャン主体の重い書き込み
目的: 5種類のデータ形状に対するCREATE TABLE AS SELECT。大規模な読み取りからテーブル全体をマテリアライズする。
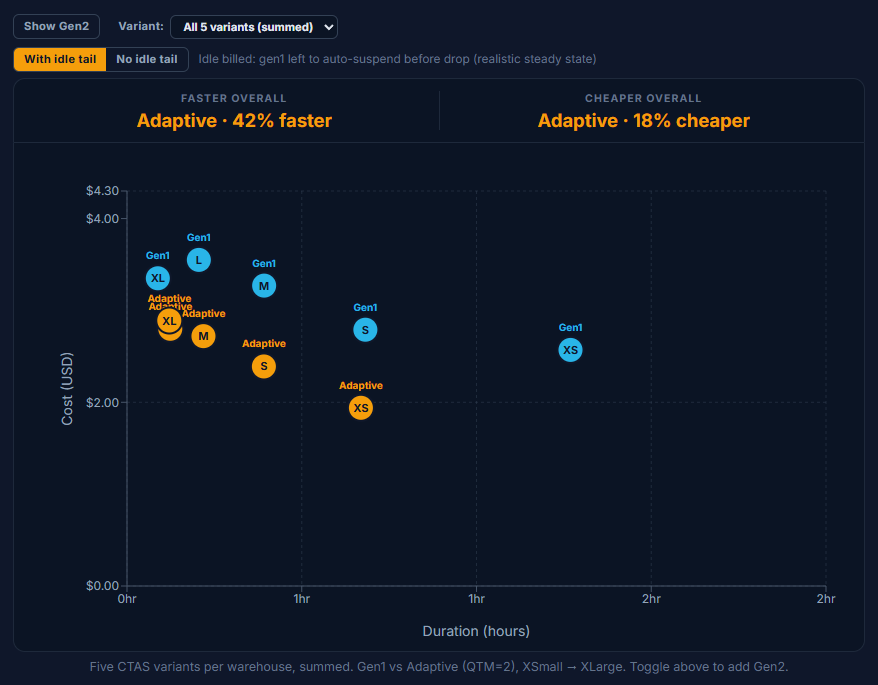
DMLリフレッシュがピンポイントの1%書き込みだったのに対し、CTASはその正反対です。5つのCREATE TABLE AS SELECTバリアント(narrow/tall、standard/tall、medium/wide、very wide、フィルタ付きの形状)が、大量のスキャンとマテリアライズを行います。回収すべきアイドルウェアハウスもプルーニングのショートカットもないため、処理は純粋なコンピュートそのもの——3世代のウェアハウスを並べて、スループット単価を素直に比較できる最もクリーンな場面です。
コストでは、Adaptiveがすべてのサイズで最安です。XSmallからXLargeまで$1.94 / $2.39 / $2.72 / $2.80 / $2.89で、Gen1の$2.57 / $2.79 / $3.27 / $3.55 / $3.35を大きく下回ります。速度でもAdaptiveはXSmallからLargeまでGen1をリードしますが、XLargeで順位が逆転します。
このXLargeでの逆転は、1つのバリアントが原因です。XLargeのAdaptiveは7.3分で、Gen1の5.3分より遅くなります。very_wideバリアントがAdaptiveでスケールしなくなるためで、XLargeではこれ単体で約6分かかる一方、他の4バリアントは数秒で完了します。上のバリアントフィルターで除外する(または単一のバリアントに絞り込む)と、この異常値は消えます。
💡 ポイント
AdaptiveはXSmallからXLargeまで最安であり、XSmallからLargeまでは最速でもあります。問題はXLargeで、1つのバリアント(very_wide)がAdaptiveのスケーリングを崩し、チャート上ではGen1より遅くなります。上のバリアントフィルターで除外するか単一のクエリ形状に絞り込み、Gen2をオンにして新しい標準ウェアハウスがどう並ぶかも確認してみてください。
Frequently asked
questions
15分以内でセットアップ完了
Snowflake、Databricks、またはBigQueryのアカウントを接続すれば、削減可能額をすぐに把握できます。
Adaptiveは、導入するだけでコストが下がる仕組みではありません。 これが本ベンチマークから得られた最も重要な結論であり、事前に話を聞いた多くの顧客がこの機能に抱いていた期待とは逆の結果です。5種類のワークロードを通じて、Adaptiveはあるシナリオでは安く、別のシナリオでは高く、残りはほぼ互角でした。請求額が下がることを期待してすべてのウェアハウスを一斉にAdaptiveに切り替えることは、どの顧客にもお勧めしません。実際にはむしろ上がる可能性が高いでしょう。Adaptiveはコストではなくパフォーマンスのために最適化されています。 これは私たちが行ったほとんどの実験に通底する傾向です。サイズ上限やQTMの設定を与えると、Snowflakeは概して、許された上限まで手を伸ばして可能な限り速い答えを返そうとします。第1章ではMAX_QUERY_PERFORMANCE_LEVELでこれを示しました。XLargeはSmall設定の約4倍のコストで、ほとんど測定できない程度の高速化しか得られませんでした。第3章ではQTMで示しました。QTM=2からQTM=8に上げて得られたのは数秒で、請求額はおよそ2倍になりました。明確な例外は第4章のDMLリフレッシュで、Adaptiveは厳密にプルーニングされた1%の書き込みという性質を読み取り、XLargeを指定されても意図的に小さくとどまりました。つまりエンジンは抑制できるのですが、ワークロードの形状を問わず一貫してそうするわけではありません。結論は、Adaptiveが無謀だということではなく、ダイヤルは依然としてチューニングと慎重な設定が必要だということです。
ウェアハウスの構成について考える必要は、依然としてなくなりません。 Adaptiveの売り文句は、サイジングの判断が不要になるというものでした。しかし実際には、本ベンチマークが示すとおり、判断の形が変わっただけです。固定サイズを選ぶ代わりに、今度はMAX_QUERY_PERFORMANCE_LEVEL(支出の上限)とQTM(同時実行/バーストの上限)を選ぶことになります。どちらも請求額を大きく左右します。「念のため」と高く設定すれば、不要だった余裕に対して支払うことになります。
自社のワークロードで必ずベンチマークしてください。 今回の結果はTPC-H SF1000と、実行した5種類のワークロードに固有のものです。皆さんのクエリ、データレイアウト、プルーニングの挙動、同時実行プロファイル、アイドルパターンによって数値は変わります。方向性としての知見は出発点の仮説として有用ですが、実際のデータ上で実際のワークロードに対してAdaptiveをテストすることの代わりにはなりません。ベンチマークのリポジトリは再現可能です。フォークして自分のクエリに差し替え、重要なものを移行する前に計測してください。
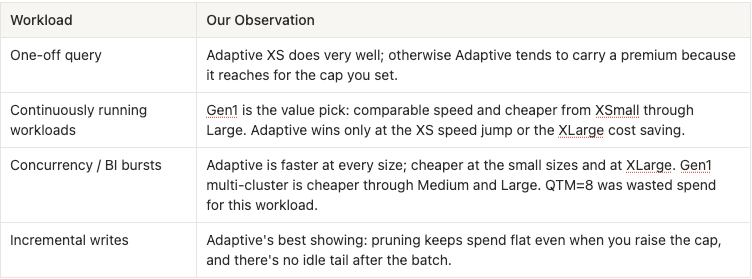
そのうえで、私たち自身のワークロードをベンチマークした際に観察した内容を以下にまとめます:
皆さんは自社のワークロードでAdaptiveをベンチマークしましたか?ぜひ結果をお聞かせください!実際の環境でAdaptiveがどう振る舞うのか、私たちは常に理解を深めたいと考えています。