
Abspielen
TLDR
Mit Snowflakes Adaptive Warehouse legen Sie statt einer festen Größe ein Performance-Limit und einen Concurrency-Multiplikator fest. Wir haben es auf TPC-H SF1000 über vier Warehouse-Größen und fünf Workload-Typen direkt gegen Gen1 antreten lassen. Adaptive gewinnt bei Einzel-Queries und DML-Refreshes, wo es die Struktur der Arbeit erkennt und nicht überprovisioniert. Gen1 behauptet sich bei sequenziellen Workloads und mittlerer Concurrency. Die Stellschrauben müssen Sie weiterhin selbst einstellen. Adaptive ändert, was die Stellschraube steuert – nicht, ob Sie darüber nachdenken müssen.
Was ist Snowflakes neues Adaptive-Warehouse-Feature?
Snowflakes neues Adaptive Warehouse verspricht, Ihnen das Sizing komplett abzunehmen. Statt eine feste Größe, einen Scale Factor und QAS zu wählen, an Suspend und Resume herumzuschrauben und dabei für Kapazität zu zahlen, die Ihre kleinsten Queries nie voll ausnutzen, poolt und skaliert Snowflake Compute automatisch im Hintergrund und berechnet nur, was jede Query tatsächlich verbraucht. Die naheliegende Frage: Spart das wirklich Geld – und wo? Um das herauszufinden, haben wir es auf TPC-H SF100 (~600 Mio. Zeilen in lineitem) direkt gegen das klassische Gen1-Warehouse antreten lassen, über vier Größen (Small → XLarge) und fünf Workload-Profile.
Adaptive-Einstellungen
Adaptive hat zwei Stellschrauben: MAX_QUERY_PERFORMANCE_LEVEL (das Größenlimit) und QTM, den Query-Throughput-Multiplikator – eine Stellschraube für Concurrency und Burst. Schauen wir uns beide im Detail an; genau das messen alle Diagramme in diesem Benchmark.
MAX_QUERY_PERFORMANCE_LEVEL
Die Performance-Obergrenze für jede einzelne Query, angegeben als T-Shirt-Größe von XSMALL bis X4LARGE (Standard: XLARGE). Snowflake nutzt sie als Obergrenze, nicht als feste Zuteilung: Die Engine wählt die Ressourcen, die sie für die Query für nötig hält, und deckelt diese Wahl bei diesem Level. Für kleine Queries nutzt sie unter Umständen deutlich weniger; für große geht sie nicht darüber hinaus. Ein niedriger Wert spart Geld, kann aber Ihre größten Queries ausbremsen; ein hoher Wert schaltet die volle Performance frei, bedeutet aber, dass eine einzelne schwere Query entsprechend viel kosten kann. Wichtig: Dieser Wert entspricht keiner konkreten zugrunde liegenden Compute-Konfiguration; Snowflake bestimmt die tatsächlich benötigten Ressourcen pro Query. Konkret können wir nicht sagen: "Diese Query lief wirklich auf einem Small und wurde zu Small-Credit-Raten abgerechnet." Das ist KEIN Abrechnungslimit, sondern ein Performance-Limit.
QUERY_THROUGHPUT_MULTIPLIER (QTM)
Ein ganzzahliger Skalierungsfaktor (Standard: 2), der festlegt, wie viel Burst-Kapazität das Warehouse zu jedem Zeitpunkt nutzen darf. Snowflake berechnet aus Ihrem MAX_QUERY_PERFORMANCE_LEVEL eine interne Basiskapazität und multipliziert sie mit QTM, um die Concurrency-Obergrenze zu erhalten. QTM=N bedeutet, dass das Warehouse grob N Queries gleichzeitig auf vollem Performance-Level ausführen kann – da die meisten Queries weniger als das Maximum nutzen, erzielen Sie in der Praxis oft mehr Durchsatz. QTM=0 bedeutet unbegrenzten Burst. Der Trade-off: Ein höherer QTM reduziert Queuing, hebt aber die Obergrenze der momentanen Ausgaben an; ein niedrigerer QTM deckelt die Kosten, riskiert aber, dass sich Queries stauen.
So werden Adaptive Warehouses abgerechnet
Adaptive nutzt ein Query-basiertes Abrechnungsmodell: Statt eine feste Warehouse-Reservierung sekundengenau zu berechnen, stellt Snowflake die Compute- und Software-Ressourcen in Rechnung, die jede Query tatsächlich verbraucht. Das Anlegen des Warehouse kostet nichts; der Zähler startet mit der ersten Query. Die Nutzung wird auf Warehouse-Ebene aggregiert und in standardmäßigen Virtual-Warehouse-Credits unter COMPUTE ausgewiesen, sodass bestehende Chargeback- und Showback-Strukturen weiter funktionieren.
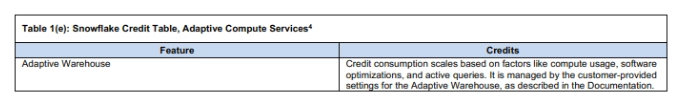
Die Abrechnung ist, offen gesagt, ziemlich intransparent. Snowflake beschreibt die Kosten als abhängig von "Faktoren wie der Menge an Compute- und Software-Ressourcen", die eine Query nutzt, liefert aber keine Formel, wie sich die Komponenten aufsummieren. Eine Kostenaufschlüsselung pro Query ist für die GA geplant, in der Public Preview aber nicht verfügbar. Es gibt keine Möglichkeit zu überprüfen, welche Ressourcen Snowflake einer bestimmten Query tatsächlich zugewiesen hat, oder nachzuvollziehen, warum sie gekostet hat, was sie gekostet hat. Das erfordert ein gutes Stück Vertrauen darauf, dass Snowflake fair zuteilt und entsprechend abrechnet. Sie stellen Ihre zwei Stellschrauben ein, lassen Ihren Workload laufen und lesen die aggregierte Rechnung ab. Für viele Teams ist dieser Deal vermutlich vertretbar – aber man sollte mit offenen Augen hineingehen.
Hier ein Screenshot, wie Snowflake die Preisgestaltung wörtlich formuliert:
Ausgaben von Adaptive Warehouses überwachen
Drei ACCOUNT_USAGE-Views sind für Adaptive Warehouses relevant. WAREHOUSE_METERING_HISTORY ist die wichtigste für den Credit-Verbrauch auf Warehouse-Ebene. QUERY_HISTORY zeigt Ihnen Performance und Timing einzelner Queries, wobei die Credit-Kosten pro Query während der Public Preview nicht ausgewiesen werden. WAREHOUSE_LOAD_HISTORY informiert Sie über Queuing – Ihr Signal dafür, ob der QTM angepasst werden sollte. Erwähnenswert: Die QAS-Nutzung wird bei Adaptive Warehouses in die Compute-Credits eingerechnet und erscheint, anders als bei Standard-Warehouses, nicht als separate Spalte.
Credit-Verbrauch pro Adaptive Warehouse in den letzten 30 Tagen:
WITH adaptive_whs AS (
  SELECT DISTINCT warehouse_name
  FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
  WHERE warehouse_size = 'ADAPTIVE'
    AND start_time >= DATEADD(day, -30, CURRENT_DATE())
)
SELECT
  m.warehouse_name,
  SUM(m.credits_used)         AS total_credits,
  SUM(m.credits_used_compute) AS compute_credits,
  MIN(m.start_time)           AS first_activity,
  MAX(m.end_time)             AS last_activity
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m
JOIN adaptive_whs a ON a.warehouse_name = m.warehouse_name
WHERE m.start_time >= DATEADD(day, -30, CURRENT_DATE())
Code aufklappen
Query-Performance und -Timing aus QUERY_HISTORY. Das kommt einer Kostentransparenz pro Query derzeit am nächsten; die tatsächliche Credit-Zuordnung pro Query wird in der Public Preview nicht offengelegt:
SELECT
  query_id,
  warehouse_name,
  query_type,
  total_elapsed_time / 1000  AS elapsed_sec,
  execution_time / 1000      AS exec_sec,
  queued_overload_time / 1000 AS queued_sec,
  partitions_scanned,
  bytes_scanned,
  start_time
FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
WHERE warehouse_size = 'ADAPTIVE'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY total_elapsed_time DESC
LIMIT 200;
Queuing-Verhalten aus WAREHOUSE_LOAD_HISTORY. Liegt avg_queued_load dauerhaft über null, ist Ihr QTM für den Workload zu niedrig:
SELECT
  start_time,
  warehouse_name,
  avg_running,
  avg_queued_load,
  avg_queued_provisioning,
  avg_blocked
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_LOAD_HISTORY
WHERE warehouse_name = '<your_adaptive_warehouse>'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY start_time;
Das Benchmark-Setup
Der Benchmark läuft auf TPC-H mit Scale Factor 1000 (SF1000), womit die lineitem-Tabelle rund 600 Millionen Zeilen umfasst. SF1000 ist groß genug, dass die Warehouse-Größe bei scan-lastigen Queries wirklich ins Gewicht fällt, aber klein genug, um die Kosten pro Lauf über viele Konfigurationen hinweg im Rahmen zu halten.
Alle Queries sind angepasste Versionen des Standard-TPC-H-Sets, geschrieben in Snowflake-Syntax. Das vollständige Query-Set finden Sie hier: adapted_queries. Jedes Warehouse lief auf einer frisch angelegten Instanz, damit Snowflakes Abrechnung Credits nie über mehrere Konfigurationen hinweg vermischt. Getestet haben wir XSmall bis XLarge, jeweils für Gen1 und Adaptive. Richtig gelesen: Wir haben XS auf 600 Mio. Zeilen getestet – und Sie wären überrascht, wie gut sich dieses Warehouse schlägt, selbst bei den ETL-Schritten.
Diese fünf Workload-Typen haben wir getestet:
- Eine einzelne Query, um zu klären, was Sie pro Warehouse-Typ mindestens ausgeben müssen.
- Ein sequenzieller Lauf von 66 Queries – die 22 Queries dreimal hintereinander –, um einen konstanten Workload zu messen, der länger als eine Minute dauert.
- Alle 22 Queries gleichzeitig abgefeuert, um den Durchsatz zu testen.
- DML-Refresh.
- CTAS mit mehreren Daten-Shapes.
Eine letzte Anmerkung, bevor wir loslegen: Sie können diesen Benchmark ganz einfach selbst ausführen, indem Sie das Repo klonen und der Readme folgen. Das Ganze ist für Sie zu 100 % reproduzierbar.
Der günstigste Weg, eine einzelne Query zu beantworten
Das Ziel: Eine Query ausführen, die in unter einer Minute fertig ist – für möglichst wenig Geld.
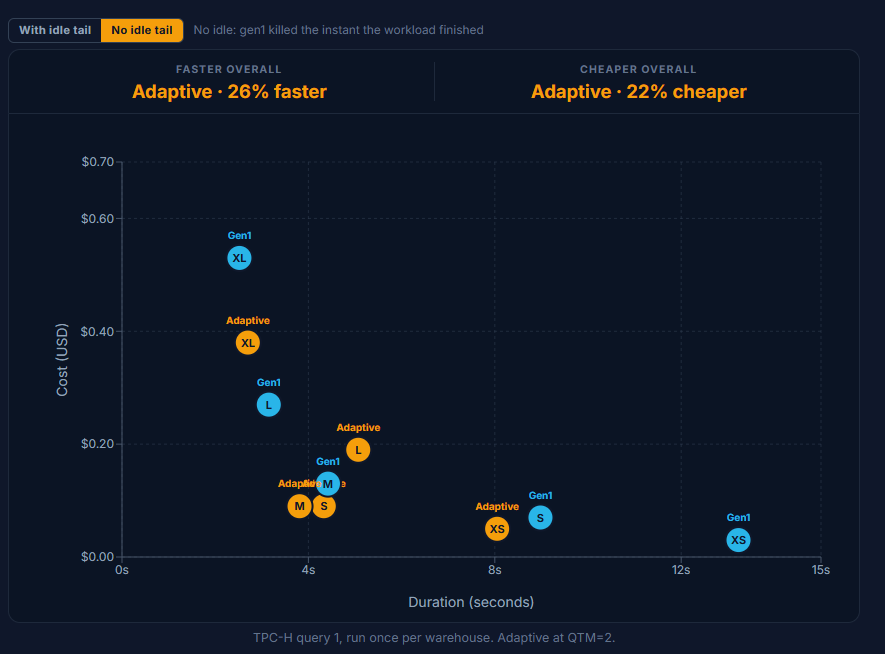
Jede Größe beantwortet Query 1 deutlich unter einer Minute; am langsamsten ist hier Gen1 Small mit 8 Sekunden, am schnellsten ~2,5 s. Die Latenz ist nicht der limitierende Faktor; die Ausgaben sind es. Die Frage lautet also: Wie wenig können Sie für eine Antwort zahlen, die Sie so oder so bekommen?
Bei Gen1 verhält sich der Größenregler genau wie erwartet. Eine Größe höher halbiert die Query-Zeit ungefähr, während sich der Preis ungefähr verdoppelt: Small in 9,5 s für $0.07, Medium in 4,3 s für $0.14, Large in 3,1 s für $0.28. Bei XLarge bleibt nur noch abnehmender Grenznutzen: $0.55 für 3,4 s – nicht schneller als Large, zum doppelten Preis.
Bei Adaptive ist das Bild interessanter. Small, Medium und Large liegen relativ dicht beieinander, dann schert XLarge als Ausreißer aus: Es kostet rund das Vierfache von Small und Medium ($0.38 vs. $0.09) und ist dabei nur etwa eine Sekunde schneller als Medium (2,7 s vs. 3,8 s). Sie zahlen einen hohen Aufpreis für einen kaum messbaren Geschwindigkeitsgewinn.
Diagramm: TPC-H Query 1, einmal pro Warehouse ausgeführt. Adaptive mit QTM=2.
💡 Fazit
Wenn Sie Snowflake erlauben, zu den größeren Ressourcen zu greifen, tut es das bereitwillig – selbst wenn kleinere Ressourcen die Antwort günstiger geliefert hätten. Das Größenlimit drückt Ihre Arbeit nicht von allein auf kleineres Compute; setzen Sie es hoch, zahlen Sie hoch. Ungeachtet dieses Vorbehalts gewinnt Adaptive diese Einzel-Query insgesamt trotzdem – im Schnitt schneller und im Schnitt günstiger als Gen1.
Ein durchgehend ausgelastetes Warehouse
Das Ziel: Einen gleichmäßigen, lückenlosen Workload simulieren, der ein Warehouse vollständig auslastet.
Sechsundsechzig Queries laufen ohne Pausen hintereinander, das Warehouse ist also nie im Leerlauf. Ob diese Last eine geplante Job-Kette ist, ein stetiger Strom von Anfragen oder ein Analyst, der den ganzen Tag arbeitet – das Muster ist dasselbe: kontinuierliche Arbeit. Das ist der sauberste Test für den reinen Compute-Gegenwert, denn ohne Leerlaufzeit, die sich zurückgewinnen ließe, hat Elastizität nichts wegzuoptimieren.
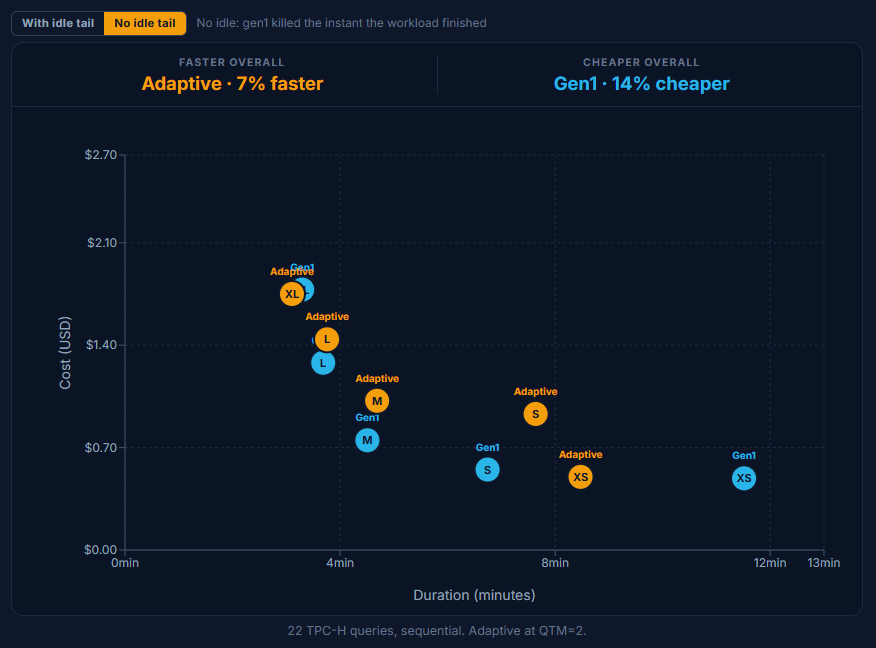
Bei der reinen Geschwindigkeit liegen beide näher beieinander, als man erwarten würde, und Gen1 behauptet sich. Adaptive ist nur bei der Größe XS deutlich schneller (etwa 8,5 Minuten vs. 11,4); bei Small, Medium und Large ist Gen1 sogar einen Tick früher fertig, und bei XLarge liegen beide gleichauf bei rund ~3,2 Minuten. Bei den Kosten führt Gen1 über den Großteil des Spektrums und in Summe.
Diagramm: 22 TPC-H-Queries, sequenziell. Adaptive mit QTM=2.
💡 Fazit
Bei einem durchgehend ausgelasteten Warehouse ist Gen1 das Arbeitstier: über die meisten Größen hinweg ähnlich schnell wie Adaptive und von XSmall bis Large günstiger. Adaptive rechnet sich an den Extremen – ein großer Geschwindigkeitssprung bei der kleinsten Größe und eine echte Kostenersparnis nur bei XLarge. Für gleichmäßige, gesättigte Workloads in der Mitte des Größenspektrums gewinnt in diesem Szenario ein festes Gen1-Warehouse.
Concurrency: Adaptive ist schneller, die Kosten hängen von der Größe ab
Das Ziel: 22 Queries gleichzeitig abfeuern: ein BI-Tool, ein Dashboard-Refresh, ein ganzes Team, das gleichzeitig zugreift.
Gen1 fängt eine Concurrency-Spitze mit Multi-Cluster-Scale-out ab, hier auf vier Cluster begrenzt und pro aktivem Cluster abgerechnet. Adaptive poolt die Queries stattdessen in gemeinsam genutztes Compute und burstet über die QTM-Stellschraube: Ein höherer QTM bedeutet mehr paralleles Compute – und mehr Credits. Der Idle-Tail-Schalter wirkt sich nur auf Gen1 aus: Wird das Warehouse sofort nach Ende des Bursts heruntergefahren ("kein Idle Tail"), sinkt dessen Rechnung je Größe um etwa $0.10 bis $0.20; Adaptive kennt kein Idle-Konzept und bleibt unberührt.
Bei QTM=2 arbeitet Adaptive den Burst bei jeder Größe schneller ab als Gen1. Bei den Kosten ist das Bild gemischt: Adaptive ist am unteren Ende günstiger (XSmall $0.17 vs. $0.23, Small $0.23 vs. $0.34) und wieder bei XLarge ($0.83 vs. $1.26), während Gen1s Multi-Cluster-Modell im Mittelfeld der günstigere Weg ist (Medium $0.39 vs. $0.54, Large $0.69 vs. $0.84).
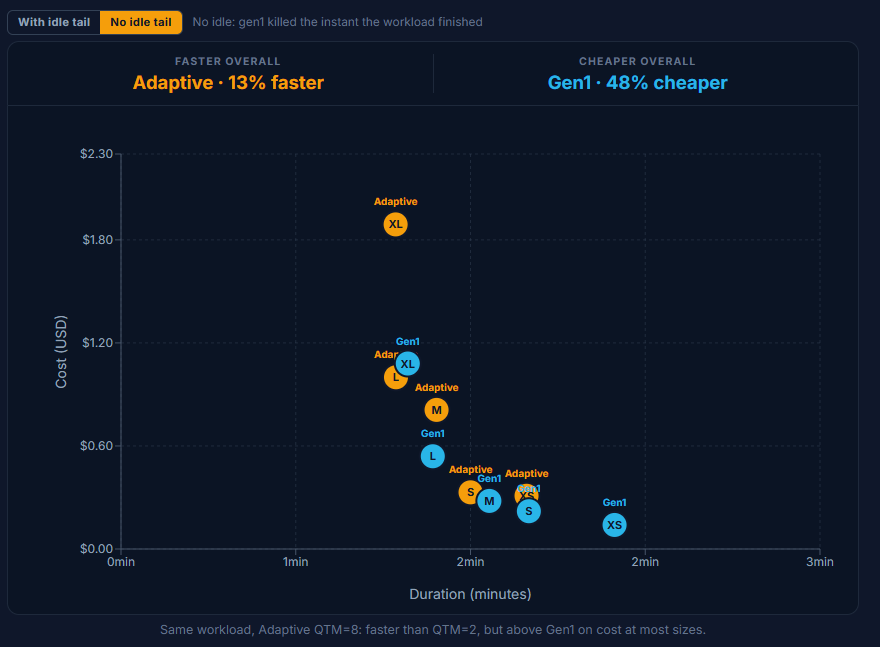
QTM=8 ist noch schneller, aber das hat seinen Preis: Bei den meisten Größen liegt es über Gen1 (Medium $0.81 vs. $0.39, XLarge $1.89 vs. $1.26) und zieht nur bei Small gleich. QTM=8 lohnt sich nur, wenn Latenz klar wichtiger ist als die Rechnung. (Höchstwahrscheinlich wurde die Queue schneller geleert und wir mussten nur noch auf die langsamste Query warten.)
Diagramm: 22 parallele Queries, Adaptive QTM=2 vs. Gen1 Multi-Cluster (max. 4).
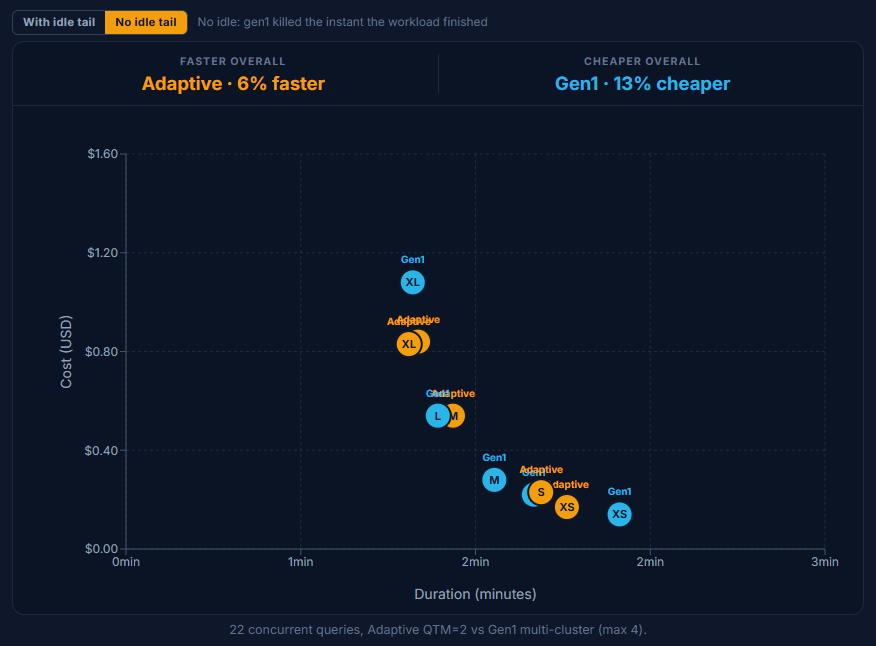
Diagramm: Derselbe Workload, Adaptive QTM=8 – schneller als QTM=2, aber bei den meisten Größen teurer als Gen1.
💡 Fazit
Bei Concurrency ist Adaptive bei jeder Größe die schnellere Engine. Der Haken ist die QTM-Stellschraube. Der Sprung von QTM=2 auf QTM=8 bringt nur wenige Sekunden (Medium 84 s auf 81 s, XLarge 73 s auf 71 s), während sich die Rechnung ungefähr verdoppelt (Medium $0.54 auf $0.81, XLarge $0.83 auf $1.89). Wir haben den QTM für diesen Workload zu hoch angesetzt: Snowflake brauchte diesen Spielraum nicht, um den Burst abzuarbeiten, hat uns die Reservierung aber trotzdem berechnet. Setzen Sie einen hohen QTM nur, wenn Sie ihn wirklich brauchen.
Ein DML-Refresh: der ETL-Schreibjob
Das Ziel: Ein Delete-plus-Insert-Refresh, der einen typischen inkrementellen Job nachbildet.
Der Job hier ist ein realistischer inkrementeller Refresh: einen Monat aus lineitem löschen und aus der Quelle neu einfügen – etwa 1 % der Zeilen in einer Tabelle mit ~600 Mio. Zeilen. Die Basistabelle ist groß, die Änderung ist es nicht. Snowflakes Micro-Partition-Pruning zielt genau auf die Partitionen, die dieser Monat berührt, und überspringt den Rest – die Engine erkennt also von vornherein, dass dies ein kleiner, chirurgischer Schreibvorgang ist und kein Full-Table-Rewrite. Das ist der Schlüssel zu allem, was folgt.
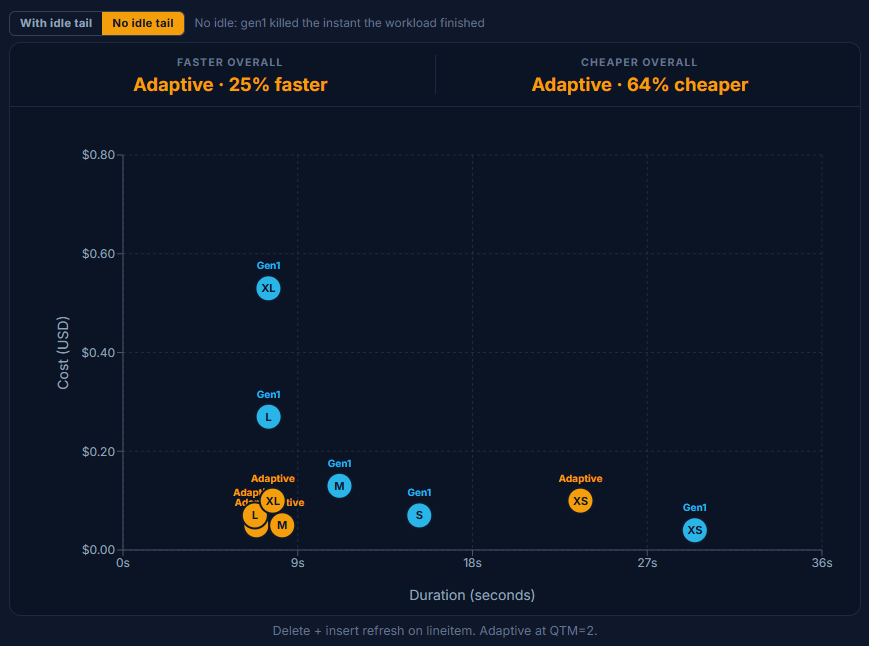
Gen1 zwingt Sie, sich vorab auf eine Größe festzulegen, und rechnet diese Größe als Minimum ab – egal, ob der Burst sie gebraucht hat oder nicht. Delete plus Insert ist ab Small in Sekunden fertig, und doch klettert Gen1s Preis stramm die Skala hinauf: $0.05 bei XSmall, $0.08 bei Small, $0.15 bei Medium, $0.29 bei Large, $0.60 bei XLarge. Sie zahlen für das Warehouse, nicht für die Arbeit.
Bei Adaptive zeigt sich das genaue Gegenteil, und in diesem Kapitel zeigt es sich von seiner klügsten Seite. Beachten Sie, wie dicht Small, Medium, Large und XLarge beieinanderliegen: $0.05, $0.05, $0.07, $0.09. Sie kommen sogar in sauberer Preisreihenfolge an, doch selbst bei XLarge hat sich der Zähler kaum von Small wegbewegt. Delete plus Insert grenzt die Arbeit per Pruning auf einen schmalen Ausschnitt an Partitionen ein, und Snowflake erkennt eindeutig, dass es den Job ohne teures Compute erledigen kann; es verzichtet aufs Überprovisionieren, selbst wenn das Größenlimit es erlauben würde. Die Rechnung folgt der Arbeit, nicht der Stellschraube.
Die einzige Ausnahme ist XSmall, wo Adaptive ($0.10) hinter Gen1 ($0.05) zurückbleibt. Ohne überdimensioniertes Warehouse im Leerlauf, das sich zurückgewinnen ließe, hat der Aufpreis pro Query bei Adaptive nichts, womit er sich amortisieren könnte – exakt das Muster aus Kapitel 2.
Diagramm: Delete-plus-Insert-Refresh auf lineitem. Adaptive mit QTM=2.
💡 Fazit
Hier ist Adaptive am klügsten. Es erkennt die Struktur der Arbeit – ein per Pruning eng eingegrenztes 1-%-Write gegen eine riesige Tabelle – und bleibt bewusst klein, statt das Größenlimit auszureizen, das Sie ihm eingeräumt haben. Selbst wenn Sie es auf XLarge stellen, gibt es nur so viel aus wie ein Small, weil der Job nicht mehr braucht – die Rechnung folgt also den genutzten Ressourcen, nicht der eingestellten Stellschraube. Für inkrementelle Pipelines ist das genau das Verhalten, das Sie wollen, und es beseitigt das Rätselraten um die richtige Größe vollständig.
Snowflakes Abrechnung wird komplexer, nicht einfacher. Wer darauf zusätzlich AI- und ML-Workloads betreibt, für den wird die Kostenstruktur schnell unübersichtlich. Wir haben einen praxisnahen Leitfaden zusammengestellt, der zeigt, wie Sie die Ausgaben über Cortex, Model Serving und den Rest des Stacks tatsächlich im Griff behalten.
Jetzt das Unofficial AI Cost Optimization Manual für Snowflake holen
CTAS: ein schwerer, scan-gebundener Schreibvorgang
Das Ziel: CREATE TABLE AS SELECT über fünf Daten-Shapes: ein großer Lesevorgang, der eine vollständige Tabellen-Materialisierung speist.
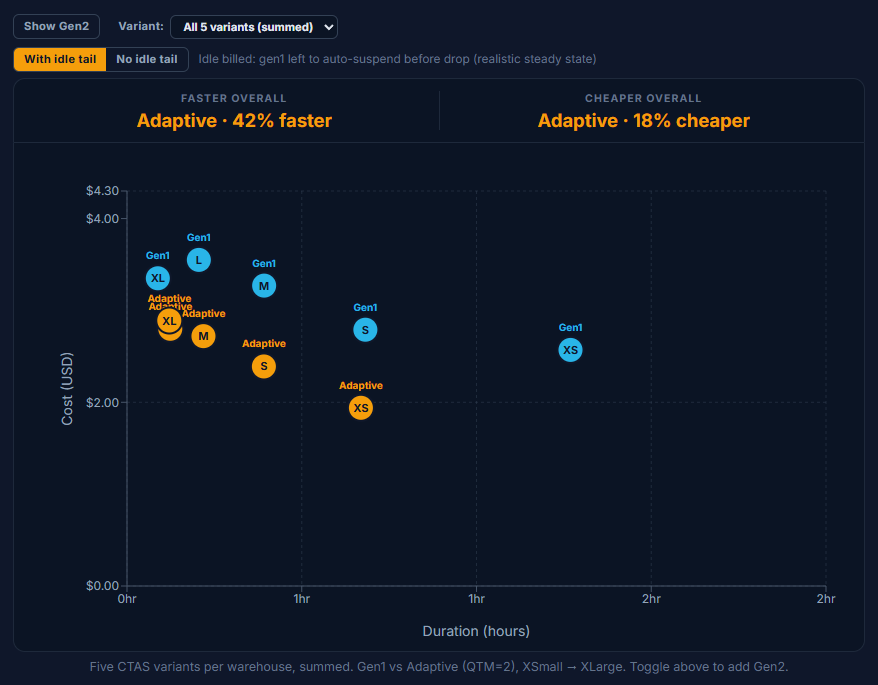
War der DML-Refresh ein chirurgisches 1-%-Write, ist CTAS das Gegenteil: fünf CREATE TABLE AS SELECT-Varianten (narrow/tall, standard/tall, medium/wide, very wide und eine gefilterte Form), die in großen Mengen scannen und materialisieren. Es gibt kein Warehouse im Leerlauf, das sich zurückgewinnen ließe, und keine Pruning-Abkürzung – die Arbeit ist also echtes Compute. Der sauberste Testfall, um das reine Preis-Durchsatz-Verhältnis über alle drei Warehouse-Generationen im direkten Vergleich abzulesen.
Bei den Kosten ist Adaptive bei jeder Größe der günstigste Wert: $1.94 / $2.39 / $2.72 / $2.80 / $2.89 von XSmall bis XLarge – deutlich unter Gen1s $2.57 / $2.79 / $3.27 / $3.55 / $3.35. Bei der Geschwindigkeit liegt Adaptive von XSmall bis Large ebenfalls vor Gen1 – bei XLarge dreht sich die Reihenfolge jedoch um.
Dieser XLarge-Umschwung geht auf das Konto einer einzigen Variante. Adaptive bei XLarge landet bei 7,3 Minuten und ist damit langsamer als Gen1 mit 5,3 Minuten, weil die Variante very_wide auf Adaptive nicht mehr skaliert – allein rund 6 Minuten bei XLarge, während die anderen vier Varianten in Sekunden fertig sind. Blenden Sie sie über den Variantenfilter oben aus (oder schauen Sie sich eine einzelne Variante an), und die Anomalie verschwindet.
💡 Fazit
Adaptive ist von XSmall bis XLarge der günstigste Wert und von XSmall bis Large zudem der schnellste. Der Haken ist XLarge, wo eine Variante (very_wide) die Skalierung von Adaptive aushebelt und Adaptive im Diagramm hinter Gen1 zurückfällt. Nutzen Sie den Variantenfilter oben, um sie auszuschließen oder eine einzelne Query-Form zu betrachten – und schalten Sie Gen2 dazu, um zu sehen, wie sich das neuere Standard-Warehouse schlägt.
Frequently asked
questions
In weniger als 15 Minuten startklar
Verbinden Sie Ihr Snowflake-, Databricks- oder BigQuery-Konto und erkennen Sie sofort Ihr Einsparpotenzial.
Adaptive ist keine Kostensenkung auf Knopfdruck. Das ist unsere wichtigste Erkenntnis aus diesem Benchmark – und sie widerspricht dem, was viele Kunden, mit denen wir gesprochen haben, im Vorfeld von dem Feature erwartet hatten. Über unsere fünf Workload-Profile hinweg war Adaptive in einigen Szenarien günstiger, in anderen teurer und im Rest ungefähr gleichauf. Wir raten keinem Kunden, plötzlich alle Warehouses auf Adaptive umzustellen in der Erwartung, dass die Rechnung sinkt – realistischerweise würde sie eher steigen. Adaptive ist auf Performance optimiert, nicht auf Kosten. Das ist der rote Faden durch die meisten unserer Experimente. Gibt man ein Größenlimit oder einen QTM-Wert vor, schöpft Snowflake in der Regel die Obergrenze aus, die man ihm einräumt, um die schnellstmögliche Antwort zu liefern. Kapitel 1 hat das mit MAX_QUERY_PERFORMANCE_LEVEL gezeigt: XLarge kostete ~4x gegenüber der Small-Einstellung – für einen kaum messbaren Geschwindigkeitsgewinn. Kapitel 3 hat es mit QTM gezeigt: Der Sprung von QTM=2 auf QTM=8 brachte wenige Sekunden und verdoppelte die Rechnung ungefähr. Die klare Ausnahme ist der DML-Refresh aus Kapitel 4, bei dem Adaptive die Struktur eines per Pruning eng eingegrenzten 1-%-Writes erkannte und bewusst klein blieb, selbst auf XLarge gestellt. Die Engine kann sich also zurückhalten – sie tut es nur nicht konsistent über alle Workload-Profile hinweg. Die Erkenntnis ist nicht, dass Adaptive rücksichtslos wäre, sondern dass die Stellschrauben weiterhin abgestimmt und sorgfältig konfiguriert werden müssen.
Sie müssen weiterhin über Ihre Warehouse-Konfiguration nachdenken. Das Versprechen von Adaptive war, dass Sizing-Entscheidungen wegfallen. In der Praxis zeigt dieser Benchmark: Die Entscheidungen haben nur ihre Form geändert. Statt eine feste Größe zu wählen, wählen Sie jetzt ein MAX_QUERY_PERFORMANCE_LEVEL (eine Ausgabenobergrenze) und einen QTM (eine Concurrency-/Burst-Obergrenze). Beide verändern die Rechnung spürbar. Setzen Sie sie "sicherheitshalber" zu hoch, zahlen Sie für Spielraum, den Sie nie gebraucht haben.
Sie müssen Ihre eigenen Workloads benchmarken. Unsere Ergebnisse gelten spezifisch für TPC-H SF1000 und die fünf Workload-Profile, die wir getestet haben. Ihre Queries, Ihr Datenlayout, Ihr Pruning-Verhalten, Ihr Concurrency-Profil und Ihre Leerlaufmuster werden andere Zahlen liefern. Die Tendenzen taugen als Ausgangshypothese; sie ersetzen aber keinen Test von Adaptive gegen Ihren tatsächlichen Workload auf Ihren tatsächlichen Daten. Das Benchmark-Repo ist reproduzierbar – forken Sie es, setzen Sie Ihre eigenen Queries ein und messen Sie, bevor Sie etwas migrieren, das wirklich zählt.
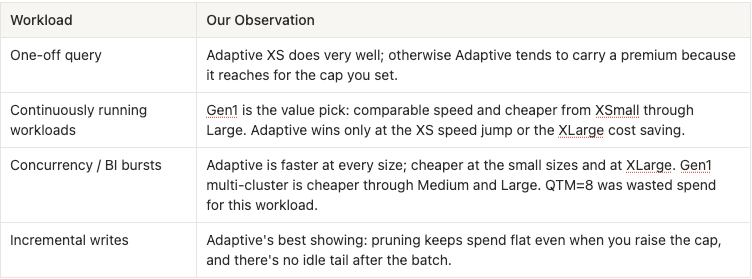
Vor diesem Hintergrund hier die Beobachtungen aus dem Benchmarking unserer eigenen Workloads:
Haben Sie Adaptive mit Ihren eigenen Workloads gebenchmarkt? Wir sind gespannt, was Sie beobachtet haben! Schreiben Sie uns – wir wollen unser Verständnis dafür, wie es sich in der Praxis verhält, immer weiter schärfen.