
Reproducir
TLDR
El Adaptive Warehouse de Snowflake te permite definir un techo de rendimiento y un multiplicador de concurrencia en lugar de comprometerte con un tamaño fijo. Lo enfrentamos cara a cara con Gen1 en cuatro tamaños de warehouse y cinco tipos de workloads sobre TPC-H SF1000. Adaptive gana en consultas individuales y en refrescos DML, donde interpreta la forma del trabajo y no sobreaprovisiona. Gen1 se defiende bien en workloads secuenciales y en concurrencia de rango medio. Los ajustes siguen dependiendo de ti: Adaptive cambia lo que controla cada ajuste, no la necesidad de pensarlo.
¿Qué es la nueva función Adaptive Warehouse de Snowflake?
El nuevo Adaptive Warehouse de Snowflake promete quitarte de encima la tarea de elegir el tamaño. En lugar de definir un tamaño fijo, un scale factor, QAS y andar ajustando Suspend y Resume —pagando por capacidad que tus consultas más pequeñas nunca usarán por completo—, Snowflake agrupa y escala el cómputo automáticamente tras bambalinas y te cobra solo por lo que cada consulta consume en realidad. La pregunta obvia es si eso realmente ahorra dinero, y en qué casos. Para averiguarlo, lo pusimos frente a frente con el warehouse clásico Gen1 sobre TPC-H SF100 (lineitem de ~600 M de filas), en cuatro tamaños (Small → XLarge) y cinco formas de workload.
Los ajustes de Adaptive
Adaptive tiene dos controles: MAX_QUERY_PERFORMANCE_LEVEL (su tope de tamaño) y QTM, el multiplicador de throughput de consultas, un control de concurrencia y ráfagas. Veámoslos en detalle: son lo que cada gráfico de este benchmark mide en realidad.
MAX_QUERY_PERFORMANCE_LEVEL
Es el techo de rendimiento para cualquier consulta individual, expresado como talla de camiseta de XSMALL a X4LARGE (predeterminado: XLARGE). Snowflake lo usa como límite superior, no como asignación fija: el motor elige los recursos que cree que la consulta necesita y limita esa elección a este nivel. Para consultas pequeñas puede usar mucho menos; para las grandes no subirá más allá. Configurarlo bajo ahorra dinero, pero puede ralentizar tus consultas más pesadas; configurarlo alto libera todo el rendimiento, pero implica que una sola consulta pesada puede gastar en consecuencia. Importante: esto no corresponde a una configuración específica de cómputo subyacente; Snowflake determina los recursos reales que necesita cada consulta. En concreto, no podemos afirmar "esta en realidad corrió en un Small y se facturó a precios de créditos de Small. Esto NO es un tope de facturación, es un tope de rendimiento.
QUERY_THROUGHPUT_MULTIPLIER (QTM)
Un factor de escala entero (predeterminado: 2) que define cuánta capacidad de ráfaga puede usar el warehouse en un instante dado. Snowflake calcula una capacidad base interna a partir de tu MAX_QUERY_PERFORMANCE_LEVEL y luego la multiplica por el QTM para obtener el techo de concurrencia. Con QTM=N, el warehouse puede ejecutar aproximadamente N consultas simultáneas al nivel máximo de rendimiento, aunque como la mayoría de las consultas usa menos que el máximo, en la práctica sueles obtener más throughput. Con QTM=0, la ráfaga es ilimitada. El dilema: un QTM más alto reduce las colas pero eleva el techo del gasto instantáneo; uno más bajo limita los costos, pero arriesga que las consultas se acumulen.
Cómo se facturan los Adaptive Warehouses
Adaptive usa un modelo de facturación por consulta: en lugar de cobrar por segundo una reserva fija de warehouse, Snowflake cobra según los recursos de cómputo y software que cada consulta consume en realidad. Crear el warehouse no cuesta nada; el medidor arranca con la primera consulta. El uso se agrega a nivel de warehouse y se reporta en créditos estándar de virtual warehouse bajo COMPUTE, por lo que las estructuras existentes de chargeback y showback siguen funcionando.
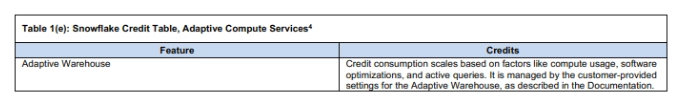
La facturación es, francamente, bastante opaca. Snowflake describe el costo como dependiente de "factores como la cantidad de recursos de cómputo y software" que usa una consulta, pero no ofrece una fórmula para sumar los componentes. El desglose de costo por consulta está planeado para GA, pero no está disponible en Public Preview. No hay forma de verificar qué recursos asignó Snowflake realmente a una consulta específica ni de auditar por qué costó lo que costó. Eso exige depositar una buena dosis de confianza en que Snowflake asigne de forma justa y cobre en consecuencia. Configuras tus dos ajustes, ejecutas tu workload y lees la factura agregada. Para muchos equipos ese intercambio probablemente sea razonable, pero conviene entrar con los ojos abiertos.
Aquí tienes una captura de pantalla con la redacción exacta de Snowflake sobre los precios:
Cómo monitorear el gasto del Adaptive Warehouse
Hay tres vistas de ACCOUNT_USAGE relevantes para los adaptive warehouses. WAREHOUSE_METERING_HISTORY es la principal para el consumo de créditos a nivel de warehouse. QUERY_HISTORY te permite ver el rendimiento y los tiempos de cada consulta, aunque los costos en créditos por consulta no se desglosan durante la Public Preview. WAREHOUSE_LOAD_HISTORY te informa sobre las colas, que es tu señal para saber si debes ajustar el QTM. Un detalle a tener en cuenta: el uso de QAS se incluye dentro de los créditos de cómputo en los adaptive warehouses y no aparece como columna separada, a diferencia de los warehouses estándar.
Consumo de créditos por adaptive warehouse en los últimos 30 días:
WITH adaptive_whs AS (
  SELECT DISTINCT warehouse_name
  FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
  WHERE warehouse_size = 'ADAPTIVE'
    AND start_time >= DATEADD(day, -30, CURRENT_DATE())
)
SELECT
  m.warehouse_name,
  SUM(m.credits_used)         AS total_credits,
  SUM(m.credits_used_compute) AS compute_credits,
  MIN(m.start_time)           AS first_activity,
  MAX(m.end_time)             AS last_activity
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_METERING_HISTORY m
JOIN adaptive_whs a ON a.warehouse_name = m.warehouse_name
WHERE m.start_time >= DATEADD(day, -30, CURRENT_DATE())
Expandir código
Rendimiento y tiempos de consulta desde QUERY_HISTORY. Esto es lo más cercano a la visibilidad de costo por consulta disponible ahora mismo; la atribución real de créditos por consulta no se expone en la Public Preview:
SELECT
  query_id,
  warehouse_name,
  query_type,
  total_elapsed_time / 1000  AS elapsed_sec,
  execution_time / 1000      AS exec_sec,
  queued_overload_time / 1000 AS queued_sec,
  partitions_scanned,
  bytes_scanned,
  start_time
FROM SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY
WHERE warehouse_size = 'ADAPTIVE'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY total_elapsed_time DESC
LIMIT 200;
Comportamiento de las colas desde WAREHOUSE_LOAD_HISTORY. Si avg_queued_load se mantiene constantemente por encima de cero, tu QTM es demasiado bajo para el workload:
SELECT
  start_time,
  warehouse_name,
  avg_running,
  avg_queued_load,
  avg_queued_provisioning,
  avg_blocked
FROM SNOWFLAKE.ACCOUNT_USAGE.WAREHOUSE_LOAD_HISTORY
WHERE warehouse_name = '<your_adaptive_warehouse>'
  AND start_time >= DATEADD(day, -7, CURRENT_DATE())
ORDER BY start_time;
La configuración del benchmark
El benchmark se ejecuta contra TPC-H con Scale Factor 1000 (SF1000), lo que deja la tabla lineitem en aproximadamente 600 millones de filas. SF1000 es lo bastante grande para que el tamaño del warehouse realmente importe en consultas intensivas en escaneo, pero lo bastante pequeño para mantener razonable el costo por ejecución en muchas configuraciones.
Todas las consultas son versiones adaptadas del set estándar de TPC-H, escritas en sintaxis de Snowflake. Puedes explorar el set completo de consultas aquí: adapted_queries. Cada warehouse corrió en una instancia recién creada para que la facturación de Snowflake nunca mezclara créditos entre configuraciones. Probamos de XSmall a XLarge tanto para Gen1 como para Adaptive. Así es: probamos XS sobre 600 M de filas, y te sorprendería lo bien que se desempeña ese warehouse, incluso en los pasos de ETL.
Probamos estos cinco tipos de workloads:
- Una sola consulta, para responder cuál es el gasto mínimo en cada tipo de warehouse.
- Una ejecución secuencial de 66 consultas (las 22 consultas corridas 3 veces) para medir un workload constante que dura más de un minuto.
- Las 22 consultas lanzadas en simultáneo para probar el throughput.
- Refresco DML.
- CTAS, con varias formas de datos.
Una última nota antes de empezar. Puedes ejecutar este benchmark tú mismo clonando el repo y siguiendo el readme. Es 100% reproducible por tu cuenta.
La forma más barata de responder una sola consulta
El objetivo: Ejecutar una consulta que termine en menos de un minuto, con el menor gasto posible.
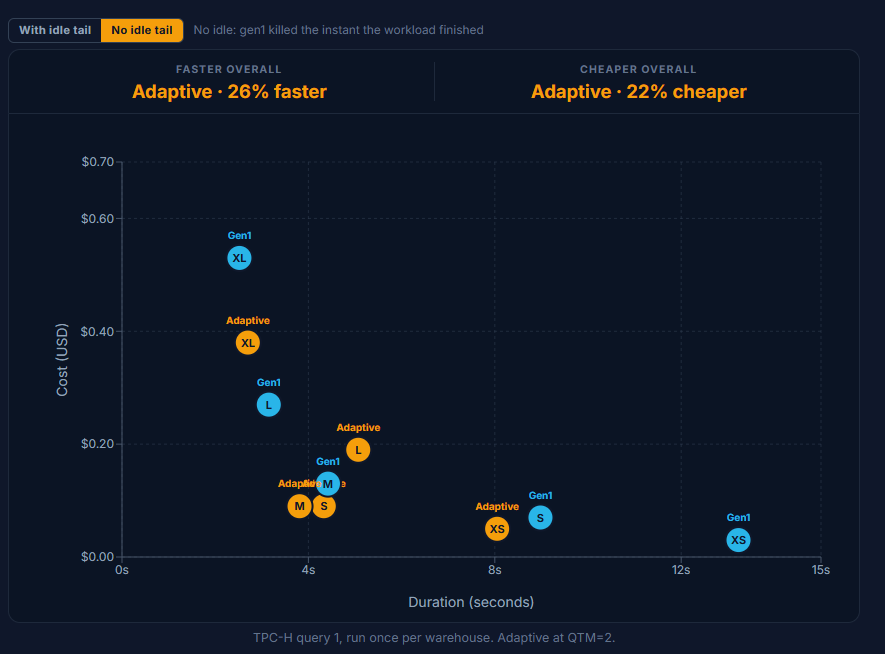
Todos los tamaños responden la consulta 1 en mucho menos de un minuto; el más lento aquí es Gen1 Small con 8 segundos, y el más rápido ronda los 2.5 s. La latencia no es la restricción; el gasto sí lo es. La pregunta entonces es: ¿qué tan poco puedes pagar por una respuesta que vas a obtener de todos modos?
En Gen1, el ajuste de tamaño se comporta exactamente como esperarías. Sube un tamaño y el tiempo de consulta cae aproximadamente a la mitad mientras el precio más o menos se duplica: Small en 9.5 s por $0.07, Medium en 4.3 s por $0.14, Large en 3.1 s por $0.28. Para XLarge ya son rendimientos decrecientes puros: $0.55 por 3.4 s, no más rápido que Large al doble de precio.
En Adaptive, el panorama es más interesante. Small, Medium y Large se mantienen relativamente cerca entre sí, y luego XLarge se despega como el caso atípico: cuesta aproximadamente 4 veces lo de Small y Medium ($0.38 vs $0.09) y termina apenas un segundo más rápido que Medium (2.7 s vs 3.8 s). Pagas una prima enorme por una mejora que apenas se puede medir.
Gráfico: consulta 1 de TPC-H, ejecutada una vez por warehouse. Adaptive con QTM=2.
💡Conclusión
Si dejas que Snowflake eche mano de los recursos más grandes, lo hará con gusto, incluso cuando recursos más pequeños habrían producido la respuesta a menor costo. El tope de tamaño no parece empujar tu trabajo hacia cómputo más pequeño por sí solo; configúralo alto y pagarás alto. Dicho esto, Adaptive igual gana esta consulta individual en el global: más rápido en promedio y más barato en promedio que Gen1.
Un warehouse ocupado sin pausa
El objetivo: Simular un workload estable y continuo que mantiene al warehouse completamente saturado.
Sesenta y seis consultas corren en secuencia sin pausas, de modo que el warehouse nunca queda inactivo. Ya sea una cadena de trabajos programados, un flujo constante de solicitudes o un analista trabajando todo el día, la forma es la misma: trabajo continuo. Esta es la prueba más limpia del valor bruto del cómputo, porque sin tiempo inactivo que recuperar, la elasticidad no tiene nada que optimizar.
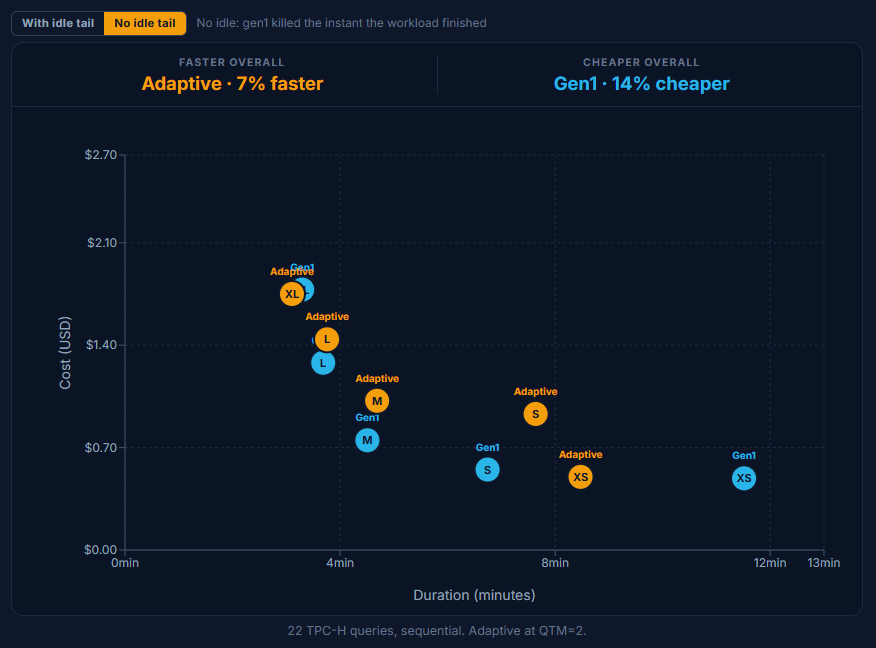
En velocidad pura, ambos están más cerca de lo que podrías esperar, y Gen1 se defiende bien. Adaptive es drásticamente más rápido solo en el tamaño XS (unos 8.5 minutos vs 11.4); en Small, Medium y Large, Gen1 de hecho termina un poco antes, y en XLarge empatan en aproximadamente ~3.2 minutos. En costo, Gen1 lidera en la mayor parte del rango y en el agregado.
Gráfico: 22 consultas TPC-H, secuenciales. Adaptive con QTM=2.
💡Conclusión
En un warehouse ocupado de forma continua, Gen1 es el caballo de batalla: velocidad comparable a la de Adaptive en la mayoría de los tamaños, y más barato de XSmall a Large. Adaptive se gana su lugar en los extremos: un gran salto de velocidad en el tamaño más pequeño y un ahorro real de costo solo en XLarge. Para workloads estables y saturados en la zona media del rango de tamaños, un warehouse Gen1 fijo gana este escenario.
Concurrencia: Adaptive es más rápido, el costo depende del tamaño
El objetivo: Lanzar 22 consultas en simultáneo: una herramienta de BI, un refresco de dashboard, todo un equipo consultando a la vez.
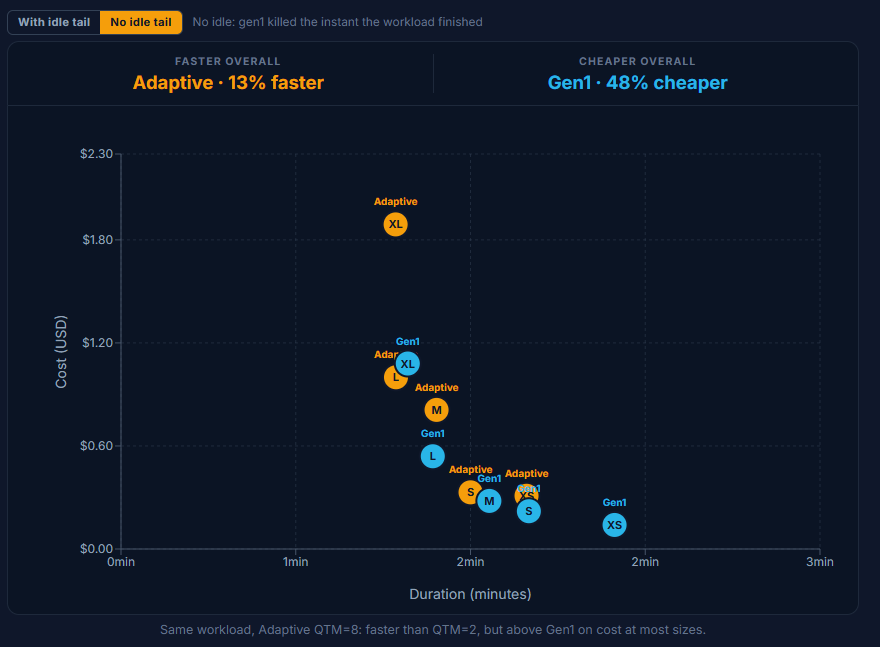
Gen1 absorbe un pico de concurrencia con escalado multi-clúster, aquí limitado a cuatro clústeres y facturado por clúster activo. Adaptive, en cambio, agrupa las consultas en cómputo compartido y usa ráfagas mediante el ajuste de QTM: un QTM más alto te da más cómputo paralelo, y más créditos. El ajuste del tramo final de inactividad solo afecta a Gen1: apagar el warehouse apenas termina la ráfaga ("sin tramo inactivo") recorta su factura entre $0.10 y $0.20 por tamaño; Adaptive no tiene concepto de inactividad y no se ve afectado.
Con QTM=2, Adaptive despeja la ráfaga más rápido que Gen1 en todos los tamaños. En costo, el resultado es mixto: Adaptive es más barato en el extremo pequeño (XSmall $0.17 vs $0.23, Small $0.23 vs $0.34) y de nuevo en XLarge ($0.83 vs $1.26), mientras que el modelo multi-clúster de Gen1 es la vía más barata en la zona media (Medium $0.39 vs $0.54, Large $0.69 vs $0.84).
Subir a QTM=8 es aún más rápido, pero lo pagas: queda por encima de Gen1 en la mayoría de los tamaños (Medium $0.81 vs $0.39, XLarge $1.89 vs $1.26) y solo empata en Small. QTM=8 se justifica únicamente cuando la latencia claramente pesa más que la factura. (Lo más probable es que la cola se despejara más rápido y solo tuviéramos que esperar a que terminara la consulta más lenta.)
Gráfico: 22 consultas concurrentes, Adaptive QTM=2 vs Gen1 multi-clúster (máx. 4).
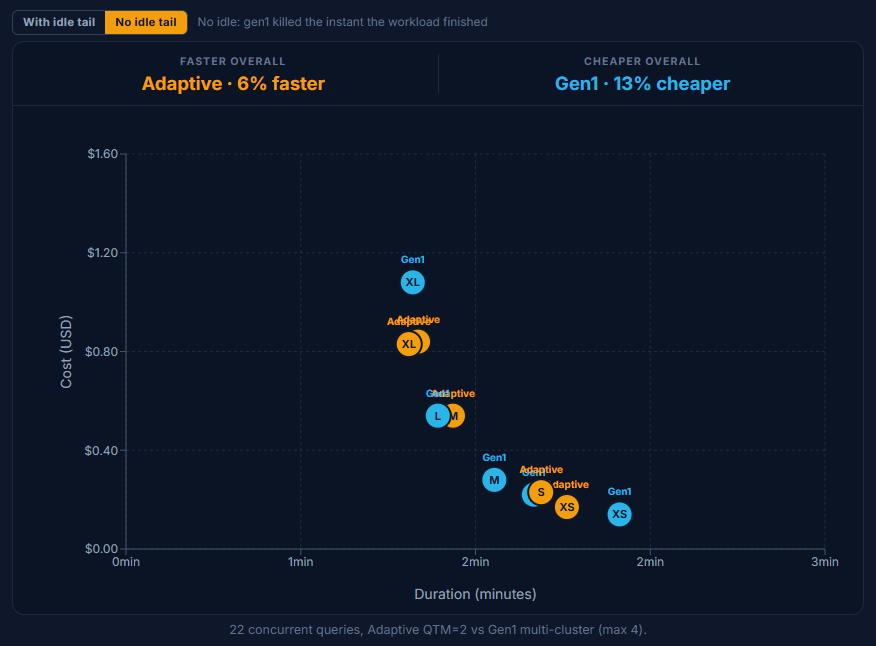
Gráfico: El mismo workload, Adaptive QTM=8, más rápido que QTM=2 pero por encima de Gen1 en costo en la mayoría de los tamaños.
💡Conclusión
Para concurrencia, Adaptive es el motor más rápido en todos los tamaños. El problema está en el ajuste de QTM. Pasar de QTM=2 a QTM=8 apenas gana unos segundos (Medium de 84 s a 81 s, XLarge de 73 s a 71 s) mientras la factura más o menos se duplica (Medium de $0.54 a $0.81, XLarge de $0.83 a $1.89). Configuramos el QTM demasiado alto para este workload: Snowflake no necesitaba ese margen para despejar la ráfaga, pero igual nos cobró por reservarlo. Configura un QTM alto solo cuando lo necesites.
Un refresco DML: el trabajo de escritura de ETL
El objetivo: Un refresco de delete + insert que imita un trabajo incremental típico.
El trabajo aquí es un refresco incremental realista: borrar un mes de lineitem y reinsertarlo desde el origen, cerca del 1% de las filas de una tabla de ~600 M de filas. La tabla base es grande, pero el cambio no. El pruning de micro-particiones de Snowflake apunta exactamente a las particiones que ese mes toca y se salta el resto, así que el motor puede ver de entrada que se trata de una escritura pequeña y quirúrgica, no de una reescritura de tabla completa. Esa es la clave de todo lo que sigue.
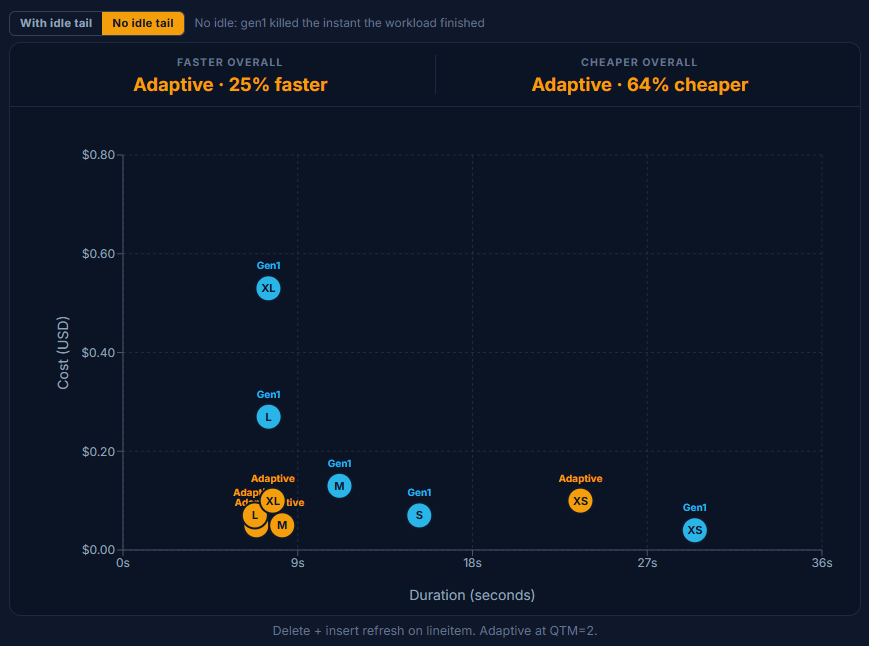
Gen1 te obliga a comprometerte con un tamaño de antemano y lo factura contra el mínimo, haya necesitado la ráfaga ese tamaño o no. El delete más insert termina en segundos desde Small en adelante, pero el precio de Gen1 sube escalón por escalón con el ajuste: $0.05 en XSmall, $0.08 en Small, $0.15 en Medium, $0.29 en Large, $0.60 en XLarge. Estás pagando por el warehouse, no por el trabajo.
Adaptive cuenta la historia opuesta, y este es el capítulo donde luce más inteligente. Fíjate en lo juntos que quedan Small, Medium, Large y XLarge: $0.05, $0.05, $0.07, $0.09. Incluso llegan en un orden de precios limpio y, aun así, para XLarge el medidor apenas se movió respecto de Small. Un delete más insert se reduce, gracias al pruning, a una franja estrecha de particiones, y claramente Snowflake reconoce que puede terminar el trabajo sin dedicarle cómputo costoso; se niega a sobreaprovisionar incluso cuando el tope de tamaño se lo permitiría. La factura sigue al trabajo, no al ajuste.
La única excepción es XSmall, donde Adaptive ($0.10) queda detrás de Gen1 ($0.05). Sin un warehouse inactivo sobredimensionado que recuperar, la prima por consulta de Adaptive no tiene con qué compensarse, exactamente el patrón del Capítulo 2.
Gráfico: refresco de delete + insert sobre lineitem. Adaptive con QTM=2.
💡Conclusión
Aquí es donde Adaptive muestra su mejor cara. Interpreta la forma del trabajo —una escritura del 1% bien podada contra una tabla enorme— y deliberadamente se mantiene pequeño en lugar de aprovechar el tope de tamaño que le diste. Incluso cuando lo apuntas a XLarge, gasta como un Small porque eso es todo lo que el trabajo necesita, así que la factura sigue a los recursos usados, no al ajuste que configuraste. Para pipelines incrementales, este es exactamente el comportamiento que quieres, y elimina por completo el impuesto de "adivinar el tamaño".
La facturación de Snowflake se está volviendo más compleja, no menos. Si además gestionas workloads de IA y ML encima, la superficie de costos se vuelve cada vez más difícil de interpretar. Preparamos una guía práctica sobre cómo controlar de verdad el gasto en Cortex, el serving de modelos y el resto del stack.
Descarga el Manual No Oficial de Optimización de Costos de IA para Snowflake
CTAS: una escritura pesada, limitada por escaneo
El objetivo: CREATE TABLE AS SELECT en cinco formas de datos: una lectura grande que alimenta la materialización completa de una tabla.
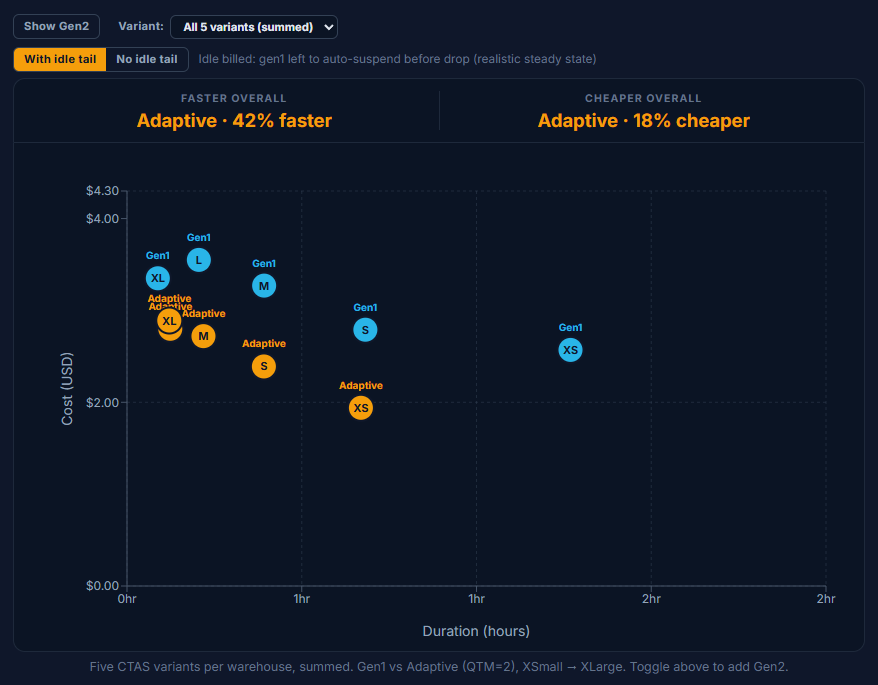
Donde el refresco DML era una escritura quirúrgica del 1%, CTAS es lo contrario: cinco variantes de CREATE TABLE AS SELECT (estrecha/alta, estándar/alta, media/ancha, muy ancha y una forma filtrada) que escanean y materializan a granel. No hay warehouse inactivo que recuperar ni atajo de pruning, así que el trabajo es cómputo genuino: el lugar más limpio para leer el precio bruto por throughput en las tres generaciones de warehouse, lado a lado.
En costo, Adaptive es la opción más barata en todos los tamaños: $1.94 / $2.39 / $2.72 / $2.80 / $2.89 de XSmall a XLarge, muy por debajo de los $2.57 / $2.79 / $3.27 / $3.55 / $3.35 de Gen1. En velocidad, Adaptive también supera a Gen1 de XSmall a Large, pero el orden se invierte en XLarge.
Ese vuelco en XLarge es culpa de una sola variante. Adaptive en XLarge termina en 7.3 minutos, más lento que los 5.3 minutos de Gen1, porque la variante very_wide deja de escalar en Adaptive: unos 6 minutos por sí sola en XLarge, mientras las otras cuatro variantes terminan en segundos. Usa el filtro de variantes de arriba para descartarla (o profundiza en una sola variante) y la anomalía desaparece.
💡 Conclusión
Adaptive es la opción más barata de XSmall a XLarge, y también la más rápida de XSmall a Large. El problema está en XLarge, donde una variante (very_wide) rompe el escalado de Adaptive y en el gráfico queda más lento que Gen1. Usa el filtro de variantes de arriba para excluirla o profundiza en una sola forma de consulta, y activa Gen2 para ver cómo se compara el warehouse estándar más nuevo.
Frequently asked
questions
Ponte en marcha en menos de 15 minutos
Conecta tu cuenta de Snowflake, Databricks o BigQuery y descubre al instante tu potencial de ahorro.
Adaptive no es una reducción de costos automática. Esta es la conclusión más importante de este benchmark, y va en contra de lo que muchos clientes con los que hablamos esperaban de la función antes de probarla. En nuestras cinco formas de workload, Adaptive fue más barato en algunos escenarios, más caro en otros y aproximadamente parejo en el resto. No recomendamos a ningún cliente cambiar de golpe todos sus warehouses a Adaptive esperando que la factura baje: en realidad, lo más probable es que subiera. Adaptive está optimizado para rendimiento, no para costo. Este es el hilo conductor de la mayoría de los experimentos que corrimos. Dado un tope de tamaño o un ajuste de QTM, Snowflake en general alcanzará el techo que le concedas para devolver la respuesta más rápida posible. El Capítulo 1 lo mostró con MAX_QUERY_PERFORMANCE_LEVEL: XLarge costando ~4x frente al ajuste Small por una mejora que apenas se podía medir. El Capítulo 3 lo mostró con el QTM: pasar de QTM=2 a QTM=8 ganó unos segundos y más o menos duplicó la factura. La excepción clara es el refresco DML del Capítulo 4, donde Adaptive interpretó la forma de una escritura del 1% bien podada y deliberadamente se mantuvo pequeño incluso apuntado a XLarge. Así que el motor puede contenerse; simplemente no lo hace de forma consistente en todas las formas de workload. La conclusión no es que Adaptive sea imprudente, sino que los ajustes aún necesitan afinarse y configurarse con cuidado.
Todavía tienes que pensar en la configuración de tu warehouse. La promesa de Adaptive era que las decisiones de tamaño desaparecían. En la práctica, este benchmark muestra que las decisiones solo cambiaron de forma: en lugar de elegir un tamaño fijo, ahora eliges un MAX_QUERY_PERFORMANCE_LEVEL (un techo de gasto) y un QTM (un techo de concurrencia/ráfaga). Ambos cambian la factura de forma material. Configúralos demasiado alto "por si acaso" y pagarás por un margen que nunca necesitaste.
Debes hacer benchmarks de tus propios workloads. Nuestros resultados son específicos de TPC-H SF1000 y de las cinco formas de workload que corrimos. Tus consultas, el diseño de tus datos, el comportamiento del pruning, el perfil de concurrencia y los patrones de inactividad producirán números distintos. Los hallazgos direccionales sirven como hipótesis inicial; no sustituyen probar Adaptive contra tu workload real sobre tus datos reales. El repo del benchmark es reproducible: haz un fork, incluye tus propias consultas y mide antes de migrar cualquier cosa que importe.
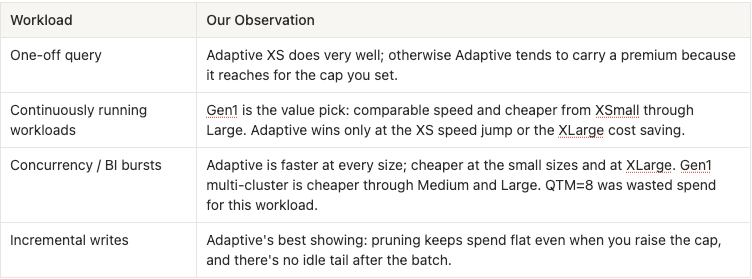
Dicho esto, estas son las observaciones que vimos al hacer benchmarks de nuestros propios workloads:
¿Ya hiciste benchmarks de Adaptive con tus propios workloads? ¡Nos encantaría saber qué viste! Escríbenos: siempre buscamos afinar nuestra comprensión de cómo se comporta en el mundo real.